98%のコスト減で経済性を向上
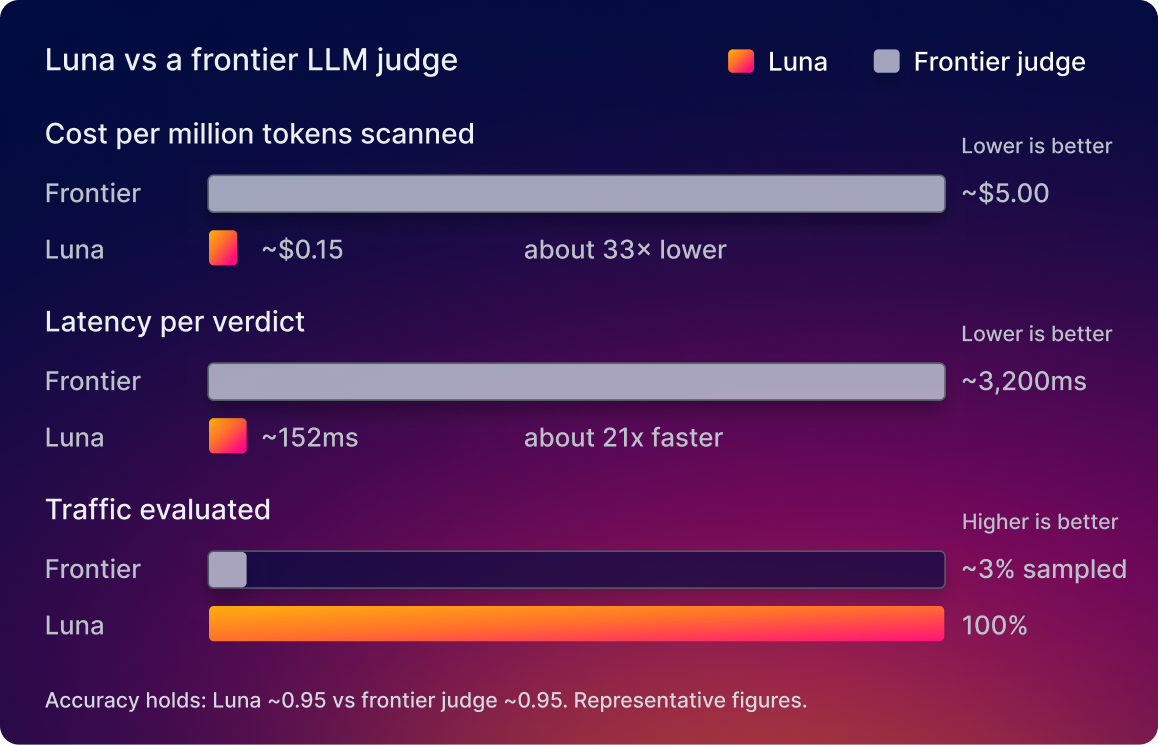
100万トークンあたりの評価コストが5ドルから約0.15ドルに下がれば、対象を絞り込む必要はなくなります。サンプリングすることなく、すべてのインタラクションを評価して保護できます。

評価に特化した小規模言語モデルで、すべてのインタラクションを評価してガードレールを適用し、100%のトラフィックを低コストで監視できます。
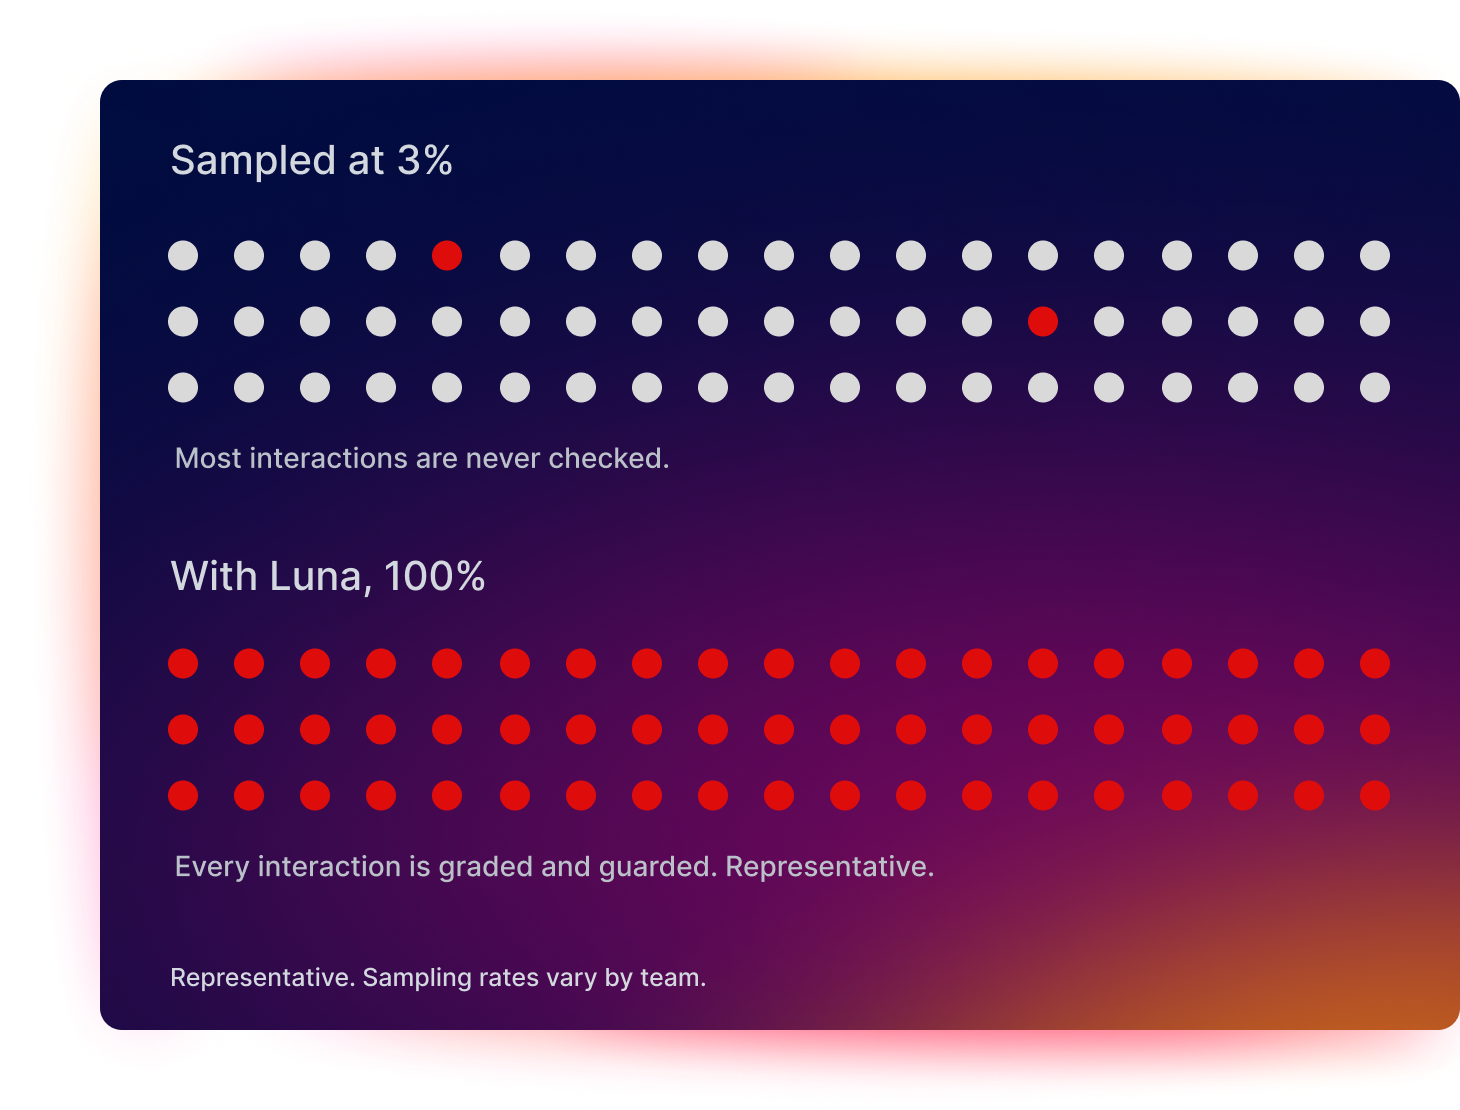
フロンティアLLMを使った評価では、対象となる100万トークンあたりのコストが約5ドルにのぼることがあります。本番環境の規模を考えると、すべてのインタラクションを評価するのは費用がかかり過ぎます。そのため、1~5%のみをチェックして、他のインタラクションも同じような結果であるよう願うことになります。しかし、気付かなかったハルシネーションや、検出漏れのインジェクションなど、見逃したものこそ被害をもたらします。
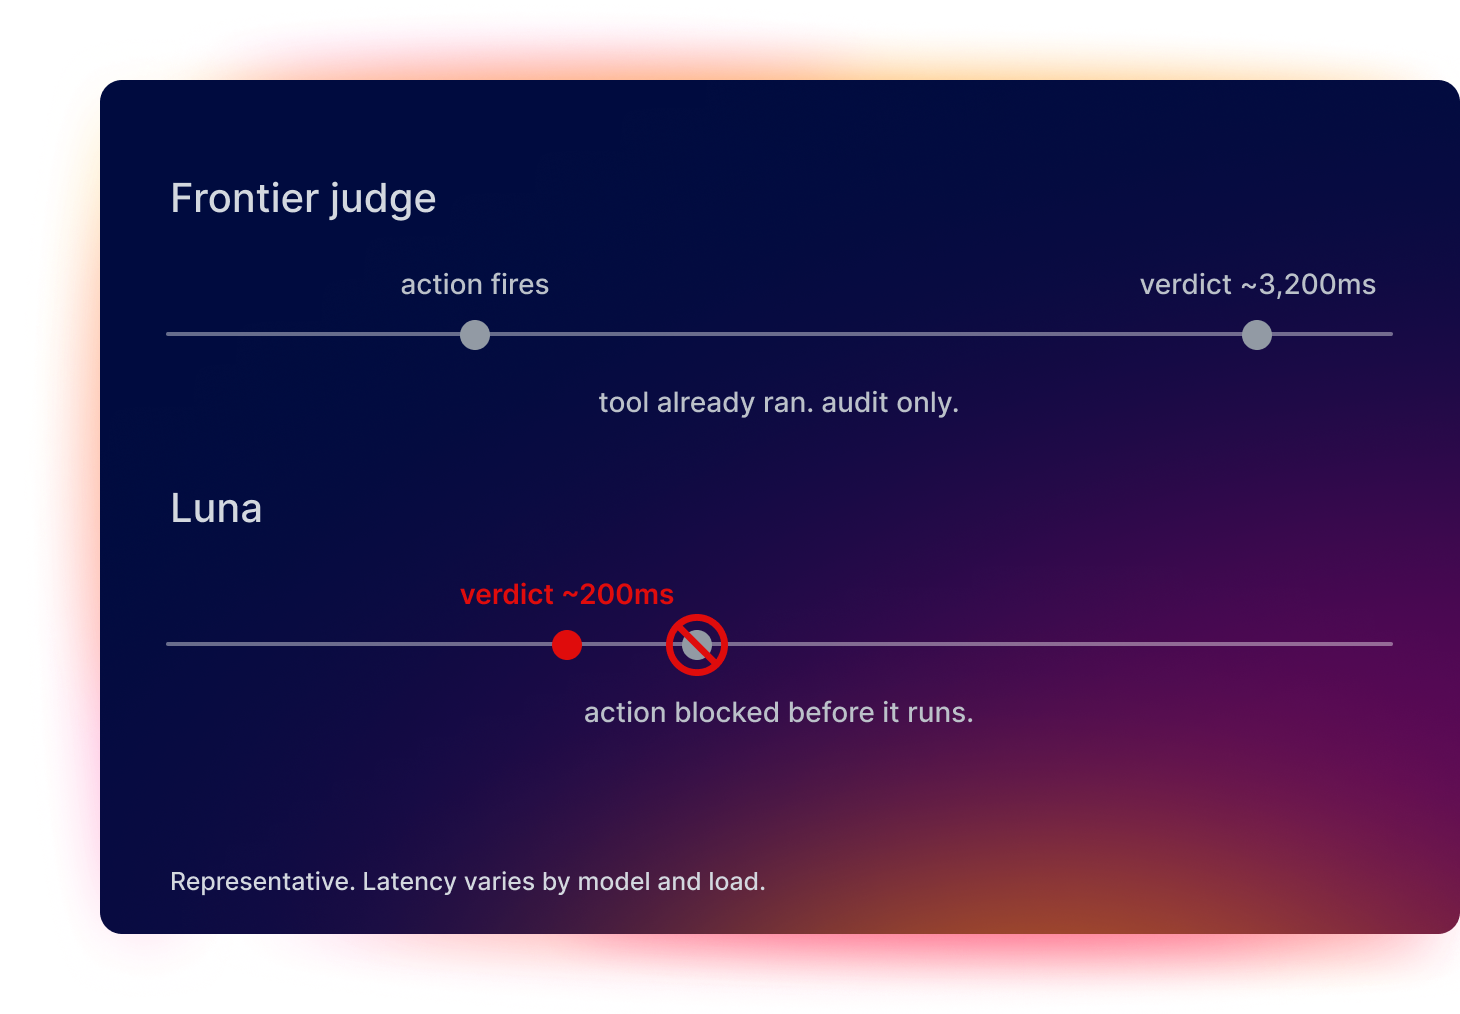
フロンティアLLMを使った評価では、判定が返されるまでに約3,200ミリ秒かかります。それまでにはツールで処理が実行されてしまうため、判定が示すのはもはや過去の出来事です。これでは監査はできますが、保護はできません。Lunaでは約152ミリ秒で判定が返されるため、ツールで処理が実行される前にアクションを止めることができます。
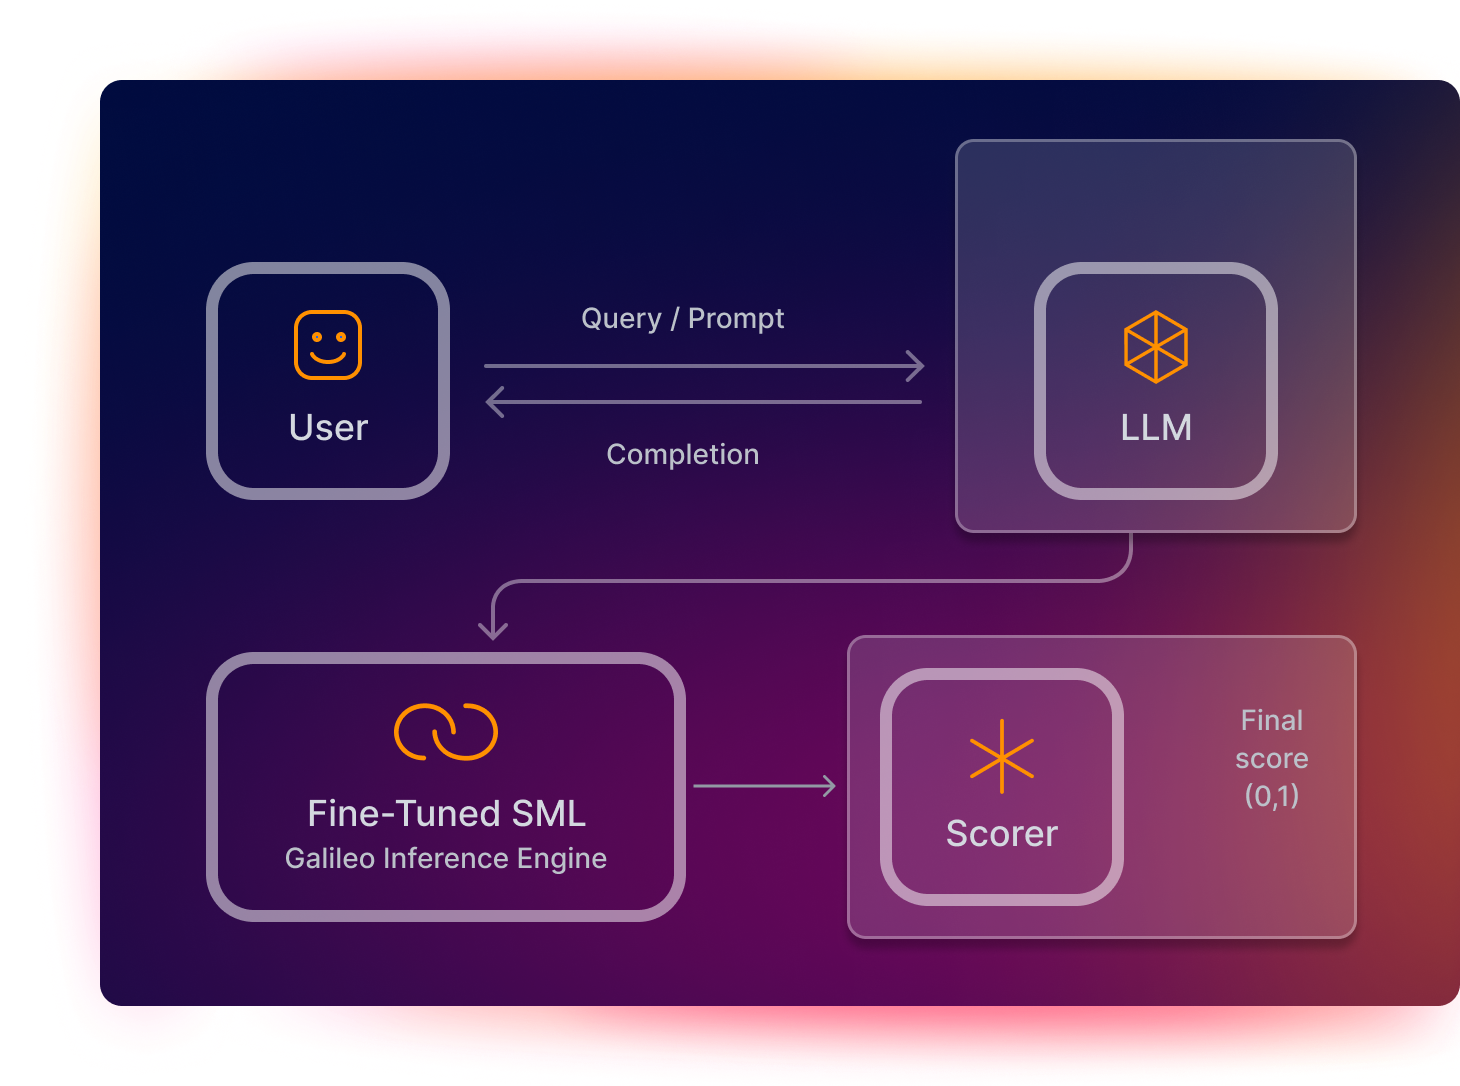
Lunaでは、判定が単一のトークンとして返されるため、スコアリングが高速で、再現性も高くなります。同じ入力を2回実行しても同じ答えが返されるので、評価の信頼性を確保できます。また、Lunaは組織のVPC内で実行およびトレーニングされるため、データがファイアウォールの外に出ることはありません。
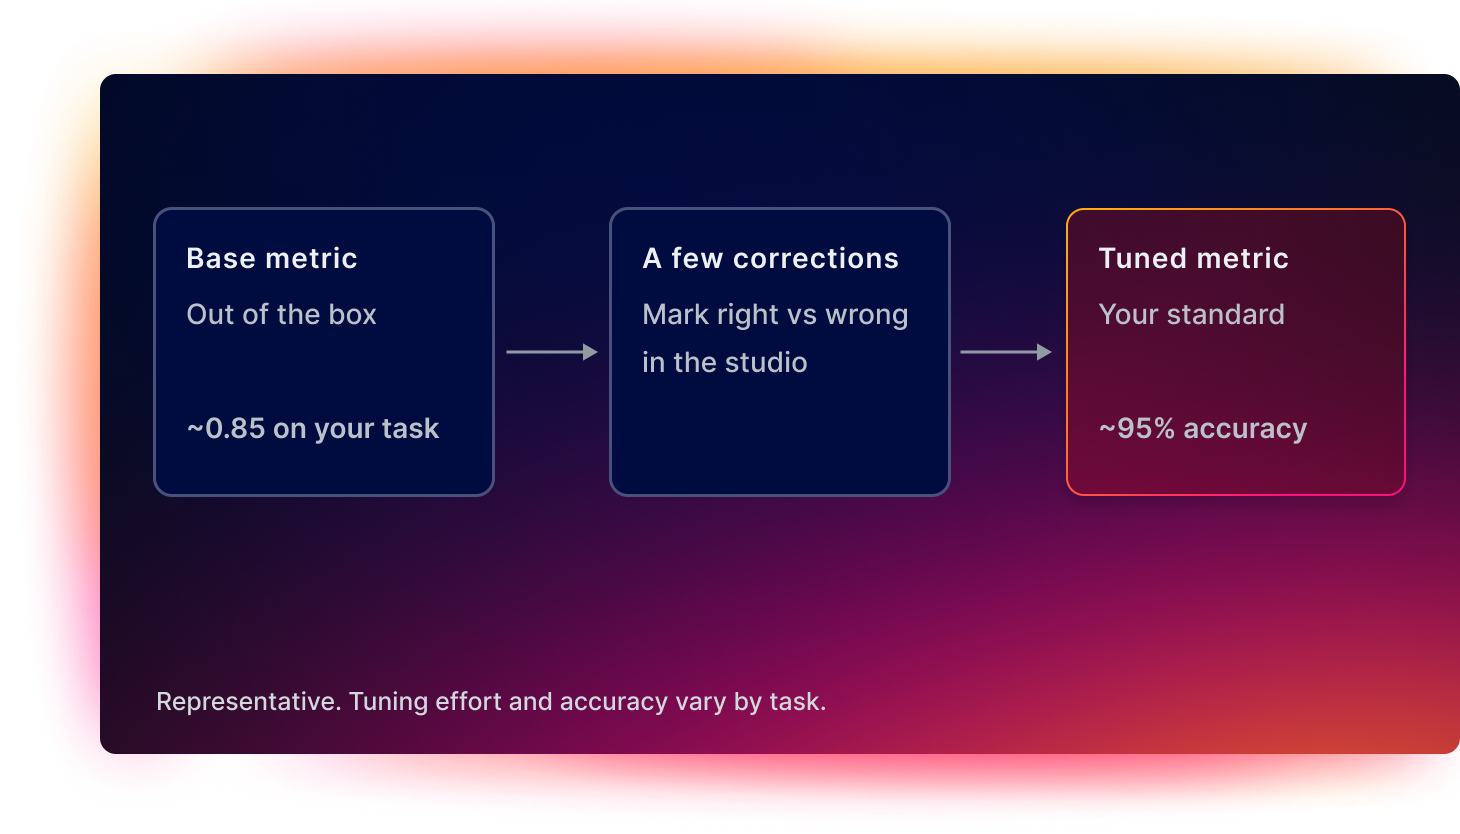
Lunaでは、標準で用意されたメトリクスで始めることができます。しかし、組織のドメインには独自の判断基準があるでしょう。Luna Studioを使用すれば、Lunaによる判定を少量修正するだけで、基準が学習され、組織のタスクでの精度が95%前後まで向上します。ラベル付けのためのパイプラインも、モデルのトレーニングに関する専門知識も不要です。Luna Studioで判定をレビューし、修正して、チューニングされたメトリクスを適用するだけです。
特長

大規模言語モデルを使用した場合に発生するコストやレイテンシーを回避して、評価を常時実行。Luna-2のファインチューニング済みSLMでは、100万トークンあたりのコストをセント単位に抑えながら、判定をミリ秒単位で得て、本番環境での大規模な評価を実現できます。
エージェンティックワークフローでミスがアクションに影響を及ぼす前にガードレールを適用。Luna-2でツールの選択やエージェントの処理フローをリアルタイムで評価して、問題を発生後に検出するのではなく、リスクの高いアクションをツールの実行前に捕捉できます。


レイテンシーを秒単位で引き延ばすことなく、エージェントの挙動を複数のディメンションで同時に評価。Luna-2では、L4 GPU上で10~20種類のチェックを200ミリ秒以下で同時に実行できるため、ガードレールをリアルタイムで大規模に適用できます。

フロンティアLLMですべてのインタラクションを評価して多大なコストをかけることなく、本番環境レベルの評価を実現。Luna-2では、評価コストを100万トークンあたり0.12ドルに抑えながら、高い精度と低レイテンシーを維持できます。

最終的な応答以外も測定。Luna-2では、ツールのエラー、ツール選択の品質、アクションの進捗、アクションの完了状況を評価して、エージェントが適切に動作し、ユーザーの目標を達成しているかどうかを確認できます。

それぞれのAIアプリケーションに固有の挙動を評価。Luna-2では、本番環境でのユースケースに合わせてカスタムLLMメトリクスを作成できるとともに、軽量のアダプターによってインフラの負荷を最小限に抑えながら、1つのベースモデルを数百のメトリクスに対応させることができます。
Lunaは、評価に特化した小規模言語モデルのファミリーです。エージェントのインタラクションを低コストで高速に評価して保護できるため、費用を心配してデータをサンプリングすることなく、トラフィックを100%監視できます。
フロンティアLLMによる評価は高コストで、レイテンシーも大きくなります。そのため、トラフィックの1~5%をサンプリングすることになり、アクションをレビューできるのも実行後になってしまいます。一方、Lunaは、エージェントのインタラクションを評価するという1つのジョブのためだけに構築されているため、コストが低く処理も高速で、すべてのインタラクションをリアルタイムで評価して保護できます。
Lunaで評価とガードレール適用にかかるコストは、LLM-as-a-judgeアプローチと比べて約98%低くなります。この経済性によって、対象を絞り込むことなくすべてのインタラクションを評価できます。
はい。Lunaでは判定が単一のトークンとして返されるため、スコアは決定論的です。同じ入力を2回実行しても同じ答えが返されるので、評価の信頼性を確保できます。
はい。Luna Studioを使用すれば、判定を少量修正するだけで、基準が学習され、組織のタスクでの精度が95%前後まで向上します。ラベル付けのためのパイプラインも、モデルのトレーニングに関する専門知識も不要です。
© 2005 - 2026 Splunk LLC 無断複写・転載を禁じます。