splunk background

Luna

Luna-Bewertungsmodelle

Zweckspezifische kleine Sprachmodelle, die jede Interaktion bewerten und kontrollieren – damit Sie kostengünstig 100 % des Traffics prüfen können.

Free Edition 14 Tage lang kostenlos und unverbindlich testen – keine Kreditkarte erforderlich.
Produkt-Tour starten 5 Minuten Zeit? Jetzt die wichtigsten Funktionen kennenlernen.
Luna-Bewertungsmodelle
bg-image

98 % günstiger. Ein neuer Blick auf Wirtschaftlichkeit.

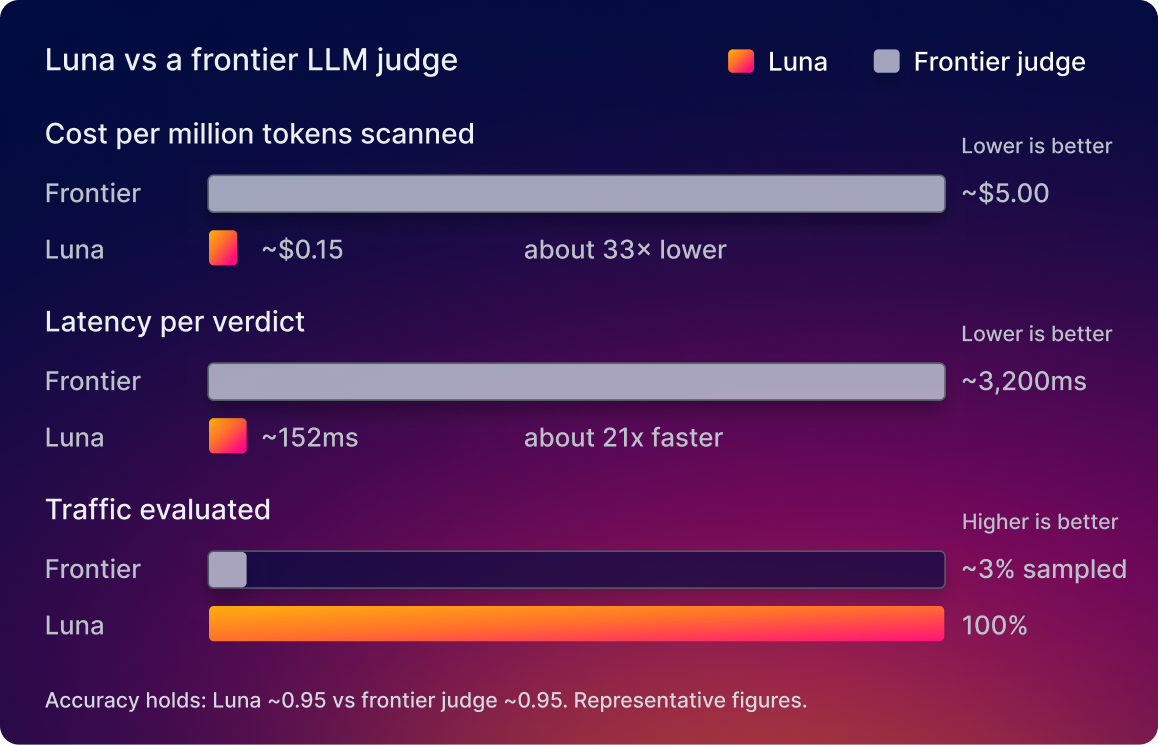
Wenn eine Bewertung statt 5,00 $ nur noch etwa 0,15 $ pro Million Token kostet, muss man sich nicht mehr einschränken. Man kann dann jede Agenteninteraktion bewerten und kontrollieren – nicht nur Stichproben.
bg-image

Der Preis für „LLM-as-Judge“

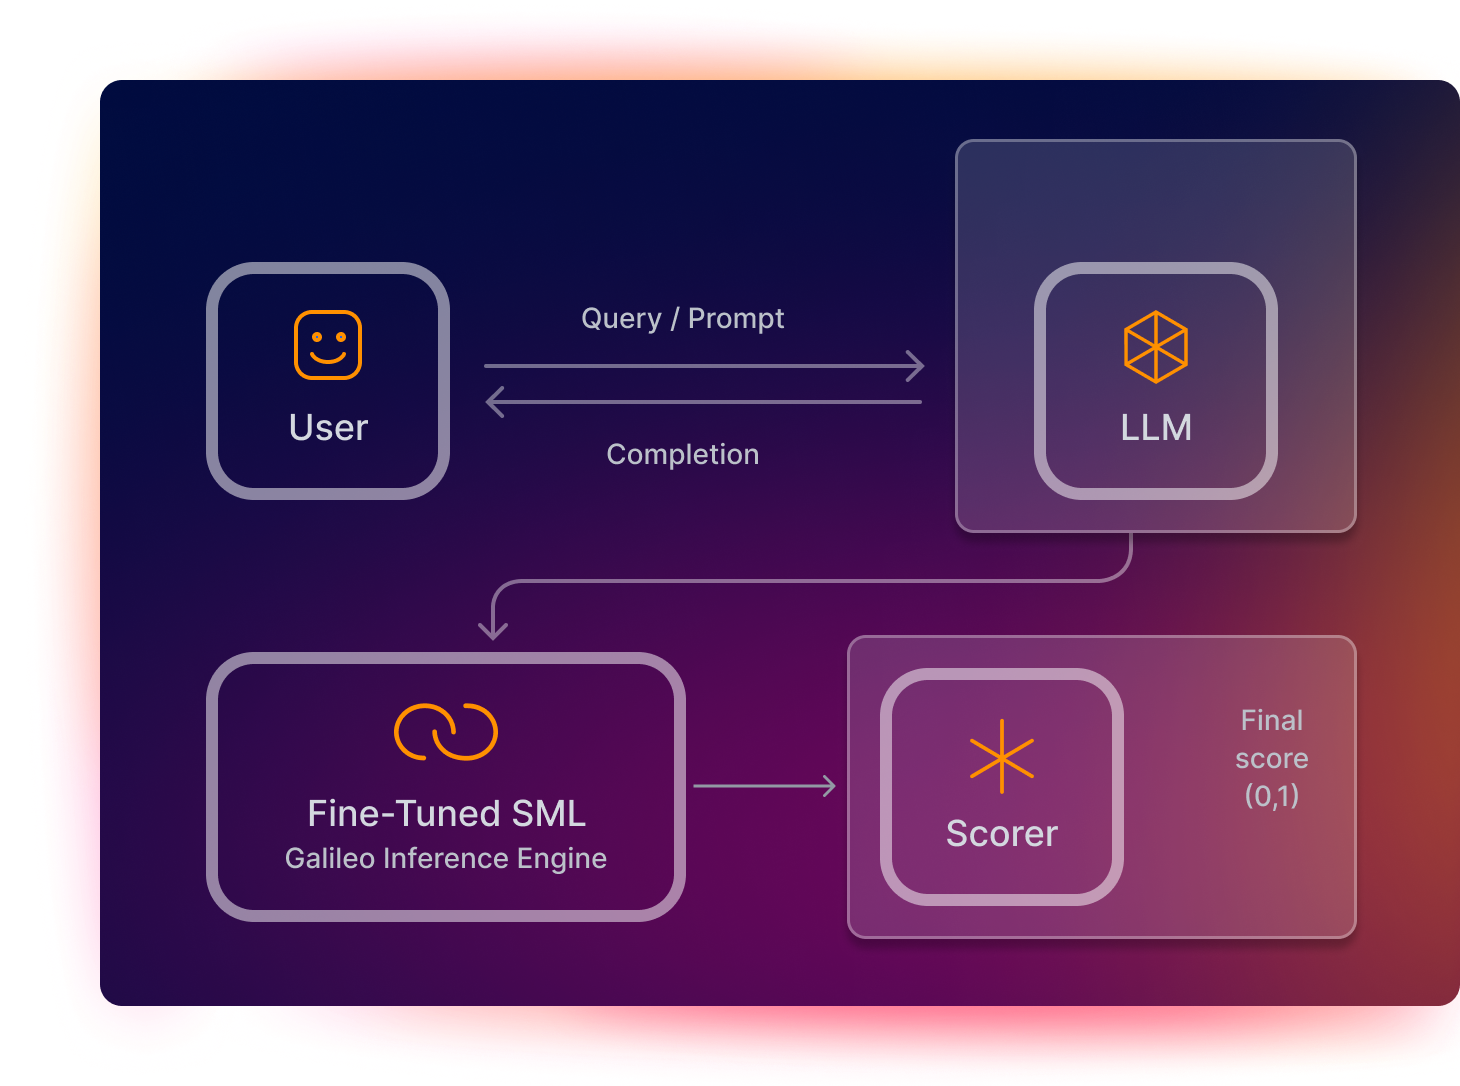
Luna wurde für eine einzige Aufgabe entwickelt: die Bewertung von Agenteninteraktionen. Dank dieser klaren Ausrichtung kann das System 100 % des Datenverkehrs in Echtzeit bewerten und kontrollieren, wo ein Frontier-Modell als Judge zu teuer und zu langsam wäre.

Zu teuer, um alles zu bewerten

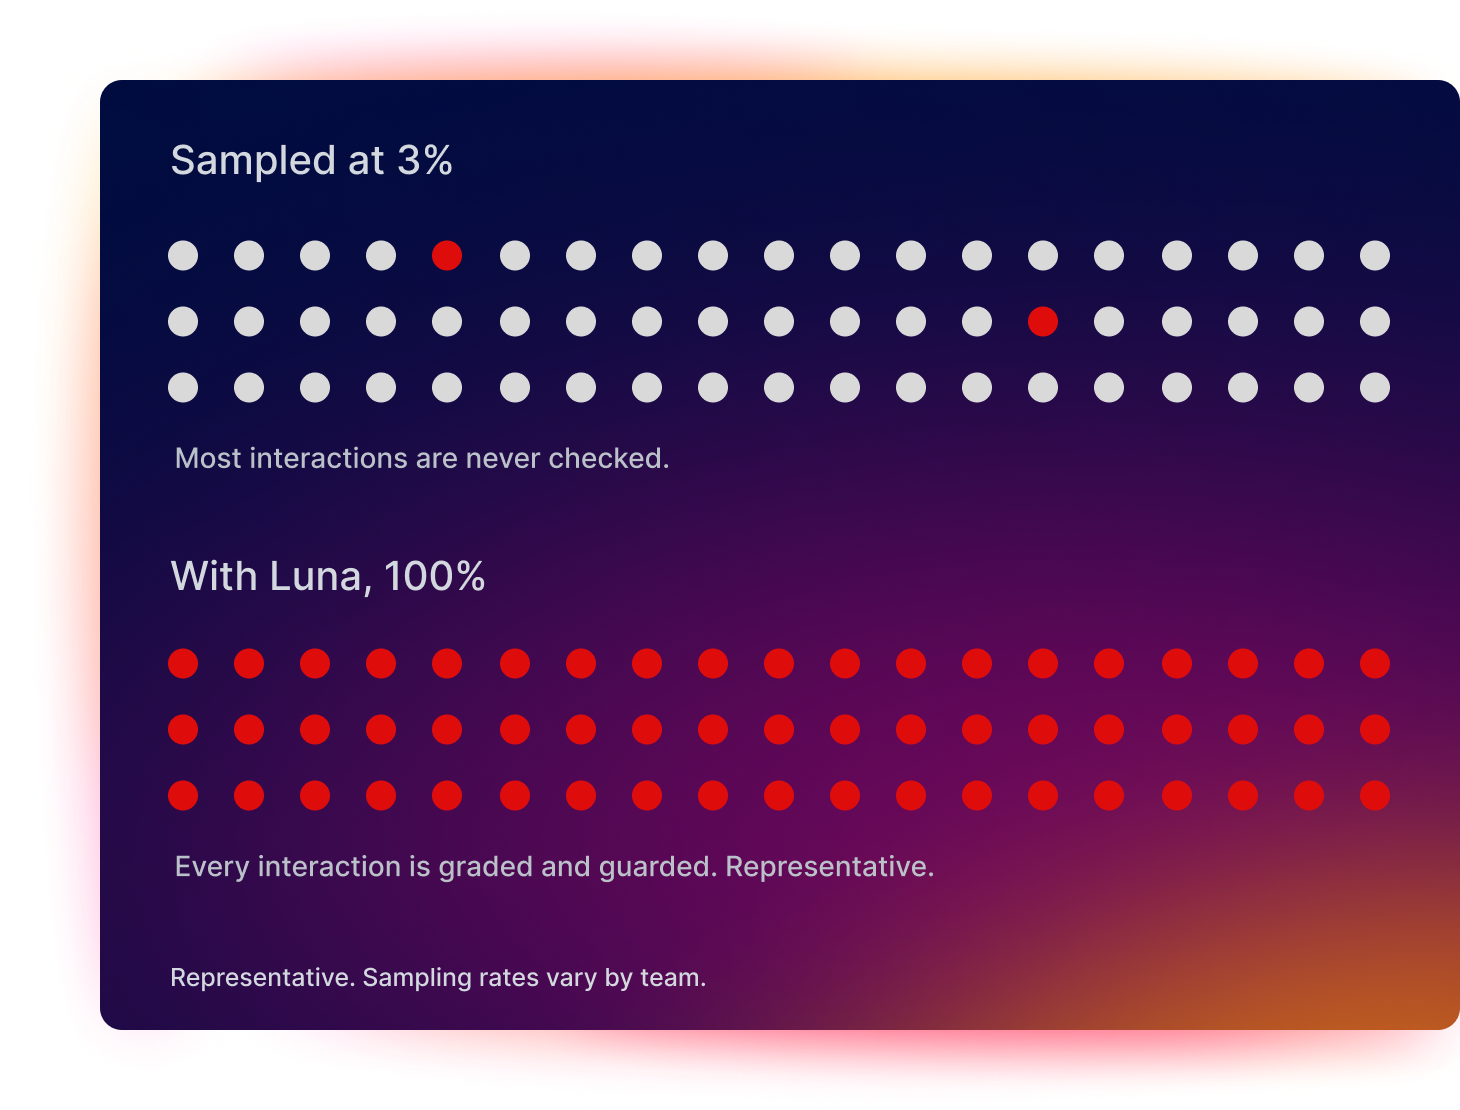
Ein Frontier-Modell als Judge kostet etwa 5,00 $ pro Million gescannter Token. Da dies angesichts der Datenvolumen von Produktionsagenten zu teuer ist, um alles zu bewerten, lassen Teams nur 1 bis 5 % der Interaktionen prüfen und hoffen, dass sich der Rest genauso verhält. Doch die Fehler, die dabei durch das Netz schlüpfen, sind genau die, die wehtun: die Halluzination, die nie bemerkt wurde, die Injektion, die durchgerutscht ist.

Zu langsam, um Abläufe noch zu stoppen

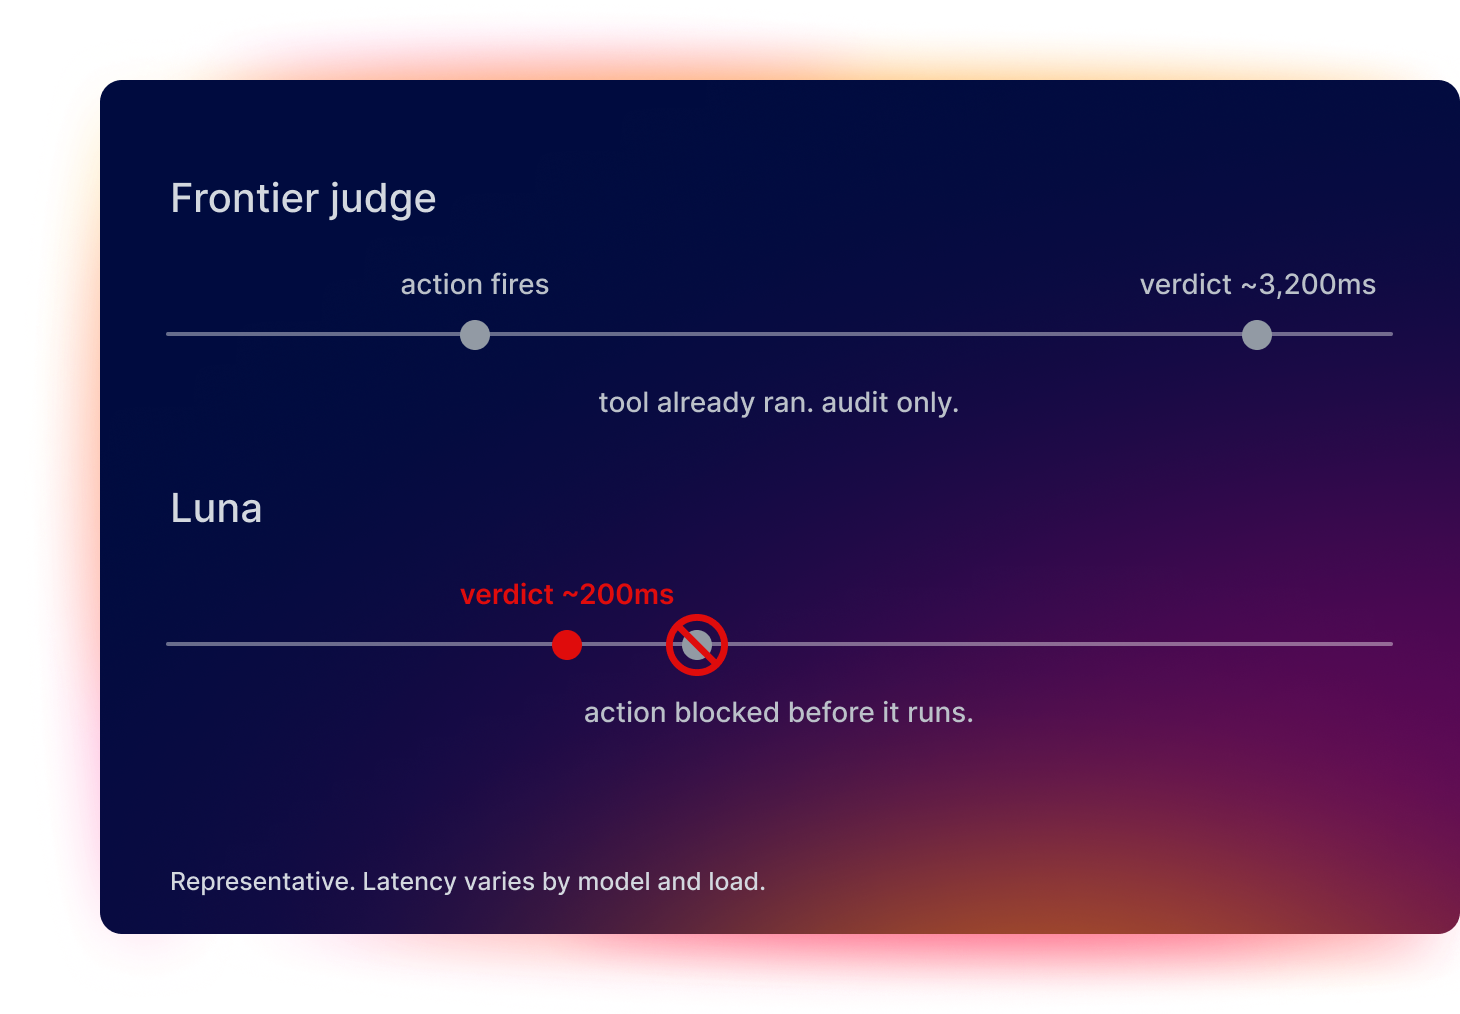
Bei einem Frontier-Judge kann es bis zu 3200 ms dauern, bis die Bewertung zurückgegeben wird. Bis dahin wurde das Tools bereits ausgeführt, sodass die Bewertung nur beschreiben kann, was passiert ist. Es wird also nur geprüft, aber nicht kontrolliert. Luna gibt die Bewertung in etwa 152 ms zurück: Das ist schnell genug, um eine Aktion zu blockieren, bevor das Tool ausgelöst wird.

Deterministische Bewertung als einzelnes Token

Luna gibt die Bewertung als einzelnes Token zurück, sodass die Ergebnisse schnell und wiederholbar sind. Wenn man eine Eingabe zweimal ausführt und zweimal dieselbe Antwort erhält, macht das ein Modell als Judge vertrauenswürdig. Und da Luna innerhalb Ihrer VPC ausgeführt und trainiert wird, bleiben Ihre Daten immer innerhalb Ihrer Firewall.

Luna bereichsspezifisch optimieren, ganz ohne Code

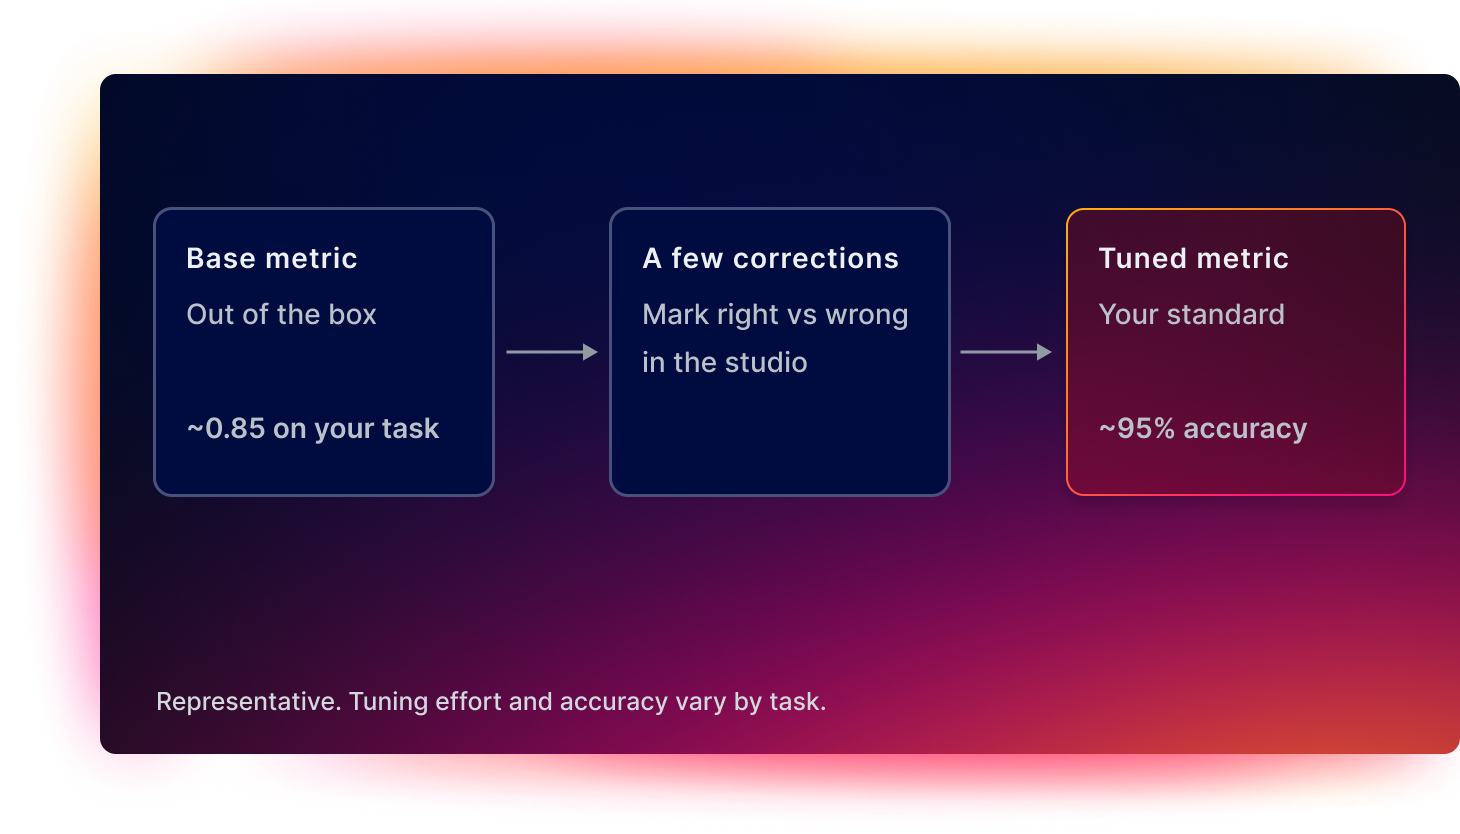
Vorkonfigurierte Metriken erleichtern Ihnen den Einstieg, aber Ihr Bereich hat seine eigene Definition davon, was richtig ist. Mit Luna Studio können Sie eine Handvoll Bewertungen von Luna korrigieren, sodass das Modell Ihren Standard lernt und dann etwa 95 % Genauigkeit bei Ihren eigenen Aufgaben erreicht. Ganz ohne Labeling-Pipeline oder Fachkenntnisse im Trainieren von Modellen. Sie können eine Metrik prüfen, korrigieren und liefern – alles von Luna Studio aus.

.Conf 26 promo image

Keynotes der .conf26 live ansehen

Sichern Sie sich einmalige Insights der klügsten Köpfe bei Splunk und führender Branchenexperten.

Jetzt streamen

Funktionen

Skalieren Sie Echtzeitbewertungen, nicht die Kosten.

Dokumentation kennenlernen
Bewerten Bewerten

Bewerten jeder Interaktion in der Produktion

Ausführen kontinuierlicher Bewertungen ohne die Kosten und Latenzen größerer Modelle. Die optimierten SLMs von Luna-2 liefern Bewertungen innerhalb von Millisekunden für nur wenige Cent pro Million Token. Dies ermöglicht Bewertungen in großem Maßstab in der Produktion.

Abfangen Abfangen

Abfangen riskanter Aktionen vor der Ausführung

Anwenden von Leitplanken für Agenten-Workflows, bevor Fehler zu Handlungen werden. Luna-2 bewertet Tool-Auswahl und Agenten-Flows in Echtzeit und erkennt riskantes Verhalten bereits vor der Ausführung der Tools, nicht erst im Nachhinein als Problem.

visibility-into-it-and-industrial-data visibility-into-it-and-industrial-data

Mehr Überprüfungen ohne Geschwindigkeitseinbußen bei Agenten

Bewerten Sie mehrere Dimensionen des Agentenverhaltens gleichzeitig ohne jegliche Verzögerung. Luna-2 kann auf L4-GPUs 10–20 Prüfungen gleichzeitig in unter 200 Millisekunden durchführen, was Echtzeit-Leitplanken in großem Maßstab ermöglicht.

Traffic Traffic

Günstigere Bewertungen auf Produktionsniveau

Bewertungen auf Produktionsniveau, ohne bei jeder Interaktion einen Frontier-LLM-Judge zu bezahlen. Luna-2 liefert Bewertungen zu 0,12 $ pro Million Token bei hoher Genauigkeit und niedriger Latenz.

priced-and-packaged-for-small-it-environments priced-and-packaged-for-small-it-environments

Wissen, ob Agenten die Aufgabe tatsächlich abschließen

Beurteilen Sie mehr als nur die letztendliche Antwort. Luna-2 bewertet Tool-Fehler, Tool-Auswahlqualität, Zielerreichung und Aktionsabschluss, so dass Sie sehen, ob Agenten Benutzerziele erfolgreich vorantreiben und erreichen.

optimize-incident-response optimize-incident-response

Skalieren für Ihre Anwendung relevanter Metriken

Bewertung spezifischer Verhaltensweisen Ihrer KI-Anwendung. Luna-2 kann benutzerdefinierte LLM-Metriken für Produktions-Use-Cases unterstützen, während schlanke Adapter einem Basismodell die Skalierung über Hunderte von Metriken mit minimalem Infrastrukturaufwand ermöglichen.


Ressourcen
Mehr von Splunk

Luna-Bewertungsmodelle – FAQs

Bei Luna handelt es sich um eine Familie zweckspezifischer kleiner Sprachmodelle für die Bewertung. Sie bewerten und kontrollieren Agenteninteraktionen schnell und kostengünstig, sodass es erschwinglich wird, den Agenten-Traffic zu 100 % zu prüfen, anstatt nur mit Stichproben.

Ein Frontier-Judge ist teuer und langsam – Teams nehmen daher Stichproben von 1 bis 5 % des Traffics und können Aktionen somit erst nach deren Ausführung überprüfen. Luna wurde für eine einzige Aufgabe entwickelt: die Bewertung von Agenteninteraktionen. Dadurch ist es kostengünstig genug, um alles zu bewerten, und schnell genug, um in Echtzeit zu kontrollieren.

Luna führt Bewertungen und die Leitplankenkontrolle zu etwa 98 % geringeren Kosten durch als ein LLM-als-Judge-Ansatz, sodass es durchaus wirtschaftlicher ist, jede Interaktion zu bewerten, statt die Ausführung auf Stichproben zu beschränken.

Ja. Luna gibt eine Bewertung als einzelnes Token zurück, die Ergebnisse sind also deterministisch. Wenn man eine Eingabe zweimal ausführt und zweimal dieselbe Antwort erhält, macht das ein Modell als Judge vertrauenswürdig.

Ja. Mit Luna Studio können Sie eine Handvoll Bewertungen von Luna korrigieren, sodass das Modell Ihren Standard lernt und dann etwa 95 % Genauigkeit bei Ihren eigenen Aufgaben erreicht – ganz ohne Labeling-Pipeline oder Fachkenntnisse im Trainieren von Modellen.

Ähnliche Produkte

Splunk Cloud Platform

Daten, Kontext und Aktionen domänenübergreifend vereinheitlichen.

Mehr erfahren

Splunk Enterprise Security

Einheitliche Bedrohungserkennung, -untersuchung und -reaktion (TDIR) für das agentenbasierte SOC.

Mehr erfahren

Splunk IT Service Intelligence

IT-Probleme mit KI-gestütztem Service-Monitoring prognostizieren und verhindern.

Mehr erfahren
Lernen Sie Luna kennen

Jede Interaktion bewerten und kontrollieren, für einen Bruchteil der Kosten.

Demo anfordern
Kostenlose Testversionen entdecken