成本降低 98%,改变成本结构
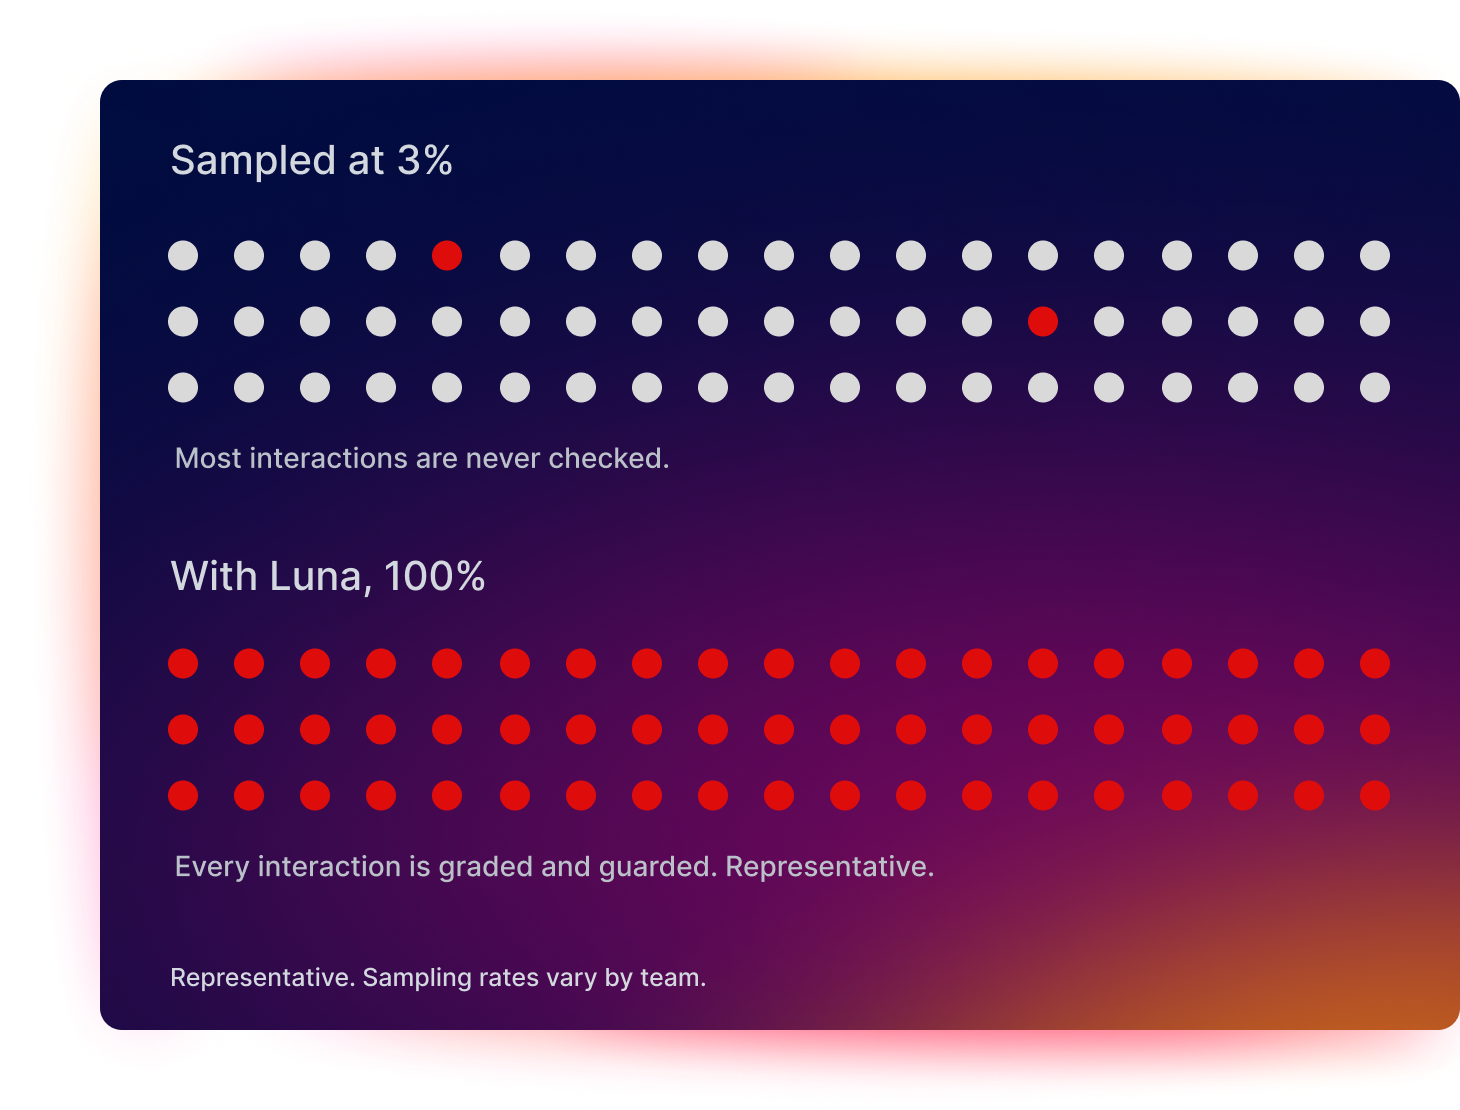
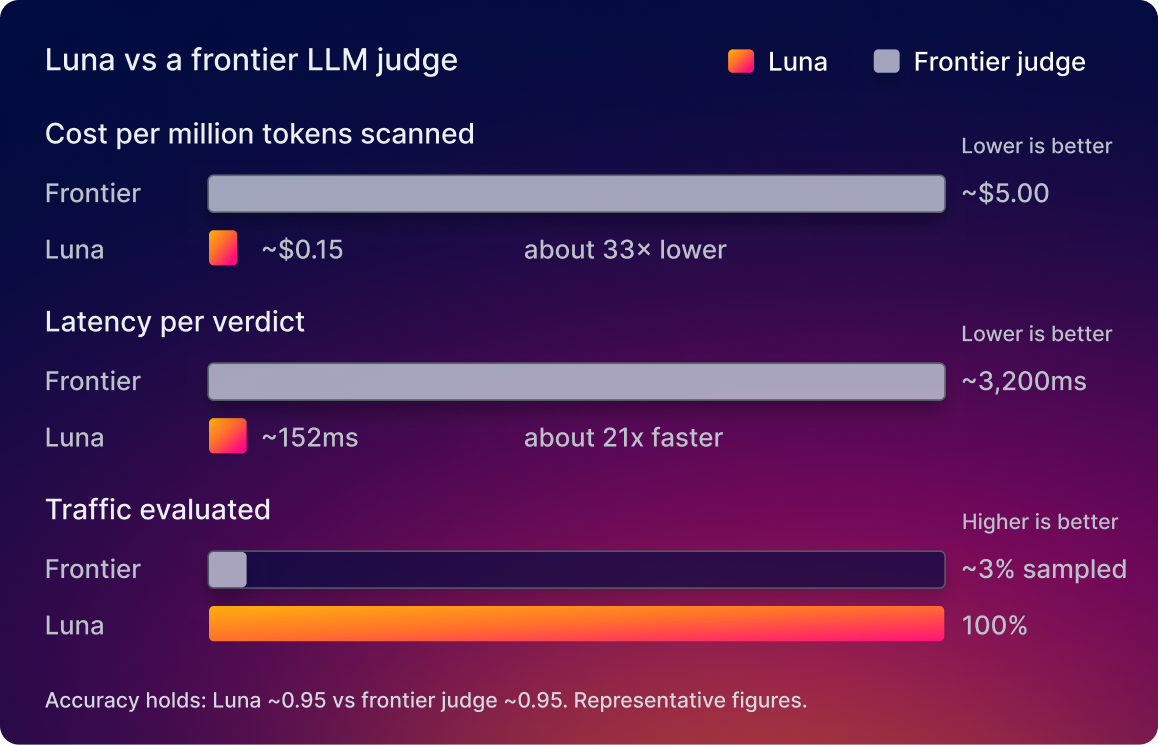
当判定成本约为每百万令牌 $0.15 而非 $5.00 时,您便无需再精打细算。对每一次交互进行评分与防护,而非仅针对抽样。

专用小语言模型,可评估并防护每一次交互,让您能够以经济高效的方式监控 100% 的流量。
前沿裁判模型每扫描 100 万个令牌的成本约为 $5.00。在生产规模下,对所有内容都运行此操作成本过高,因此团队通常只检查 1–5% 的交互,并寄希望于其余交互表现相同。被遗漏的往往才是最致命的:从未察觉的幻觉,侥幸漏掉的注入攻击。
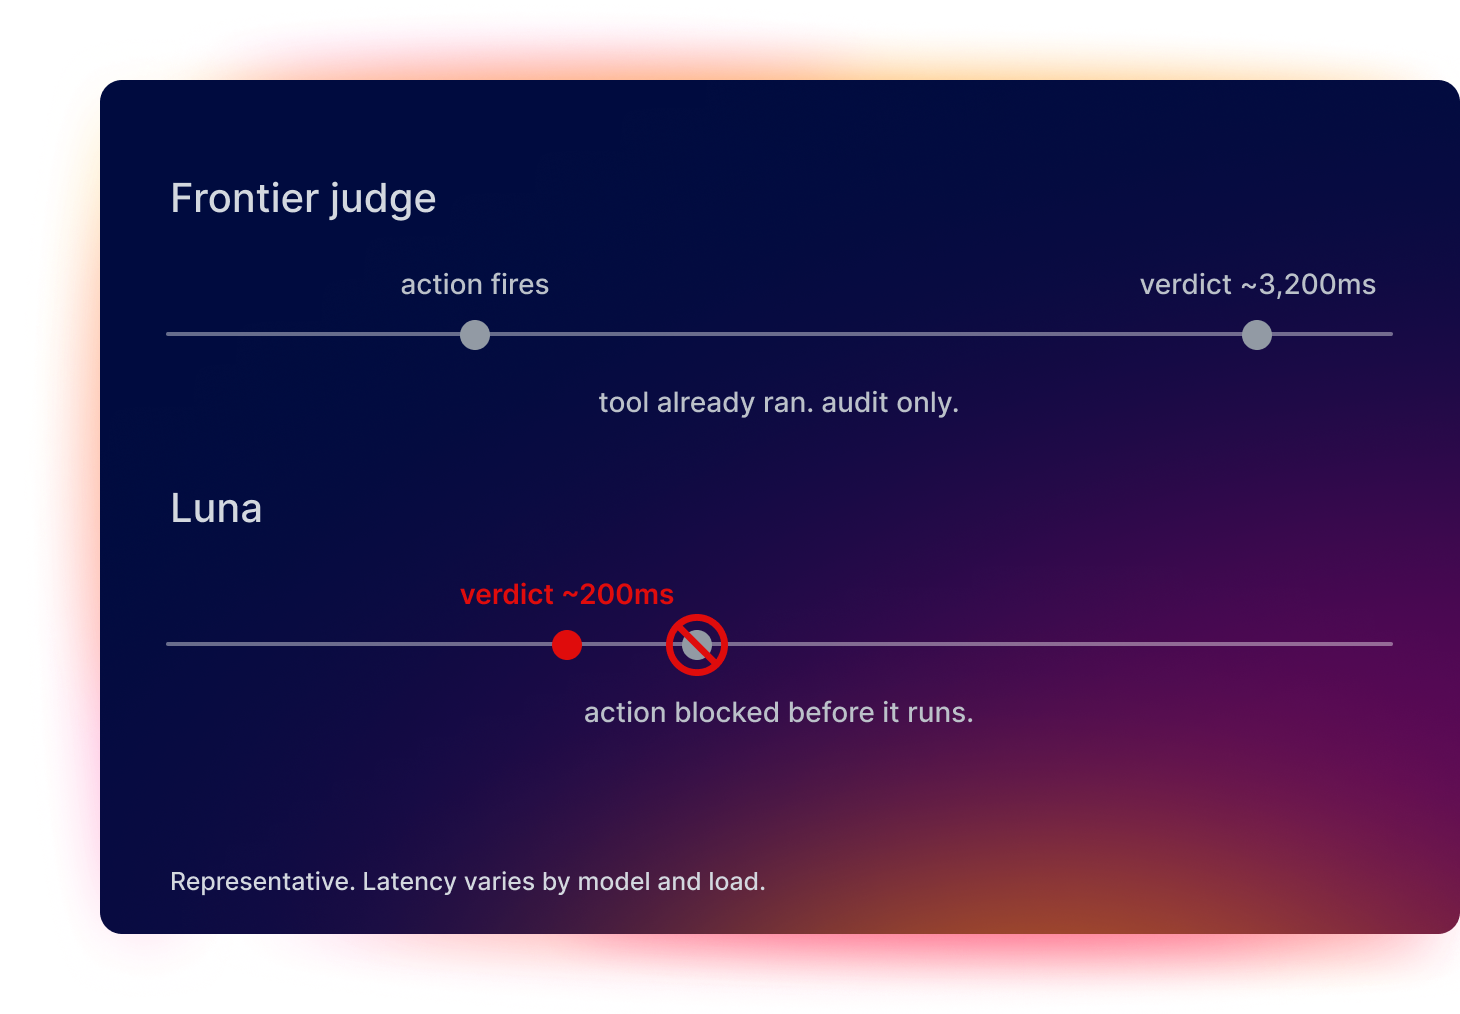
前沿评估模型返回判定结果可能需要约 3,200 ms。到那时工具已经运行,因此判定结果只能描述已发生的情况。它可以进行审计,但无法进行防护。Luna 大约只需 152 ms 即可返回判定结果,速度快到可以在工具触发前阻止操作。
Luna 以单个令牌形式返回结论,因此评分快速且可重复。运行相同的输入两次,您会得到相同的答案,这正是让模型作为评估模型值得信赖的原因。而且由于 Luna 在您的 VPC 内部运行和训练,您的数据绝不会离开您的防火墙。
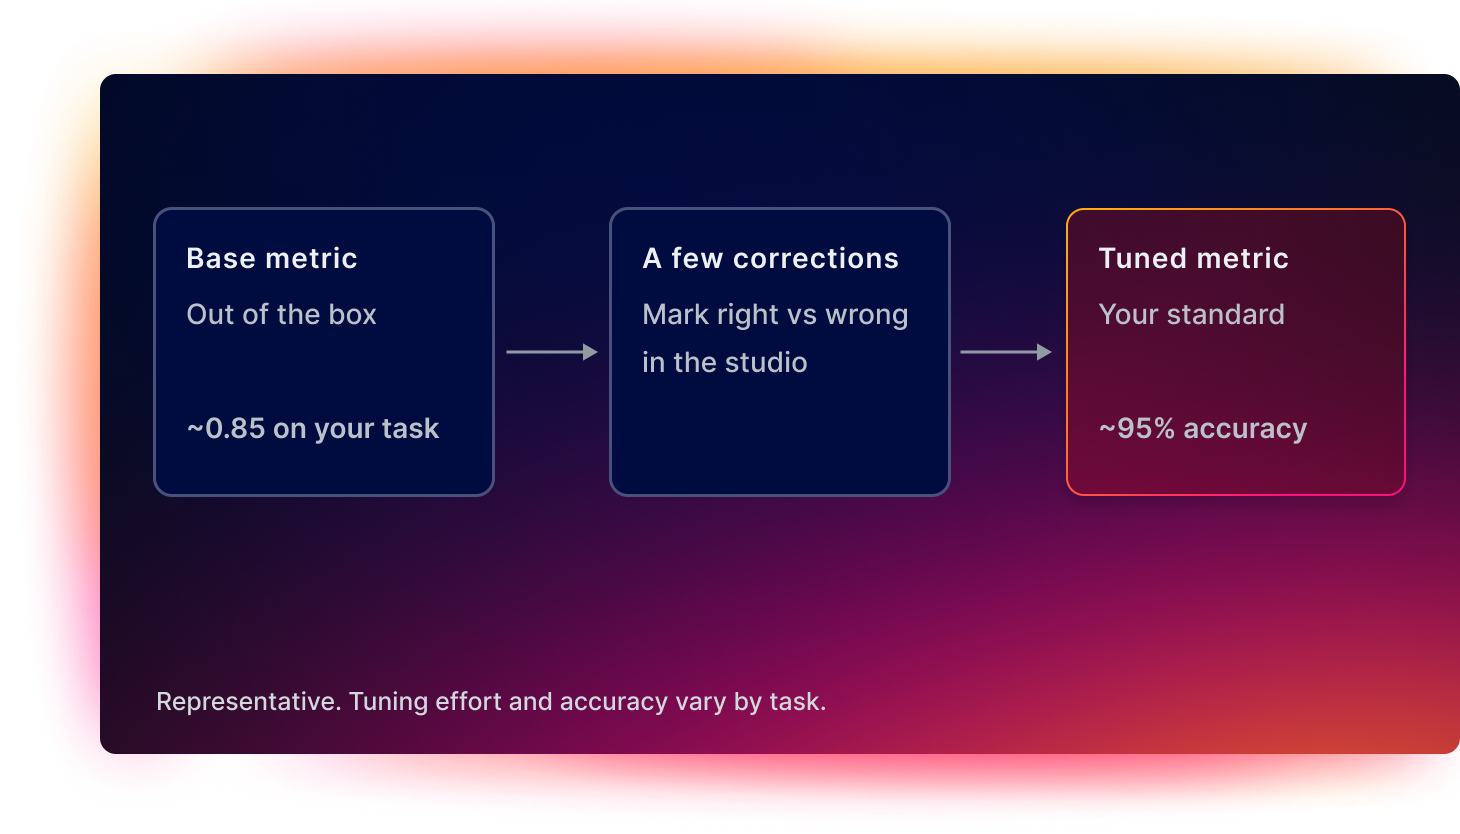
开箱即用的指标可助您快速上手,但您的业务领域对“正确”有其自身定义。借助 Luna Studio,只需修正少量 Luna 的判定结果,它便能学习您的标准,在您自己的任务上达到约 95% 的准确率。无需数据标注流程,无需模型训练专业知识。在工作室中即可查看、修正并交付经过调优的指标。
功能

运行持续评估,无需承担更大型模型的成本和延迟。Luna-2 的微调 SLM 能以每百万个令牌几分钱的成本提供毫秒级判定,让大规模生产评估切实可行。
在错误转化为操作之前,为代理工作流设置防护机制。Luna-2 可实时评估工具选择和代理流程,在工具执行前捕捉高风险行为,而非仅在事后检测问题。


无需额外增加数秒延迟,即可同时评估代理行为的多个维度。Luna-2 可在 L4 GPU 上于 200 毫秒内同时运行 10–20 项核查,从而实现大规模实时防护机制。

获得生产级评估,无需为每次交互都支付前沿 LLM 评估模型的费用。Luna-2 在保持高准确率和低延迟的同时,能够以每百万令牌 $0.12 的成本提供评估。

不仅衡量最终响应。Luna-2 还会评估工具错误、工具选择质量、操作推进以及操作完成情况,以便您可以了解代理是否成功向用户目标迈进并实现目标。

评估特定于您的 AI 应用的行为。Luna-2 可以为生产用例提供自定义 LLM 指标支持,而轻量级适配器允许单个基础模型以最小的基础设施开销扩展至数百个指标。
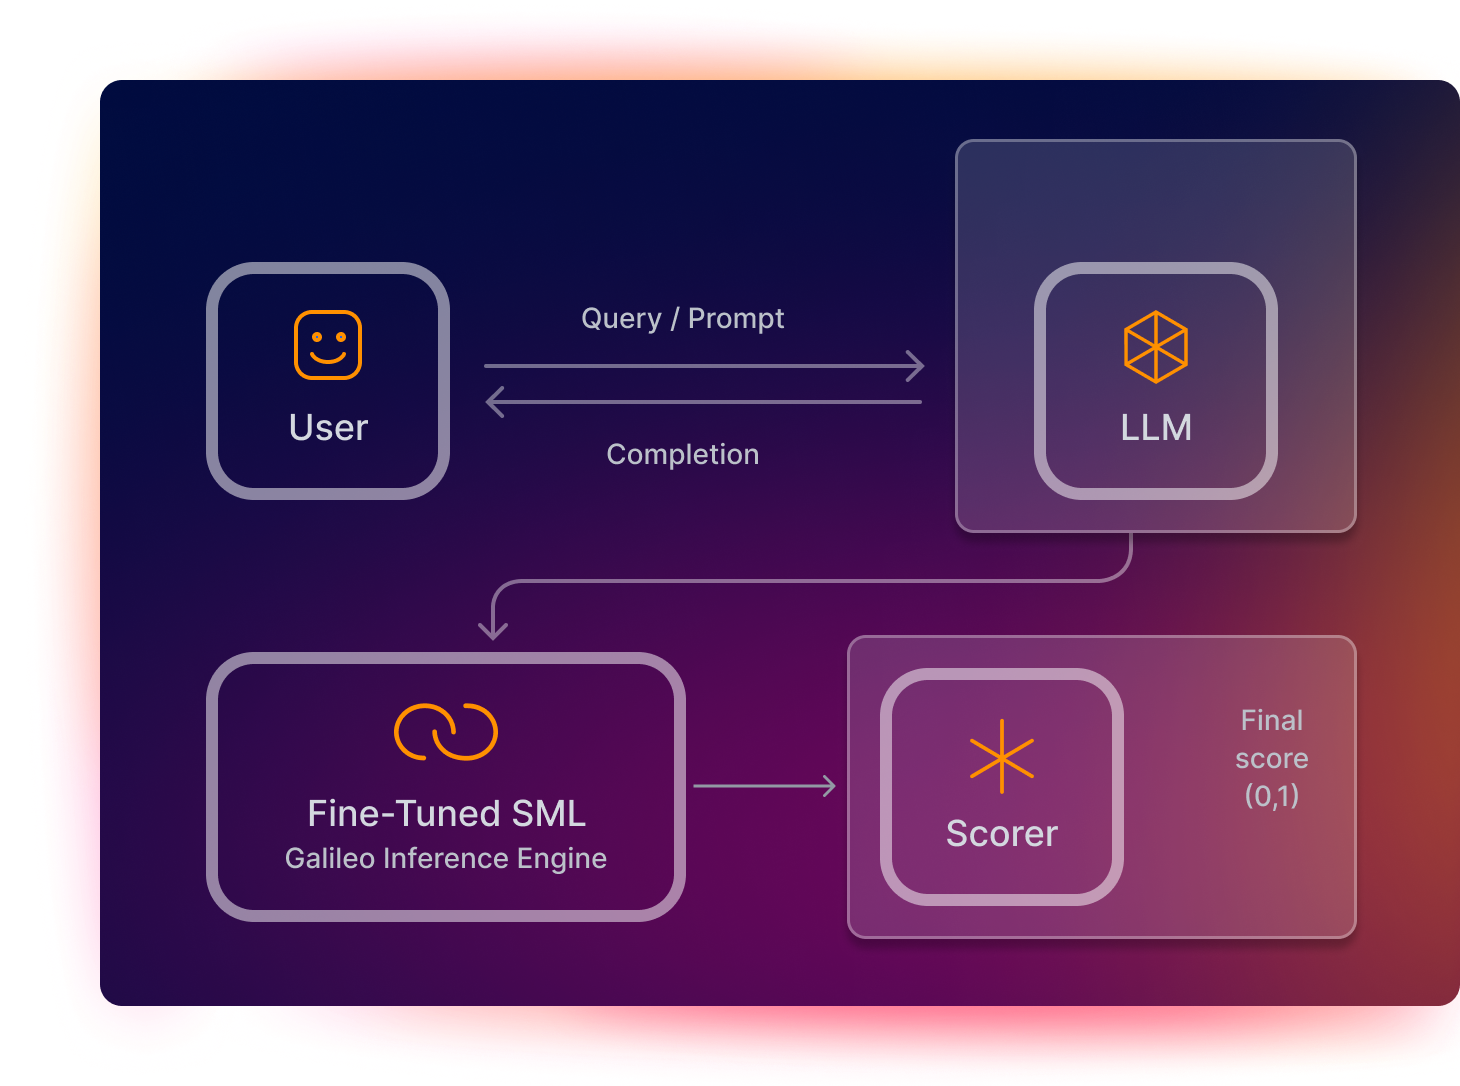
Luna 是一个专为评估而构建的专用小语言模型系列。它们能够快速、低成本地对代理交互进行评分与防护,从而让监控 100% 的流量(而非仅针对抽样)变得经济可行。
前沿评估模型成本高昂且速度缓慢,因此团队只能抽样检查 1–5% 的流量,并且只能在操作执行后进行审查。Luna 专为一项作业而构建,即评估代理交互,因此其成本足够低,可对所有交互进行评分,速度也足够快,可提供实时防护。
Luna 运行评估和防护机制的成本比 LLM 作为评估模型的方法低约 98%,从而改变了经济模式,使其从按配额限制转变为针对每一次交互运行。
是的。Luna 以单个令牌形式返回判定结果,因此评分具有确定性:两次运行相同的输入可获得相同的答案,这正是使模型作为评估模型值得信赖的原因。
是的。借助 Luna Studio,您只需纠正少数裁定,它便能学习您的标准,在您自己的任务中达到约 95% 的准确率,且无需标注流水线或模型训练专业知识。
© 2005 - 2026 Splunk LLC 保留所有权利。