splunk background

可視化

エージェントの完全なトレースを可視化

エージェントを推論から基盤となるGPUに至るまで追跡して、問題発生時にその根本原因をすばやく特定できます。

無料版 14日間無料でご利用いただけます。クレジットカード情報のご登録は不要です。
ガイド付きツアーを見る 5分ほどで製品の仕組みをご紹介します。
可視性

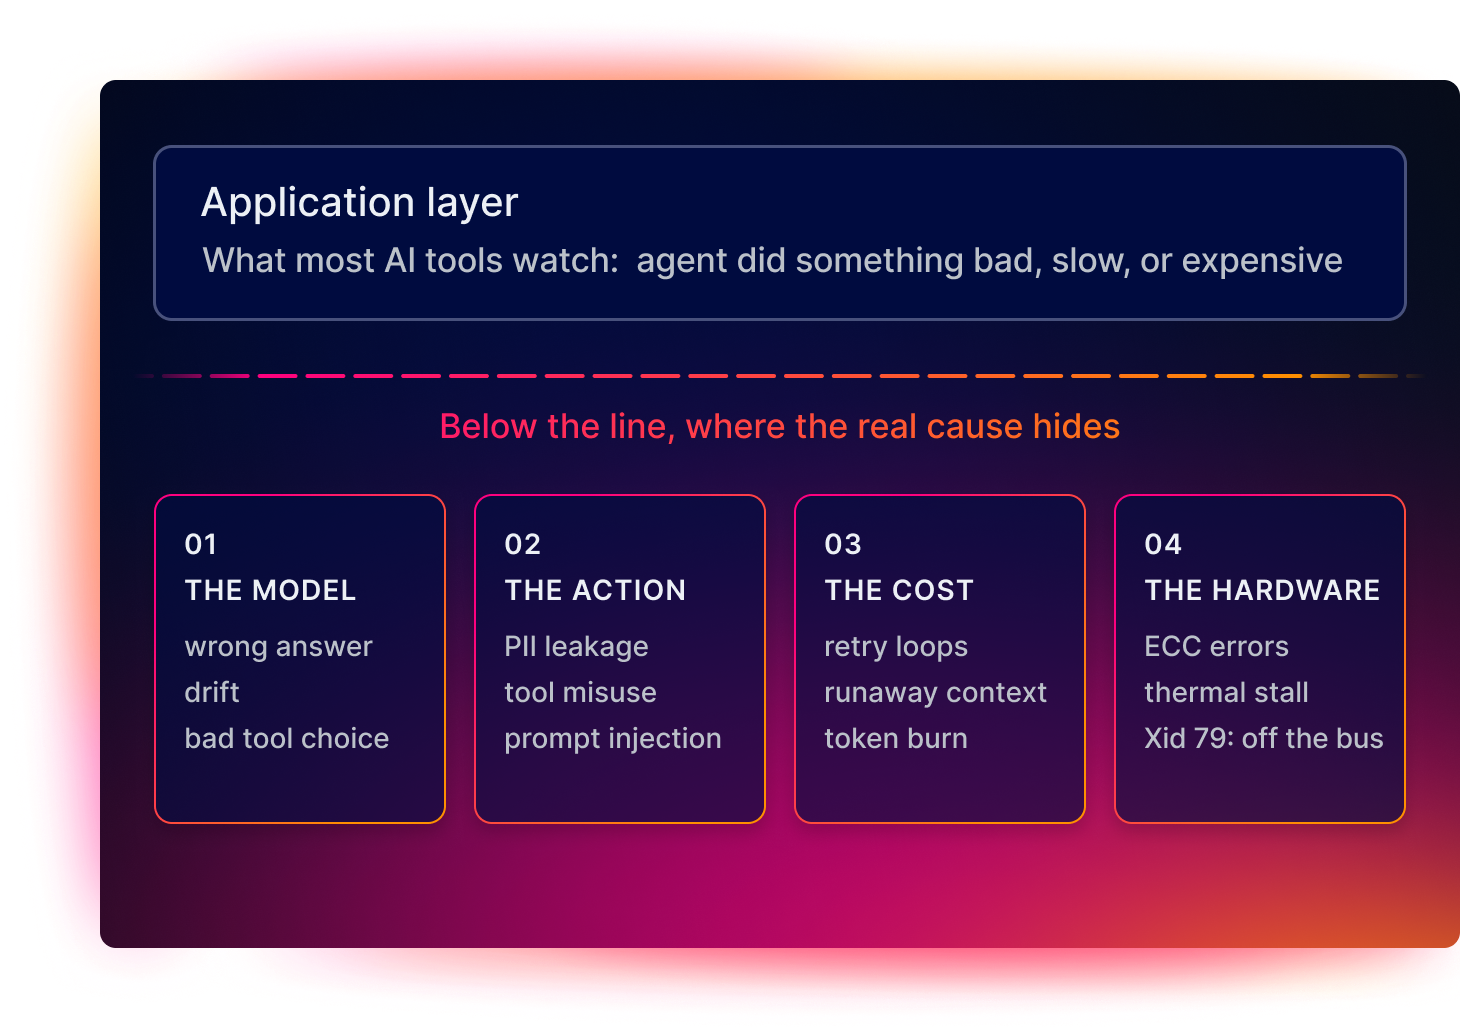
アプリケーション層の下まで追跡して原因を特定

不適切な回答や実行停止の原因をチップレベルまで追跡して、エージェントのトレースとハードウェアのイベントを1つのタイムラインで確認できます。

コードの下層で発端となった問題を捕捉

根本原因はしばしば、オーケストレーション層の裏に隠れています。例えば、モデルのハルシネーション、エージェントによるツール選択の誤り、いつの間にか増大したインフラコスト、ハードウェアでの障害といった問題です。

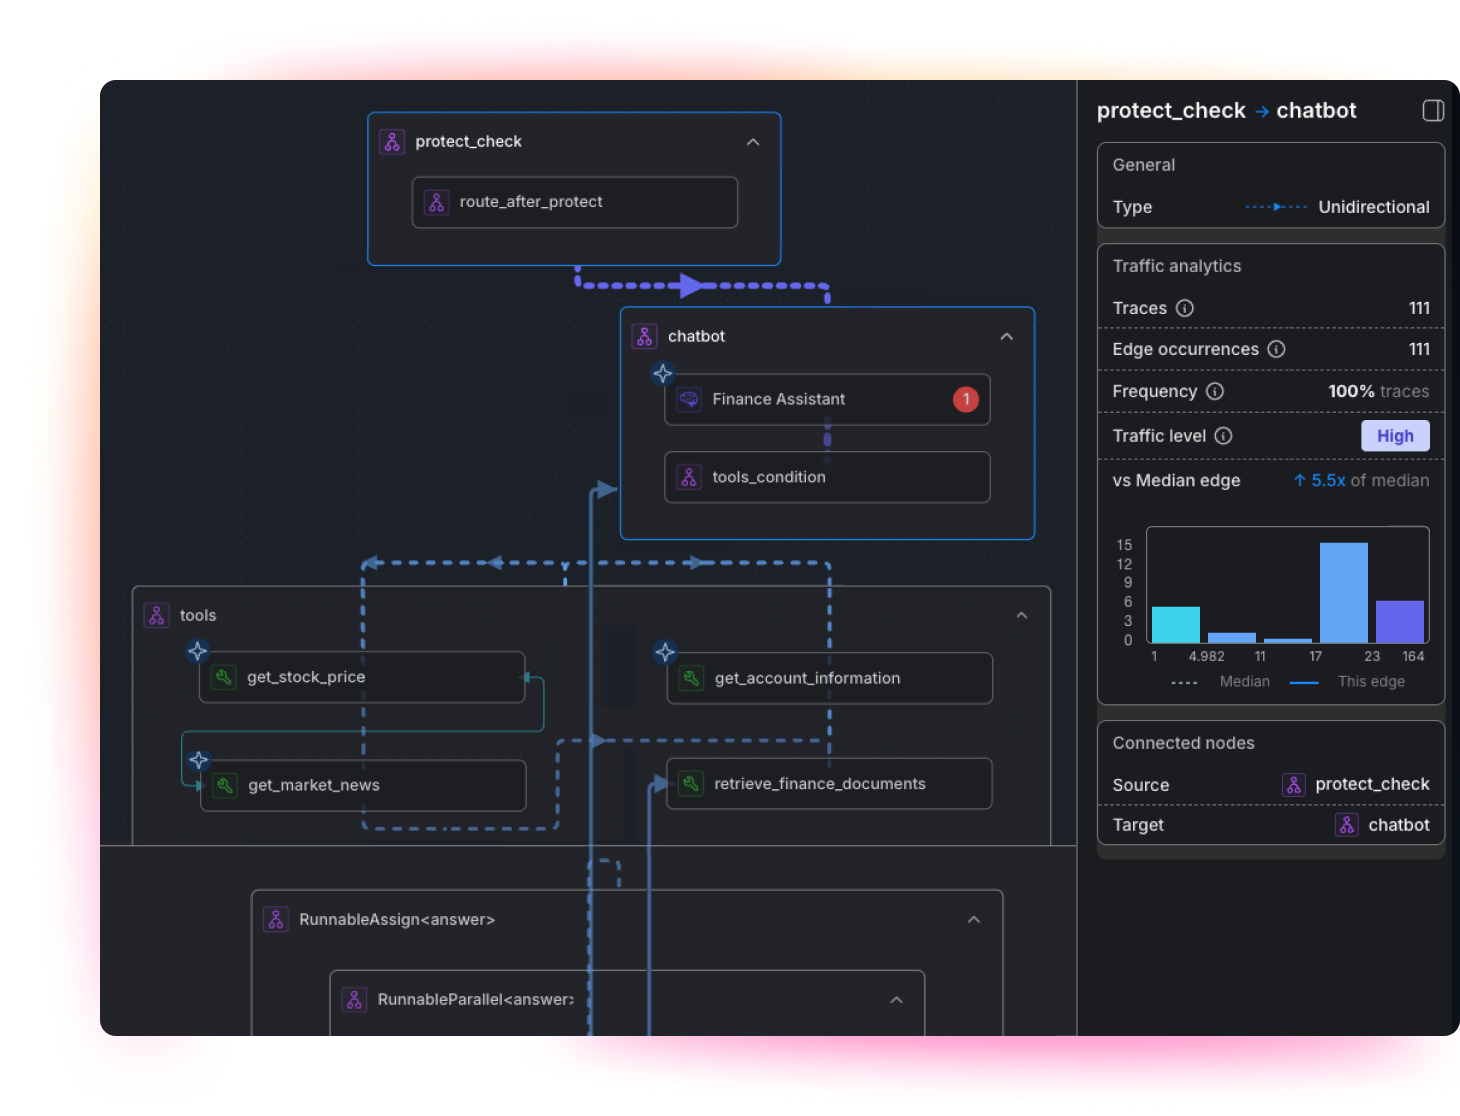
リクエストからレスポンスまで、マルチエージェントワークフローを追跡してマッピング

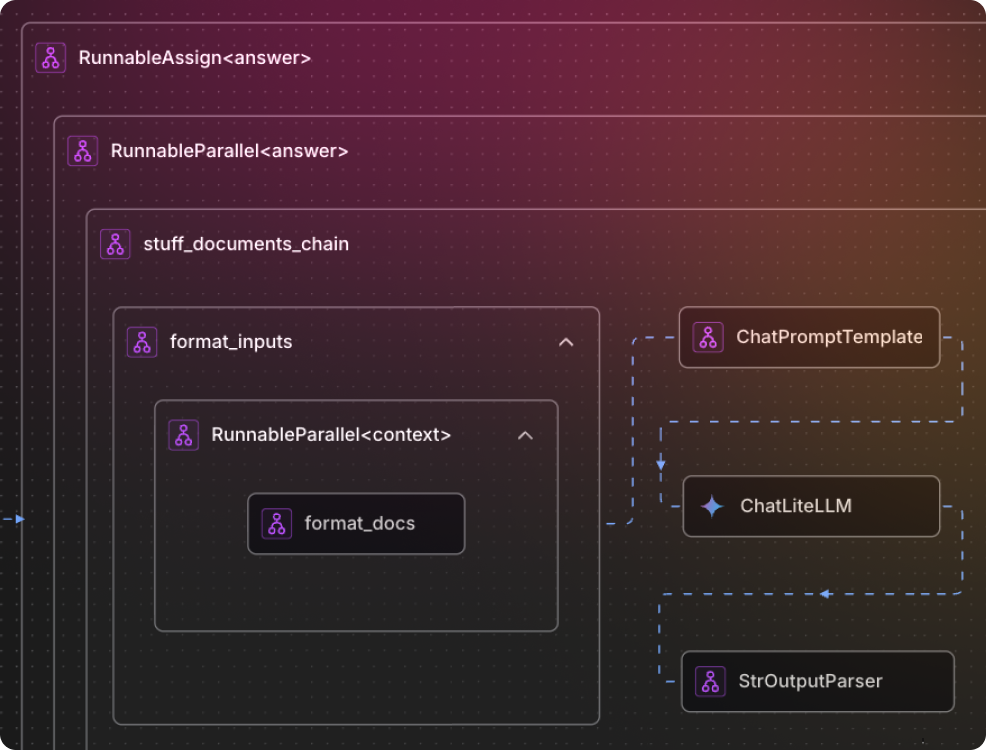
各リクエストをエンドツーエンドで追跡できます。エージェントがどのように処理を引き継ぎ、どのステップで遅延が発生し、どこで問題が起きたかを可視化します。トレースにはエージェントの推論が示されるため、実行失敗という結果だけでなく、エージェントが実行した処理とその実行理由も読み取ることができます。

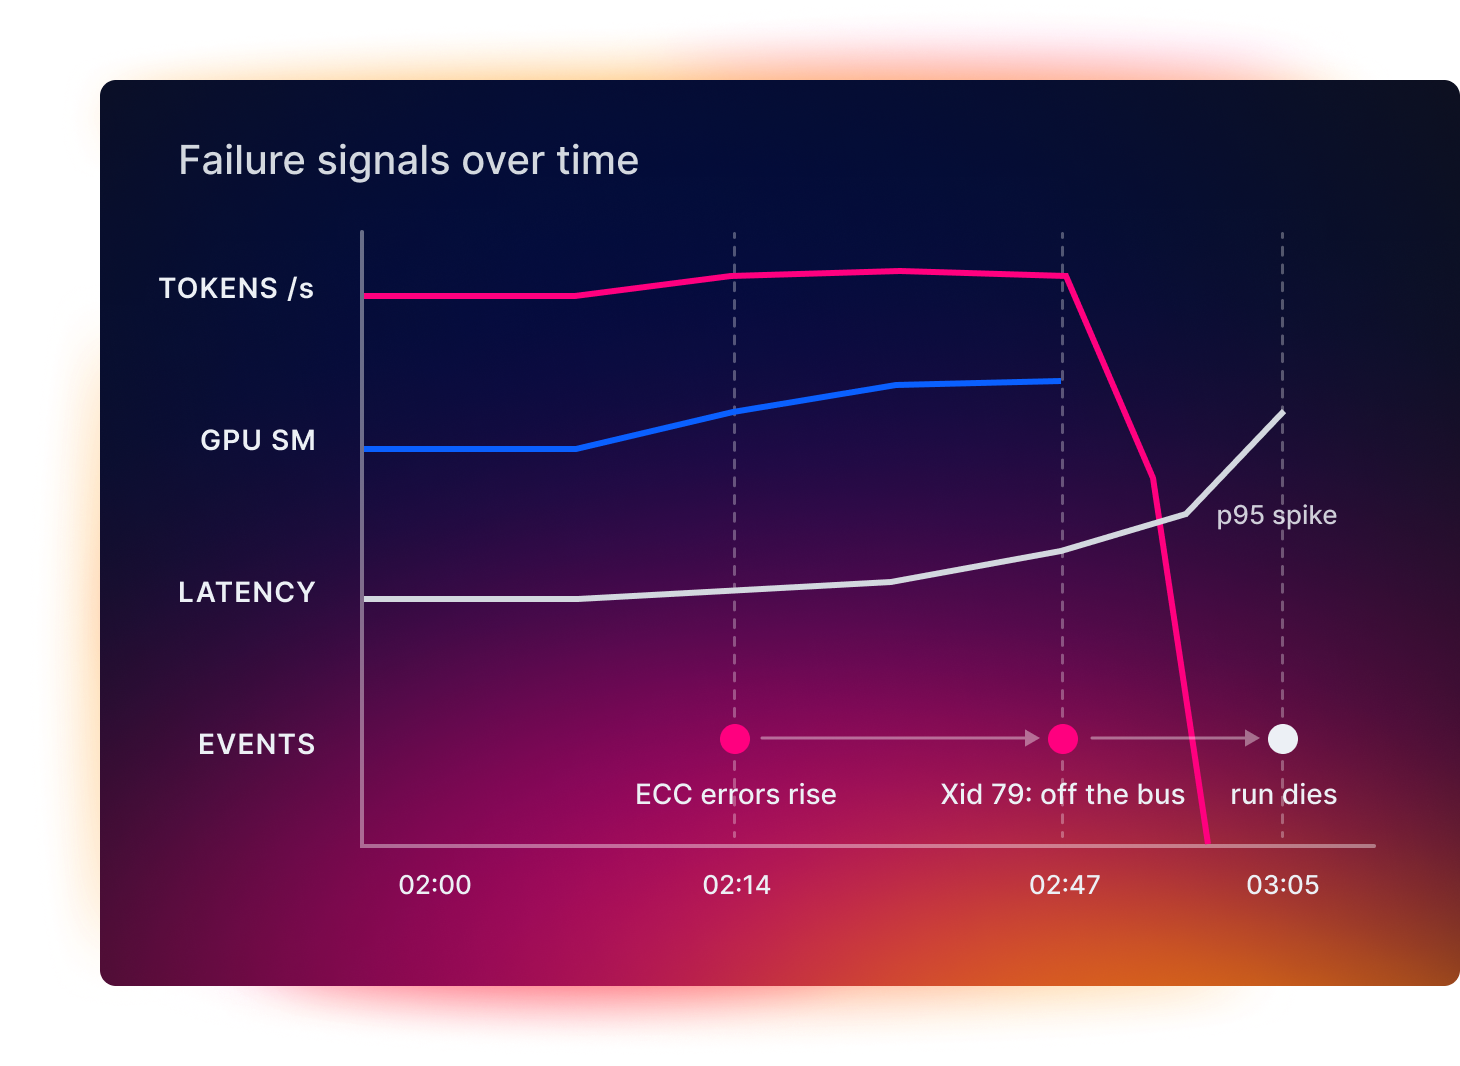
エージェントとインフラの動作を1つのタイムラインで相関付け

テレメトリを相関付けることにより、パフォーマンスの問題の初期兆候を可視化できます。トークンの急増、GPUサチュレーション、レイテンシーの急増、ECCエラーの増加、Xid 79イベントを同時に確認できれば、各チームでリスクをすばやく特定し、トラブルシューティングを迅速に行って、実行が途中で停止する前に対応できます。

.Conf 26プロモーション画像

.conf26の基調講演を視聴する

Splunkのエキスパートや業界リーダーからのインサイトをご確認ください。

今すぐ視聴する >

特長

推論からGPUに至るまで、スタック全体を可視化

ドキュメントを見る(英語)
エージェントを推論からGPUまで追跡 エージェントを推論からGPUまで追跡

エージェントを推論からGPUまで追跡

リクエストからレスポンスに至るワークフローの各ステップ(ツールの呼び出し、モデル実行、検索)を可視化し、その動作と実行基盤となるインフラを関連付けます。根本原因を、異なるツールをいくつも切り替えて探す代わりに、1つのタイムライン上で確認できます。
支出 支出

基盤のインフラを可視化

モデルやベクトルデータベースを含むAIスタック全体で、GPUとメモリの使用状況、消費電力、TTFT (Time To First Token)を追跡します。トークンの急増とGPUサチュレーションを同時に把握できれば、応答の遅延の原因はもはや謎ではありません。
失敗した実行をステップごとに調査 失敗した実行をステップごとに調査

失敗した実行をステップごとに調査

ECCエラーの急増から、熱や電力使用量の異常、Xid 79、実行途中での停止に至るまで、エージェントのトレースとGPUのテレメトリを1つのタイムラインに並べて調査できます。「なぜ失敗したのか?」という疑問への答えを1つの画面で把握できます。

トラフィック トラフィック

実行が失敗する前に問題の連鎖を捕捉

大損害をもたらす障害には、通常、予兆があるものです。こうした初期兆候は可視化できます。テレメトリを相関付けて、まだ実行を復旧する時間があるうちに警告することで、実行がやがて停止してしまうのを避けることができます。

健全性とリスクを把握 健全性とリスクを把握

健全性とリスクを把握

AIスタック全体の可用性と健全性を監視して、パフォーマンス低下を早期に検出します。実行が途中で停止してしまう前に、ECCエラー数の増加やキャッシュの飽和を把握できます。

Splunkを基盤にシスコと相関付け Splunkを基盤にシスコと相関付け

Splunkを基盤にシスコと相関付け

用途特化型のAIツールでは、プロンプトは把握できても、チップレベルまでは確認できません。一方、汎用的な監視ツールでは、GPUの状況は把握できても、エージェントの推論やネットワークファブリックまでは確認できません。Splunkとシスコでは、スタック全体が対象になるため、不適切な回答とその原因となったチップレベルの問題を1カ所で確認できます。


リソース
その他の情報

Agent Observabilityとトレースに関するよくある質問

トレースでは、個々のリクエストをマルチエージェントワークフロー全体でエンドツーエンドで追跡します。つまり、ツールの呼び出し、モデル、取得のすべてのステップとエージェントの推論を記録して、その挙動を実行基盤のインフラと関連付けます。

原因は通常、アプリケーション層の下に隠れています。一般的には4つ考えられ、1つ目がモデルの誤り、2つ目がエージェントが実行した処理の誤り、3つ目がいつの間にか膨らんだコスト、4つ目がハードウェアでの障害です。

はい。トークンの急増、GPUサチュレーション、レイテンシーの急増が1つのタイムラインに表示されるため、実行のスピード低下や失敗から、症状だけでなく真の原因まで特定できます。

自社のハードウェアでオープンウェイトモデルを実行している場合は、プロバイダーの稼働状況をチェックするためのページは表示されません。テレメトリを相関付けることにより、失敗をチップレベルまで追跡し、長時間にわたる実行が途中で停止する前に、ECCエラーの増加などの初期兆候を捕捉できます。

Splunk Agent Observabilityは、Splunkデータプラットフォームを基盤に構築され、シスコインフラと相関付けられています。そのため、エージェントの推論トレース、出力品質、コスト、基盤となるGPU、ベクトルデータベース、ネットワークファブリックに関する情報すべてを1つの記録システムに集約できます。

関連製品

Splunk Cloud Platform

あらゆるドメインを横断して、データ、コンテキスト、アクションを統合します。

詳細はこちら

Splunk Enterprise Security

エージェンティックSOC向けに、脅威の検出、調査、対応が統合されています。

詳細はこちら

Splunk IT Service Intelligence

AIドリブンのサービス監視によってITの問題を予測し、防ぎます。

詳細はこちら
Splunkを使い始める

推論からGPUに至るまで追跡して、根本原因を特定しましょう。

デモを申し込む
無料トライアル版を探す