成本降低 98%,改變經濟效益
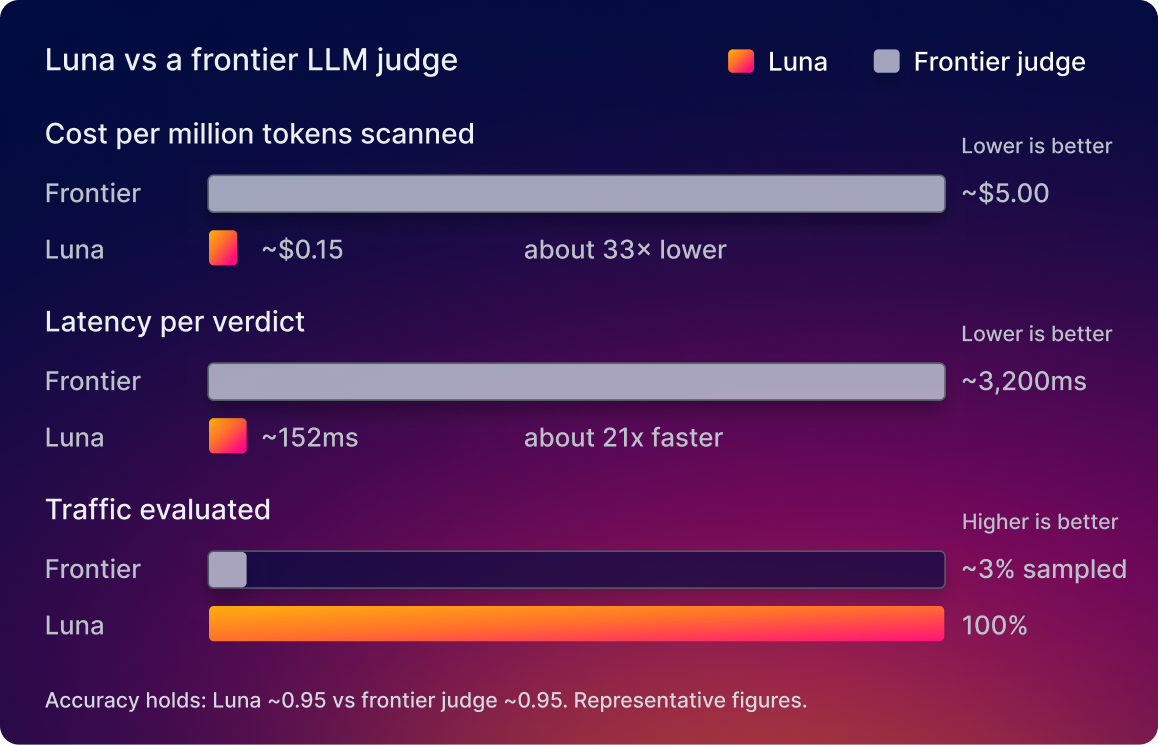
當每百萬個 Token 的判定成本降至約 0.15 美元,不再是 5.00 美元時,您就不必再對使用量斤斤計較。評估每一次互動並提供防護,不要只是局部抽樣。

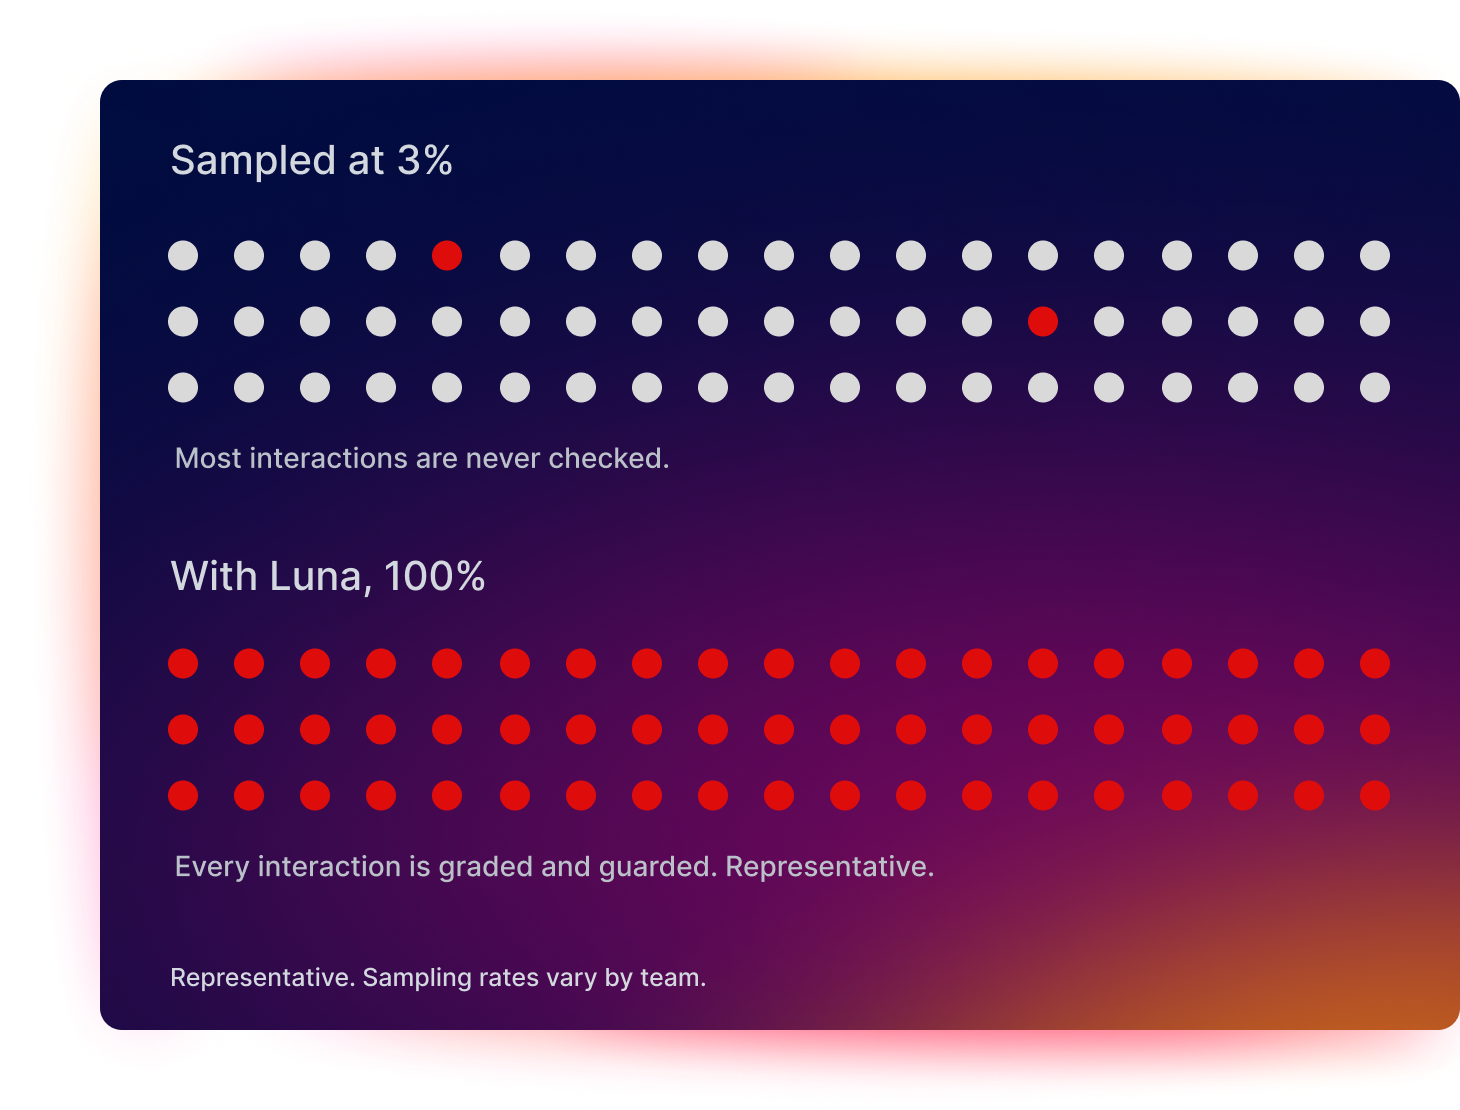
專用小型語言模型可評估每一次互動並提供防護,讓您能以經濟實惠的方式監控 100% 的流量。
頂尖評判模型掃描百萬個 Token 的成本約為 $5.00。在量產規模下,若對所有內容進行評估,成本過於昂貴,因此團隊通常只抽查 1% 至 5% 的互動,並寄望其餘內容表現一致。漏掉的,往往最致命:您沒發現的幻覺,以及趁虛而入的提示詞注入攻擊。
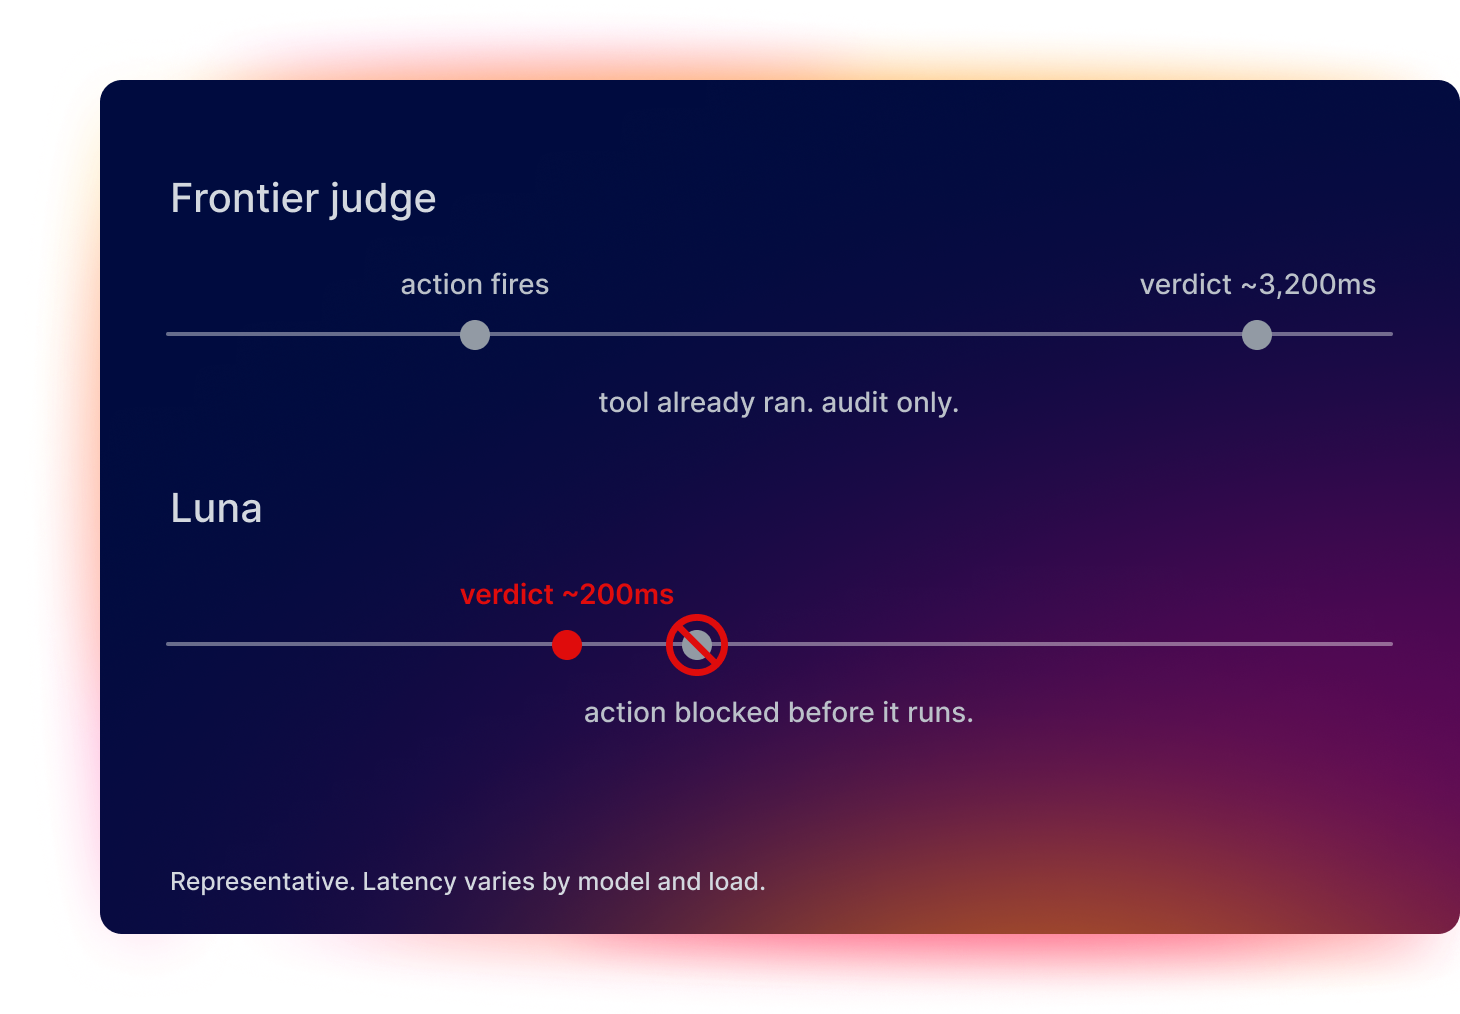
頂尖評測模型可能需要約 3,200 毫秒才能回傳判定結果。屆時該工具早已執行,判定結果只能說明已發生的情況。該工具可以進行稽核,但無法提供防護。Luna 僅需約 152 毫秒即可回傳判定結果,速度快到能在工具觸發前封鎖動作。
Luna 以單一 Token 回傳判定結果,因此評分既快速又可重複。對相同的輸入執行兩次,您會得到相同的答案,這正是模型作為評測模型值得信賴的原因。而且,由於 Luna 在您的 VPC 內執行及訓練,您的資料絕不會離開防火牆。
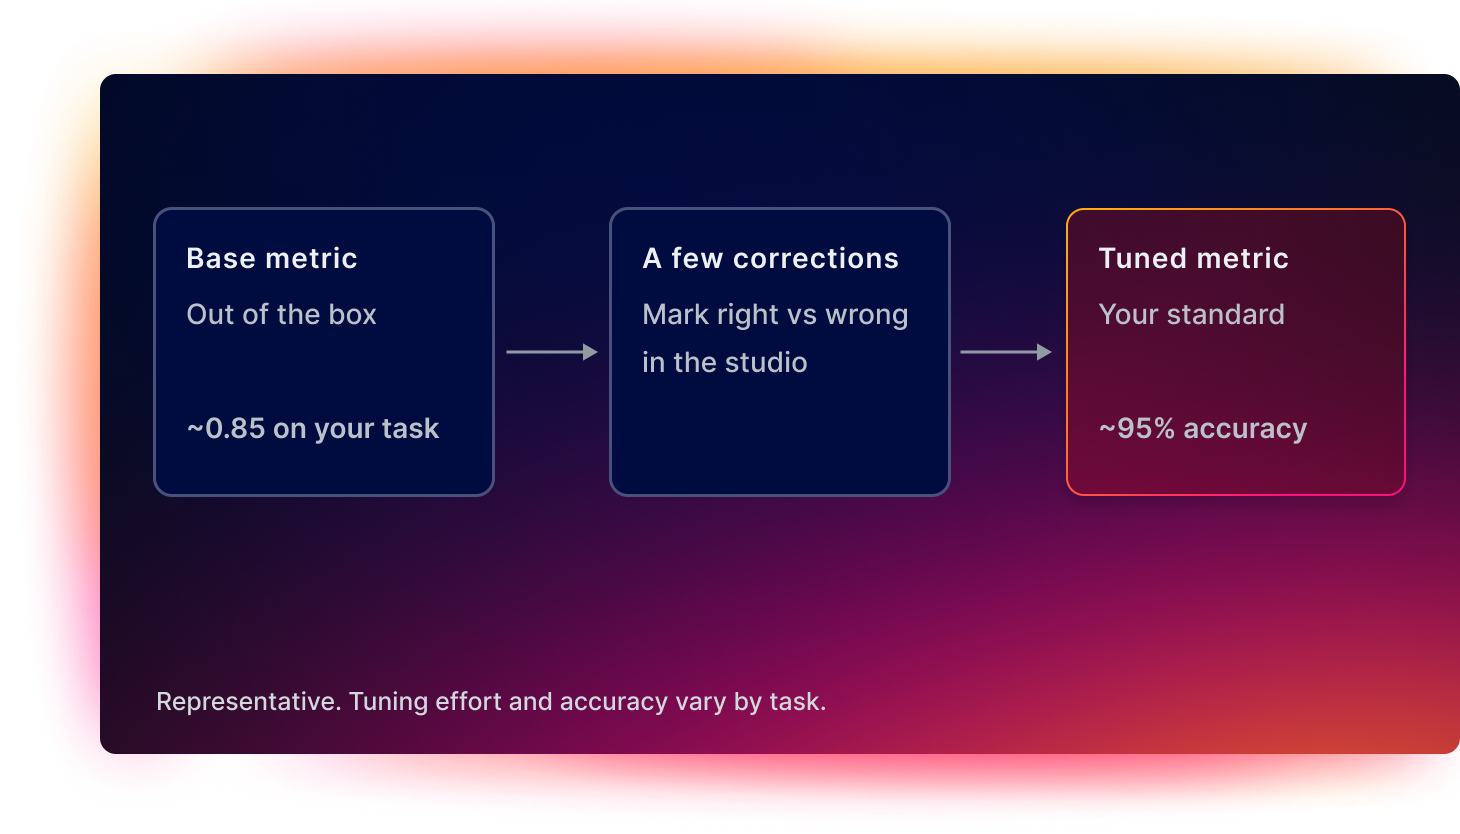
開箱即用的度量可協助您快速上手,但您的領域對「正確」有自己的定義。使用 Luna Studio,您只要修正少量 Luna 的判定結果,Luna 就能學習您的標準,並在您自己的任務上達到約 95% 的準確率。無需標註管道,也不需要模型訓練專業知識。直接在 Studio 中檢閱、修正並推出經調校的度量。
功能

執行持續不間斷的評估,免去較大型模型的成本與延遲負擔。Luna-2 微調後的 SLM 能以每百萬個 Token 僅數美分的成本,提供毫秒級判定結果,讓大規模生產環境評估切實可行。
在錯誤變成動作之前,為代理式工作流程建立防護機制。Luna-2 即時評估工具選擇和代理程式流程,在工具執行前攔截高風險行為,而非僅在事後才偵測到問題。


不用增加數秒延遲,也能一次評估代理程式行為的多個維度。Luna-2 可在 L4 GPU 上於 200 毫秒內同時執行 10-20 項檢查,實現大規模即時防護機制。

無需在每一次互動中支付頂尖 LLM 評測模型的費用,即可獲得生產級的評估品質。Luna-2 以每百萬個 Token 0.12 美金的價格提供評估,同時維持高準確度與低延遲。

別只測量最終衡量回應。Luna-2 能評估工具錯誤、工具選擇品質、動作推進度以及動作完成度,讓您清楚掌握代理程式是否朝向使用者目標順利實現。

針對您 AI 應用程式的特有行為進行評估。Luna-2 可為生產環境的使用情境提供自訂 LLM 指標,同時透過輕量化適配器,只需單一基礎模型即可擴展支援數百種指標,且僅需極低的基礎設施開銷。
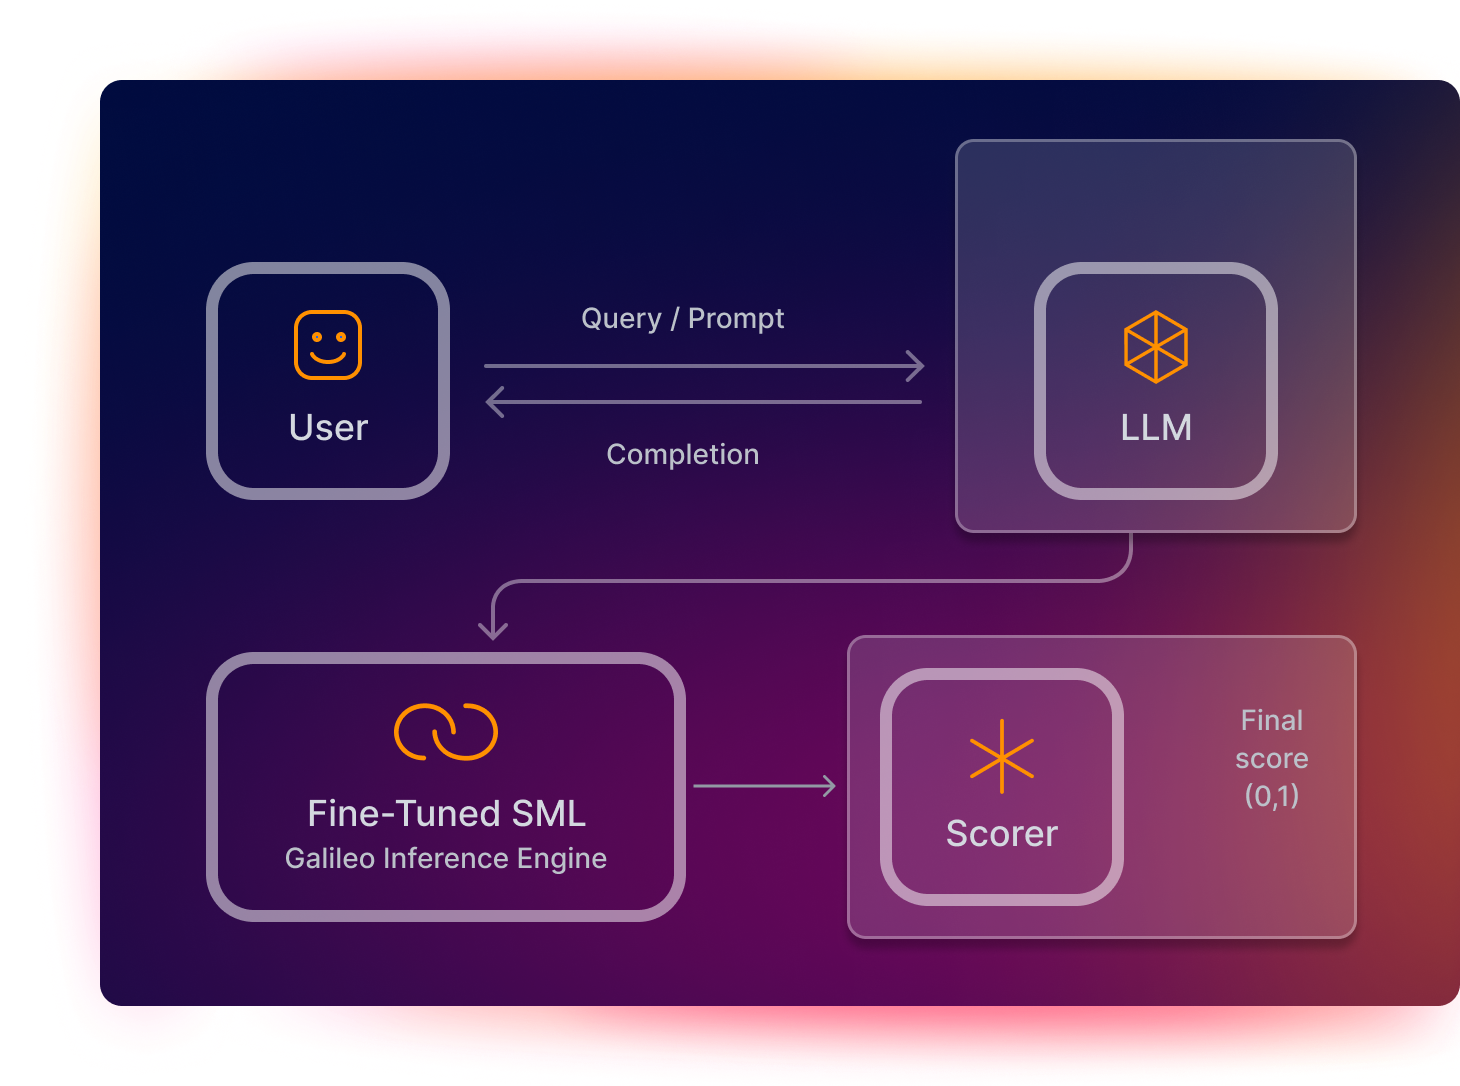
Luna 是專為評估功能打造的小型語言模型系列。這系列能快速且低成本地為代理程式互動進行評分與防護,讓監控 100% 的流量而非僅進行局部抽樣變得極具成本效益。
頂尖評測模型成本高昂,速度又慢,因此團隊僅抽樣 1-5% 的流量,且只能在動作執行後才進行審查。Luna 專為一項工作打造:評估代理程式互動,因此成本極低,足以對所有內容評分,且速度極快,足以實現即時防護。
相較於 LLM 即裁判方法,Luna 執行評估與防護機制的成本約低 98%,徹底改寫經濟效益,讓評估能從限額抽樣轉變為對每一次互動全面執行。
是。Luna 會以單一 Token 傳回判定,因此評分具備確定性:對相同輸入執行兩次,您會得到相同答案,這正是讓模型作為評審值得信賴的關鍵。
是的。使用 Luna Studio,只需修正少數幾個判定結果,系統便會學習您的標準,在您自己的任務上達到約 95% 的準確率,無需標註流程或模型訓練專業知識。
© 2005 - 2026 Splunk LLC 著作權所有,並保留一切權利。