特長
本番環境への導入前後にエージェントの品質を確保

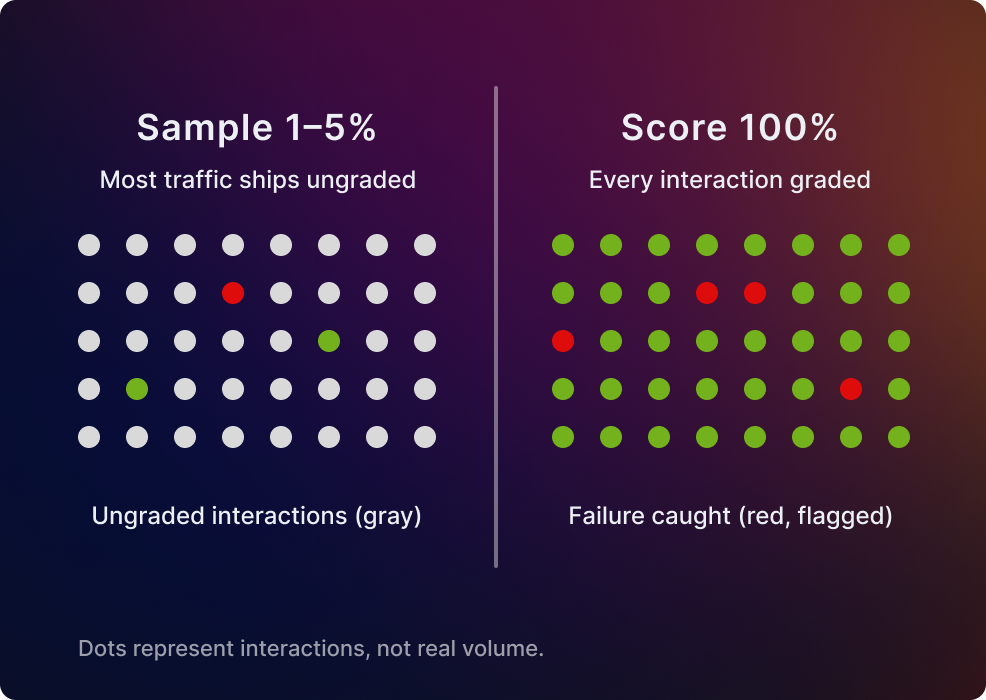
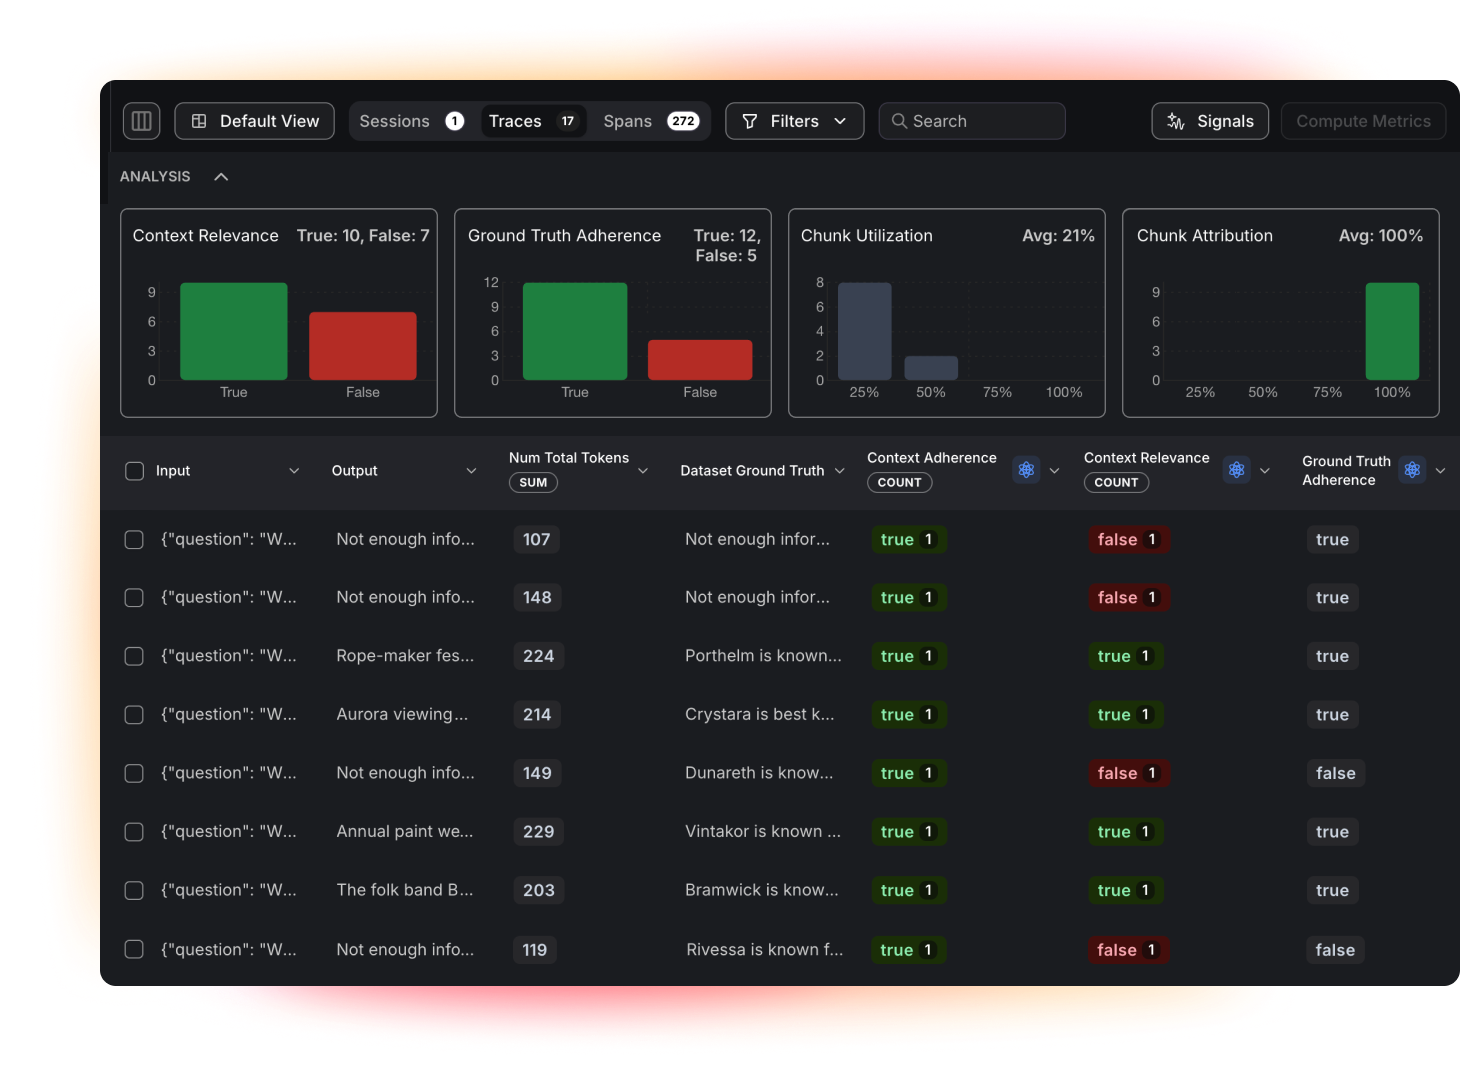
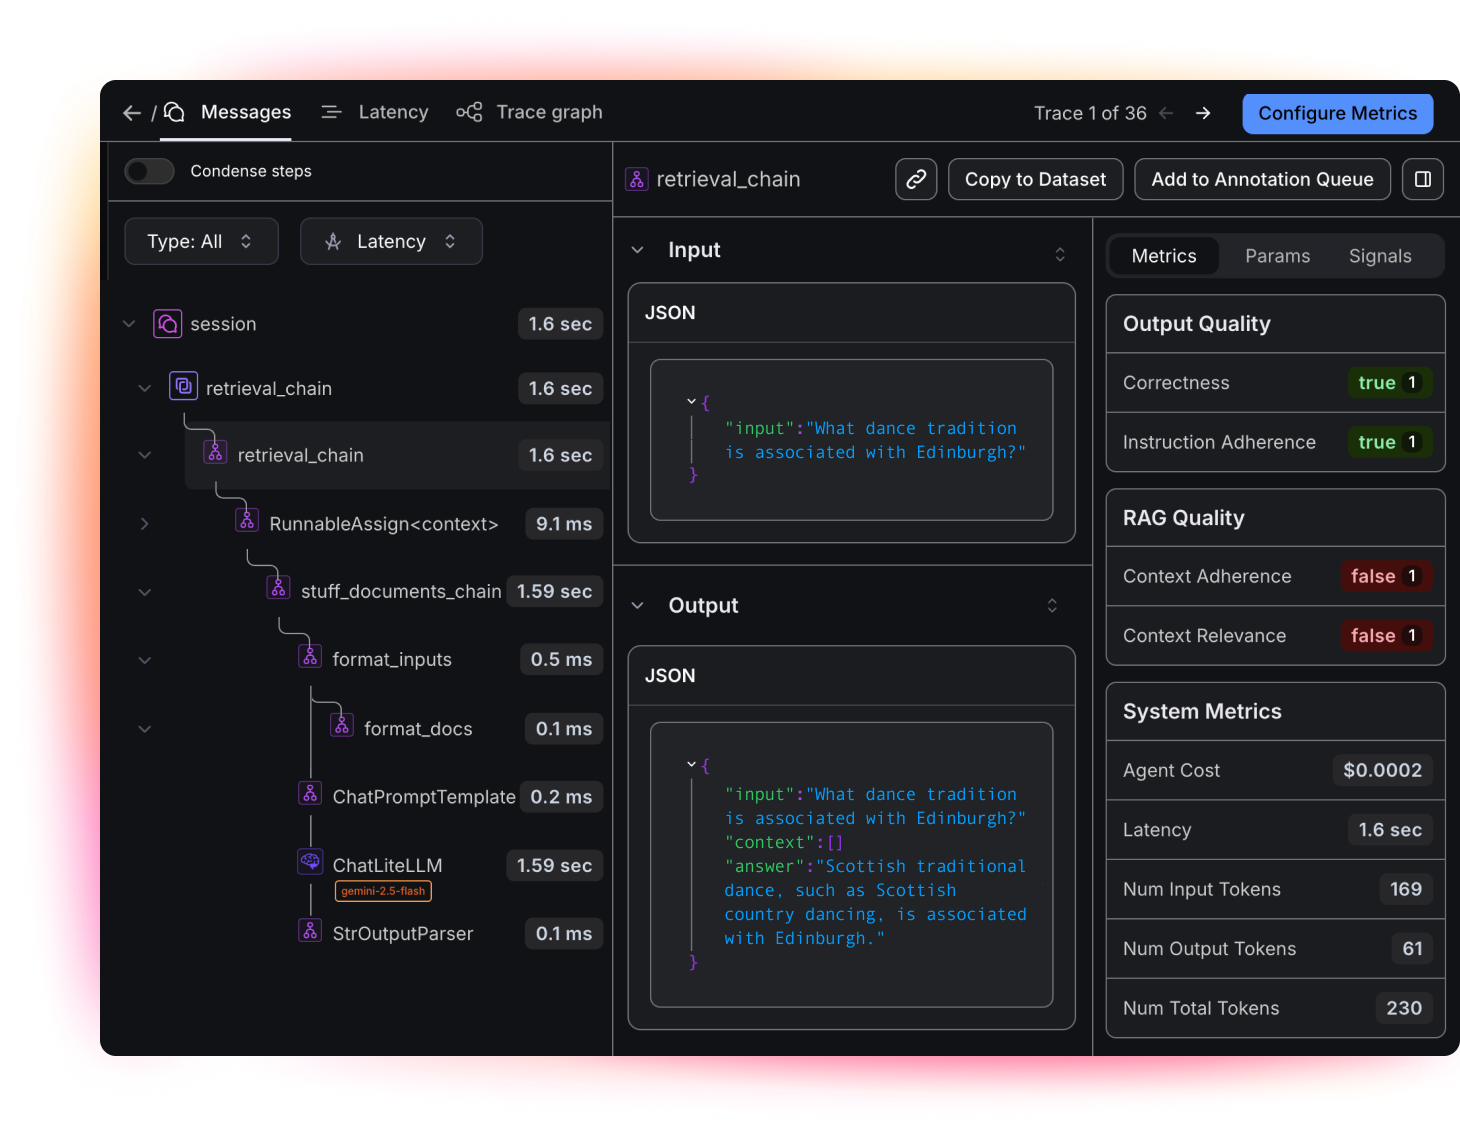
エージェントの誤りをスコアリング
アクションの完了状況、ツールの選択、ハルシネーション、RAGの順守などを評価。標準で用意されたメトリクスを用いることも、独自のメトリクスを作成することもでき、レイテンシー、エラー、コストと同じトレース上にスコアが表示されます。

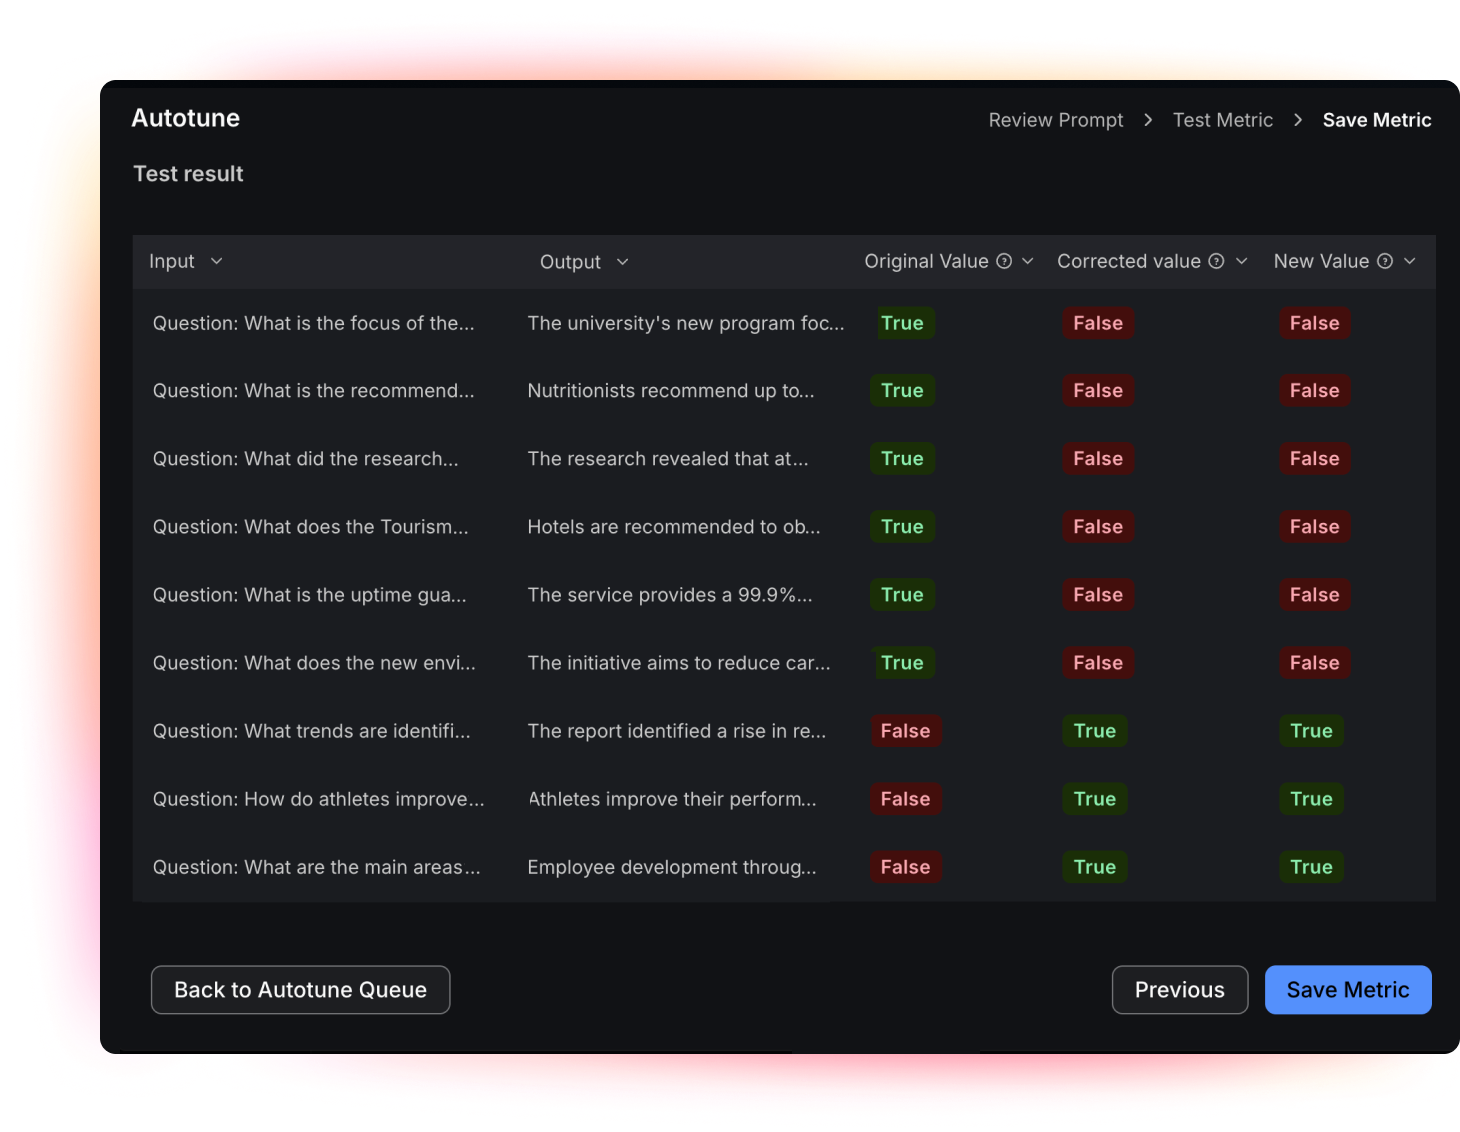
データサイエンティストを介さず評価モデルをその場で調整
間違ったスコアをトレース上で直接修正すると、Autotuneがその内容に基づいて評価モデルをアップデート。これにより、ラベル付けプロジェクトやプロンプトエンジニアリングへの引き継ぎが不要になります。5件ほどの修正例で、精度が約95%に達し、F1スコアがおよそ10~17ポイント向上します。

実験やA/Bテストを実行
本番環境への導入前に、プロンプト、モデル、エージェントの異なるバージョンを同じ基準で比較。スポットチェックからの推測をやめて、どの変更が実際に正確性やツール使用の改善につながったのかを確認できます。

信頼できる評価をガードレールとして採用
テスト環境で信頼性の高いスコアが得られた評価を本番環境での制御に利用。評価を実行時チェックに昇格させて、ツールが実行される前に不適切なアクションを阻止できます。