splunk background

luna

Modèles d’évaluation Luna

Des petits modèles de langage conçus spécialement pour évaluer et protéger chaque interaction, et vous offrir un moyen économique de superviser 100 % du trafic.

Édition gratuite Essayez gratuitement pendant 14 jours. Aucune carte de crédit demandée.
Suivre la visite guidée Vous avez 5 minutes ? Découvrez son fonctionnement.
Modèles d’évaluation Luna
bg-image

L’équation change
avec une baisse de prix de 98 %

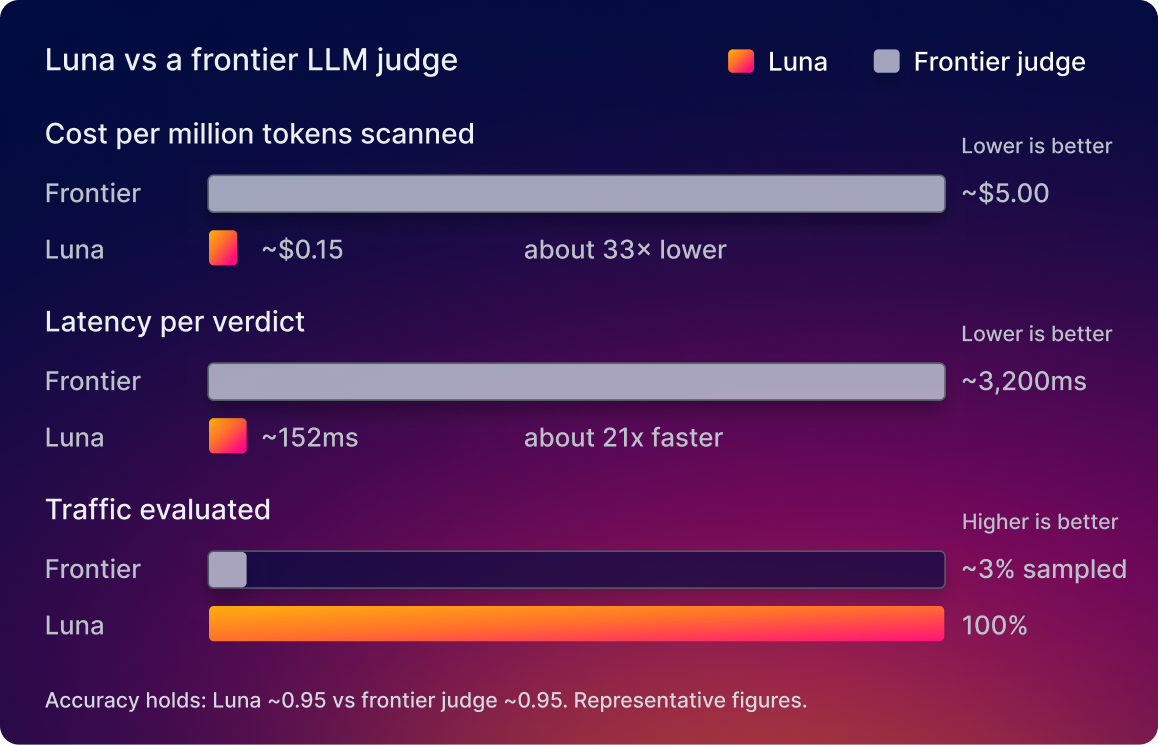
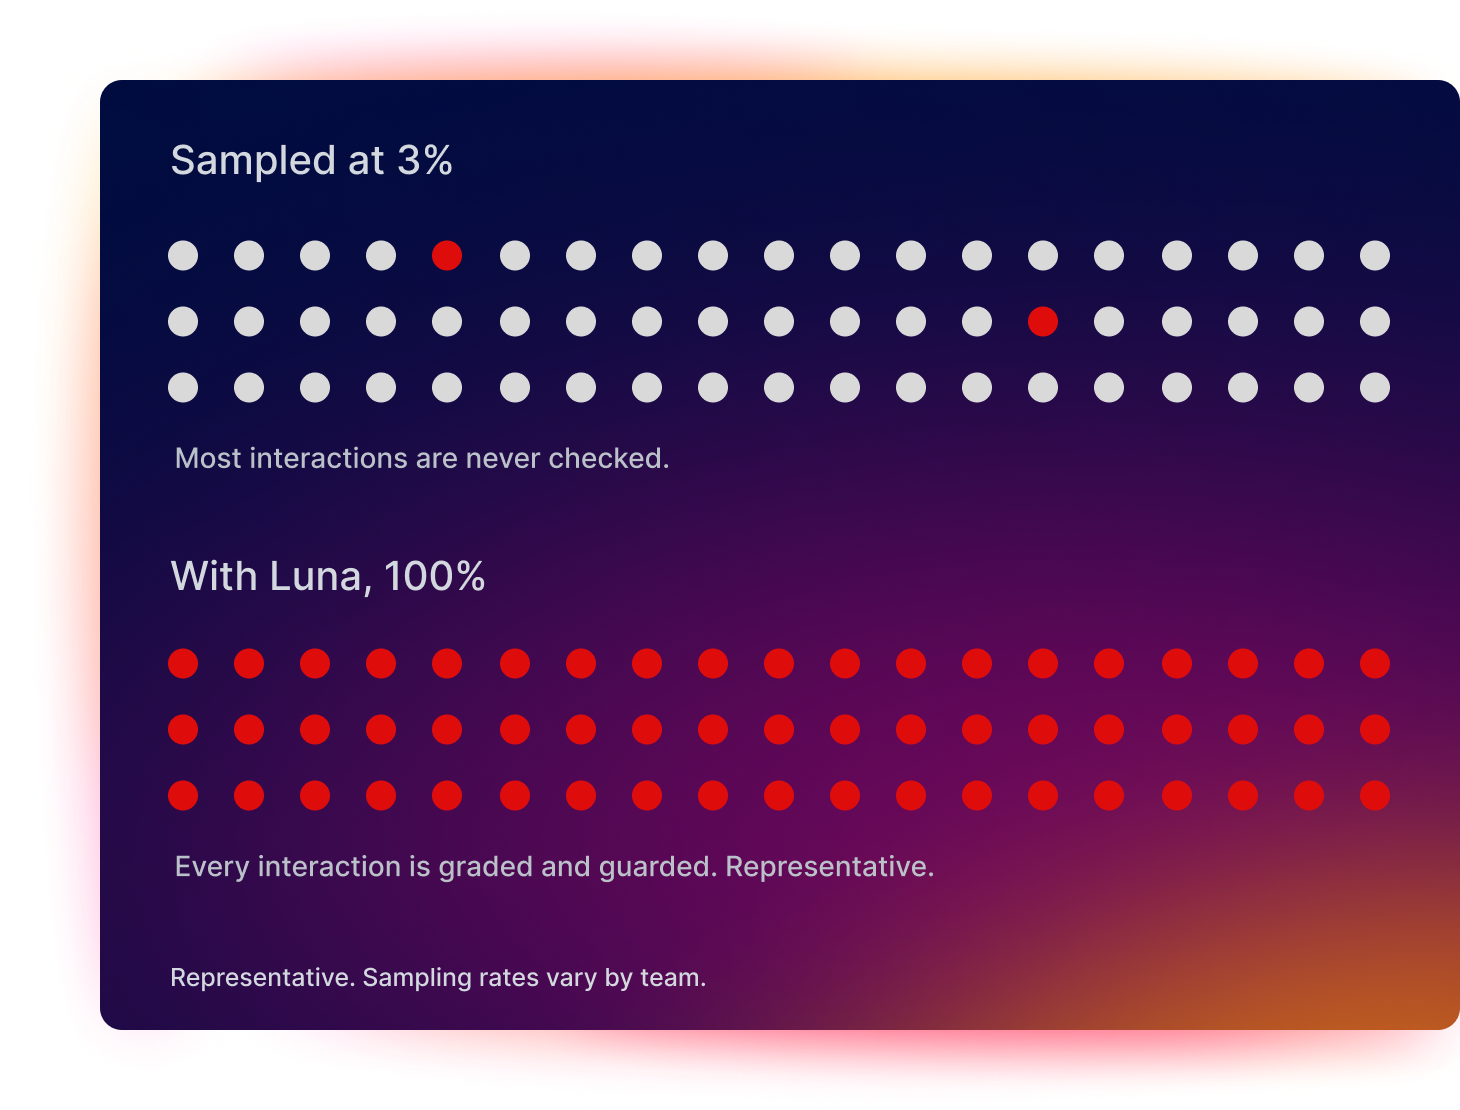
Quand un verdict coûte environ 0,15 $ par million de tokens au lieu de 5,00 $, vous cessez de vous restreindre. Évaluez et protégez chaque interaction, sans échantillonnage.
bg-image

La taxe des juges LLM

Luna est conçu pour une seule tâche : juger les interactions des agents. Grâce à cette spécialisation, il peut évaluer et protéger 100 % du trafic en temps réel, alors qu’un juge frontière sera trop cher et trop lent.

Trop cher pour tout évaluer

Un juge frontière peut coûter autour de 5,00 $ par million de tokens scannés. Appliqué à des volumes de production, ce tarif impose un coût bien trop élevé, et c’est pourquoi les équipes vérifient entre 1 et 5 % des interactions en espérant que leur échantillon est représentatif. Mais c’est dans les interactions manquées que se cachent les problèmes : les hallucinations et les injections passées inaperçues.

Trop lent pour arrêter quoi que ce soit

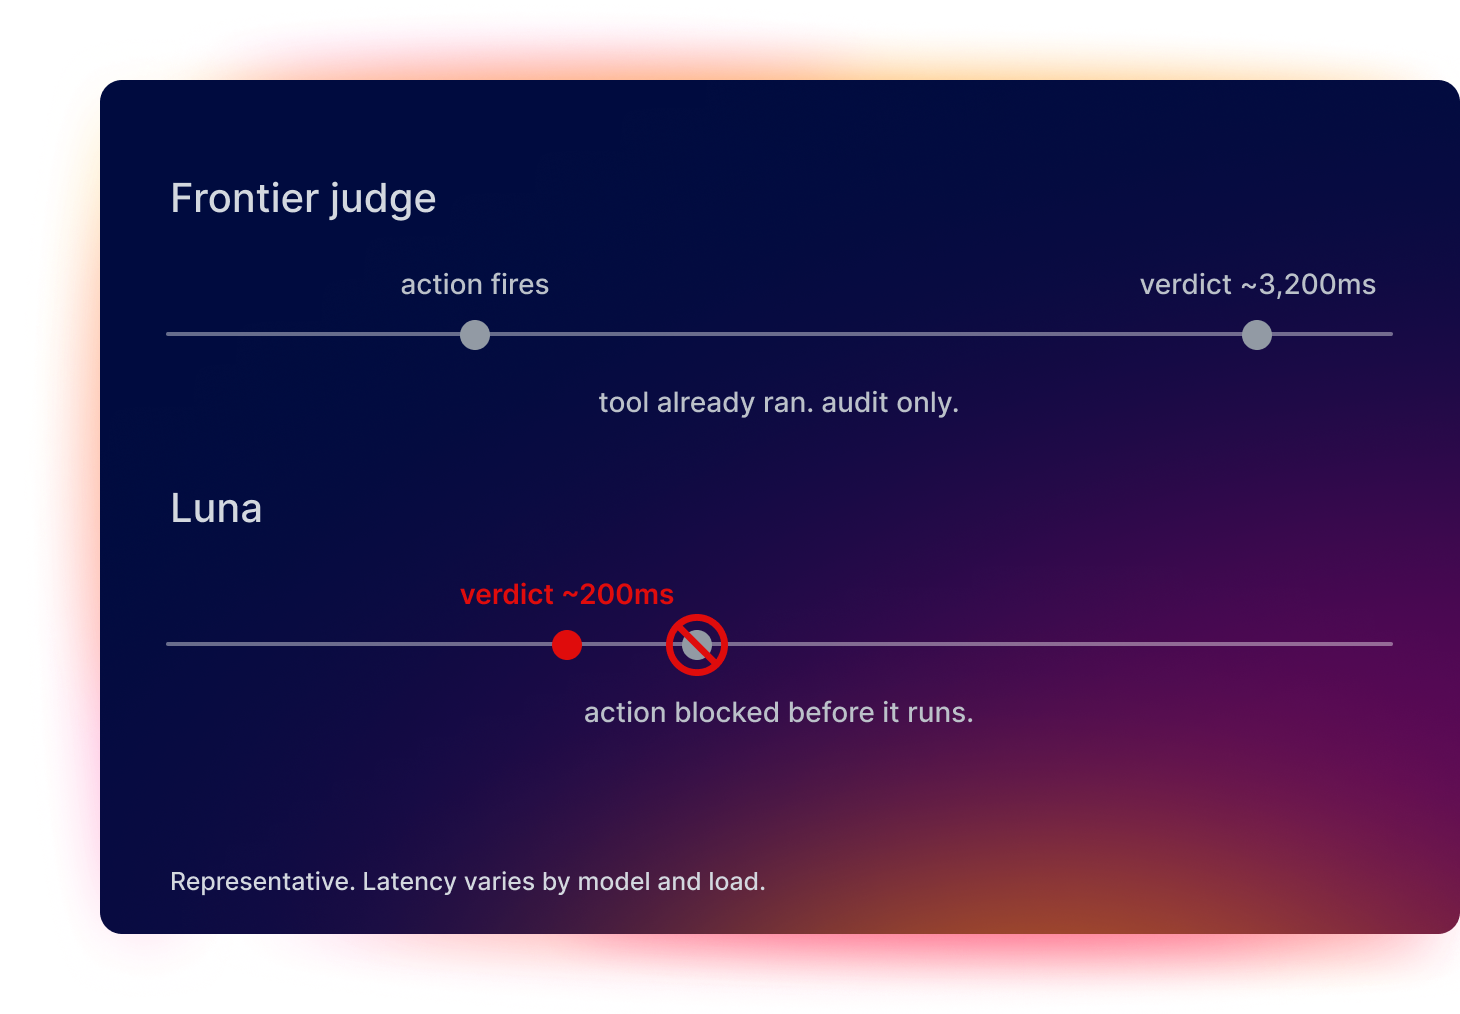
Il faut environ 3 200 ms à un juge frontière pour donner son verdict. Pendant ce temps, l’outil s’est déjà exécuté, et le verdict ne peut que décrire ce qui s’est passé. Il peut auditer, mais pas protéger. Luna renvoie un verdict en 152 ms en moyenne : c’est suffisant pour bloquer une action avant que l’outil ne se déclenche.

Une évaluation déterministe à un seul token

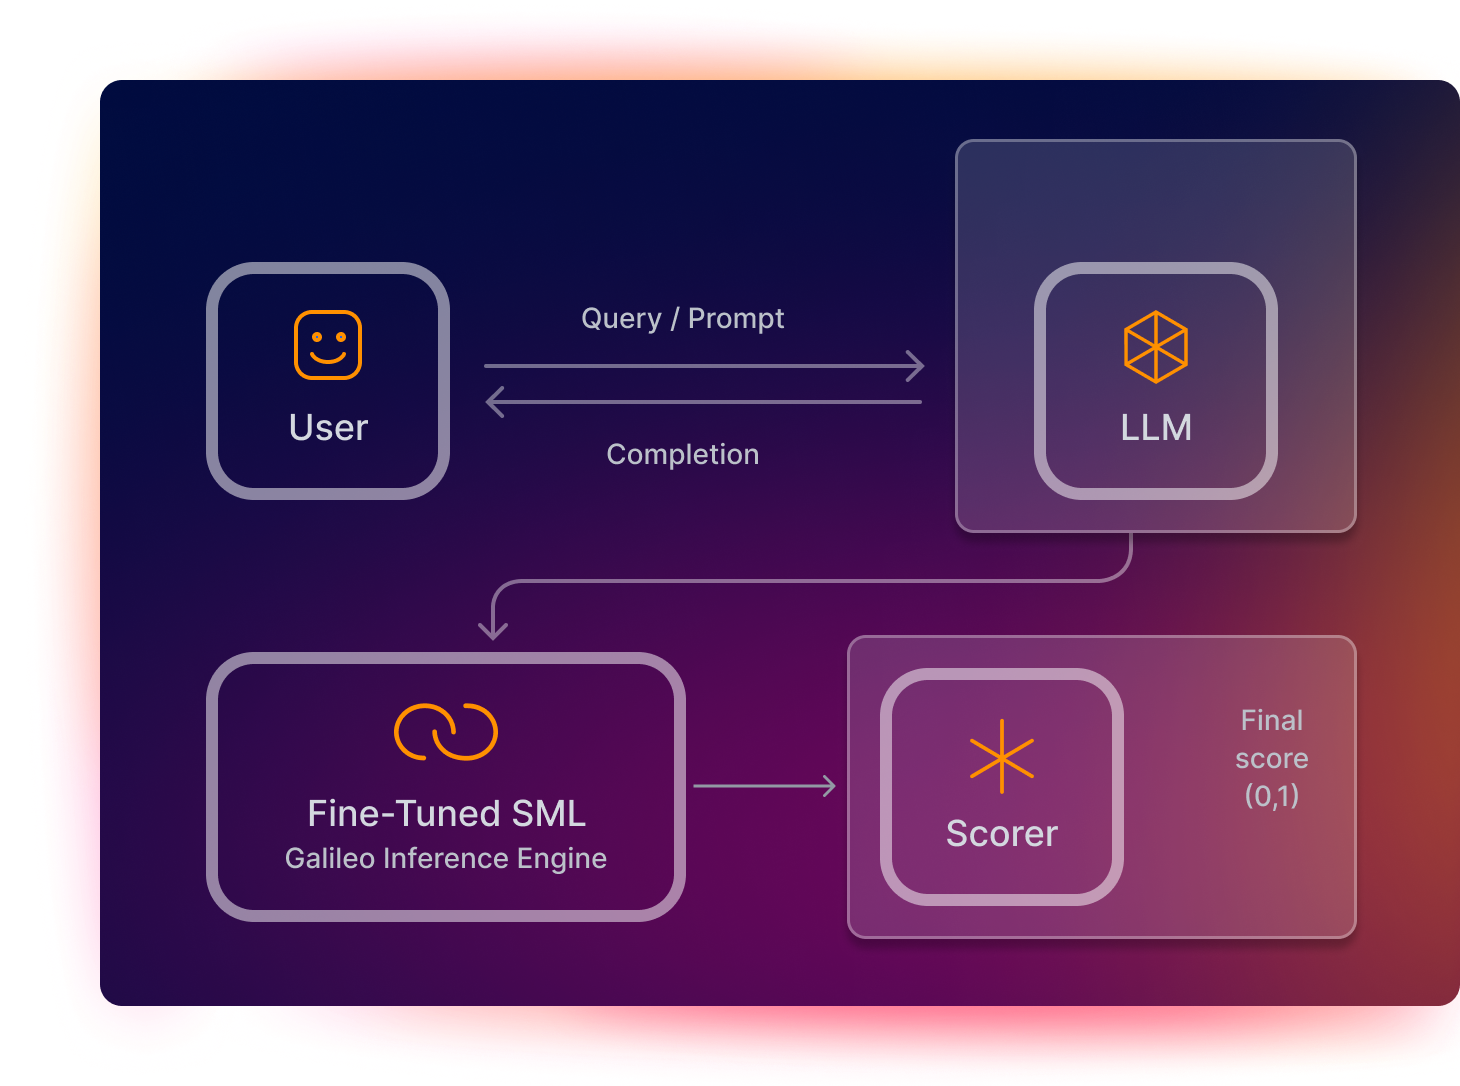
Luna délivre un verdict sous la forme d’un token unique, pour des scores rapides et reproductibles. Si vous exécutez la même entrée deux fois de suite, vous recevrez la même réponse : c’est précisément ce qui fait la fiabilité d’un modèle juge. Et comme Luna s’exécute et s’entraîne au sein de votre VPC, vos données ne franchissent jamais votre pare-feu.

Ajustez Luna à votre domaine sans code

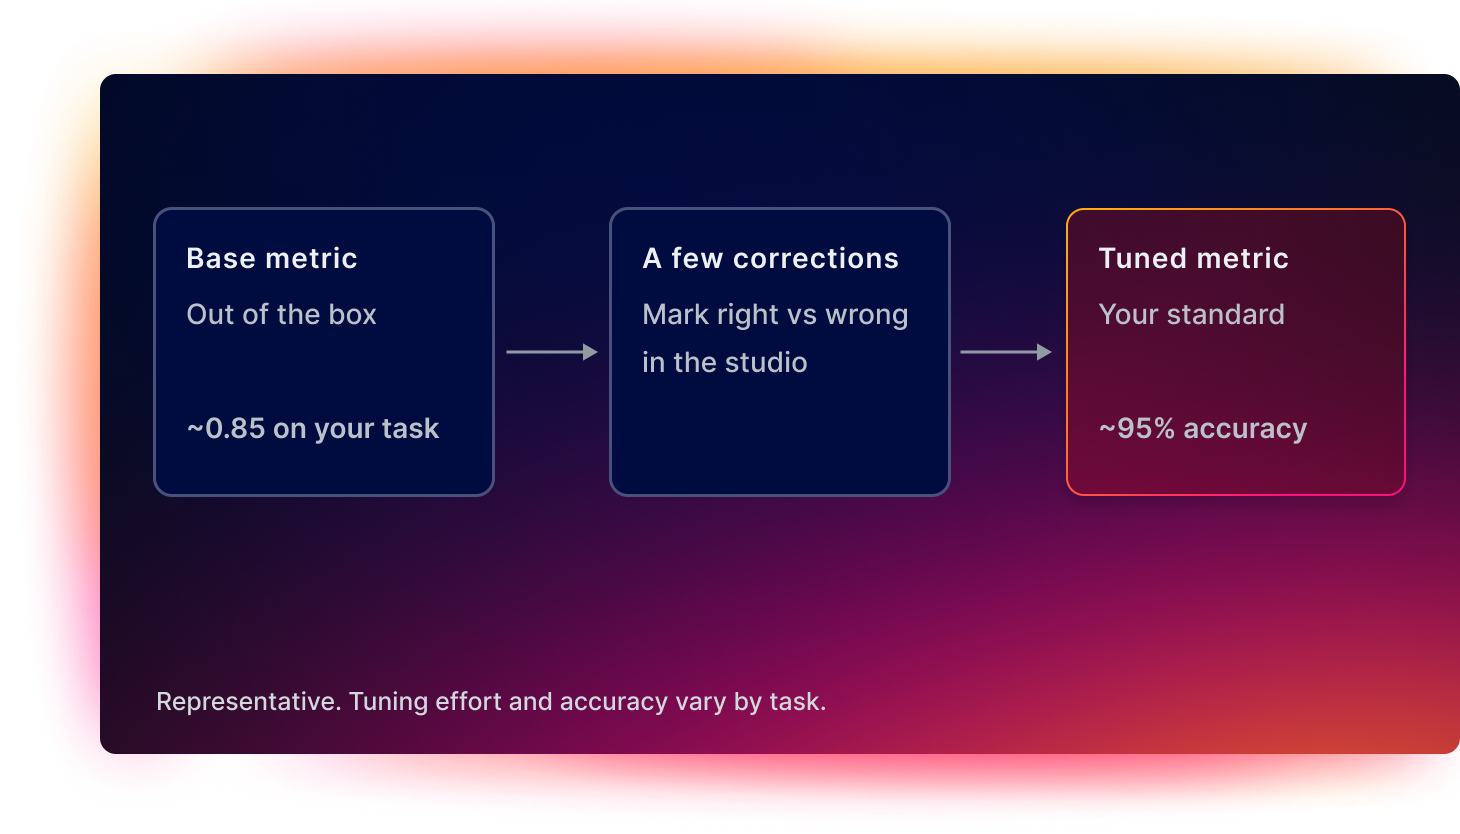
Les métriques prêtes à l’emploi vous mettent le pied à l’étrier, mais votre domaine a sa propre définition de ce qui est correct ou non. Avec Luna Studio, corrigez quelques verdicts de Luna pour lui enseigner vos standards et atteindre environ 95 % de précision sur vos propres tâches. Tout cela, sans pipeline d’étiquetage ni expertise en entraînement de modèles. Examinez, corrigez et livrez une métrique finement ajustée, tout cela dans Studio.

image promo .conf26

Regardez les présentations de .conf26 en direct

Découvrez dès maintenant les conseils des experts de Splunk et des leaders du secteur.

Regarder la diffusion

fonctionnalités

Déployez des évaluations en temps réel à grande échelle sans multiplier les coûts

Lire la documentation
Évaluez Évaluez

Évaluez toutes les interactions en production

Exécutez des évaluations continues sans le coût ni la latence des grands modèles. Les SLM ajustés Luna-2 rendent leur verdict en quelques millisecondes, au prix d’une poignée de centimes par million de tokens. L’évaluation à grande échelle en production devient réalisable.

Interceptez Interceptez

Interceptez les actions à risque avant qu’elles ne se concrétisent

Protégez les workflows agentiques avant que les erreurs ne se transforment en actions. Luna-2 évalue le choix des outils et les flux des agents en temps réel pour intercepter les comportements dangereux avant que les outils n’exécutent les tâches, plutôt que de détecter les problèmes a posteriori.

visibility-into-it-and-industrial-data visibility-into-it-and-industrial-data

Effectuez davantage de vérifications sans ralentir les agents

Évaluez simultanément différentes dimensions du comportement des agents sans ajouter des secondes de délai. Luna-2 peut exécuter simultanément 10 à 20 vérifications en moins de 200 millisecondes sur les GPU L4 : c’est ce qui permet d’appliquer des garde-fous en temps réel à grande échelle.

trafic trafic

Réduisez le coût des évaluations en production

Bénéficiez d’évaluations en production sans payer pour un LLM juge frontière à chaque interaction. Luna-2 délivre ses évaluations pour 0,12 $ par million de tokens tout en assurant un haut niveau de précision et une faible latence.

prix-et-conditionnement-adapte-aux-petits-environnements-it prix-et-conditionnement-adapte-aux-petits-environnements-it

Sachez si les agents ont bien rempli leur mission

Mesurez bien plus que la réponse finale. Luna-2 évalue les erreurs des outils, la qualité du choix des outils, la progression des actions et leur réalisation pour vous permettre de déterminer si vos agents ont bien poursuivi les objectifs de l’utilisateur.

optimize-incident-response optimize-incident-response

Déployez les métriques essentielles à votre application

Évaluez les comportements propres à votre application d’IA. Luna-2 peut prendre en charge des métriques de LLM personnalisées pour les scénarios d’utilisation de production, tandis que les adaptateurs légers permettent de déployer un modèle de base sur des centaines de métriques avec le minimum de frais d’infrastructure.


Ressources
En savoir plus sur Splunk

FAQ sur les modèles d’évaluation Luna

Luna est une famille de petits modèles de langage spécialisés dans l’évaluation. Les modèles Luna offrent un moyen rapide et économique d’évaluer et d’encadrer les interactions des agents, ce qui permet de superviser 100 % du trafic plutôt qu’un simple échantillon.

Les juges frontière ont deux défauts : le prix et la lenteur. Les équipes ne leur soumettent que 1 à 5 % du trafic, et ne peuvent examiner les actions qu’après leur exécution. Luna est conçu pour une seule tâche : juger les interactions des agents. Ce modèle est suffisamment abordable pour tout évaluer et assez rapide pour protéger vos systèmes en temps réel.

Luna réalise des évaluations et applique des garde-fous pour un coût environ 98 % inférieur à celui d’un LLM juge, ce qui change radicalement l’équation : au lieu de se rationner, les équipes peuvent superviser toutes les interactions.

Oui. Luna rend son verdict sous la forme d’un token unique, et ses scores sont déterministes : si vous exécutez la même entrée deux fois de suite, vous recevrez la même réponse. C’est précisément ce qui fait la fiabilité d’un modèle juge.

Oui. Avec Luna Studio, il vous suffit de corriger quelques verdicts de Luna pour lui enseigner vos standards et atteindre environ 95 % de précision sur vos propres tâches, sans pipeline d’étiquetage ni expertise en entraînement de modèles.

Produits connexes

Splunk Cloud Platform

Unifiez les données, le contexte et l’action, tous domaines confondus.

En savoir plus

Splunk Enterprise Security

Unifiez la détection des menaces, l’investigation et la réponse pour le SOC agentique.

En savoir plus

Splunk IT Service Intelligence

Prédisez et anticipez les problèmes informatiques avec la supervision des services pilotée par l’IA.

En savoir plus
Lancez-vous avec Luna

Un moyen économique d’évaluer et d’encadrer chaque interaction.

Demander une démonstration
Découvrir les essais gratuits