最大98%のコスト減で、経済性を向上
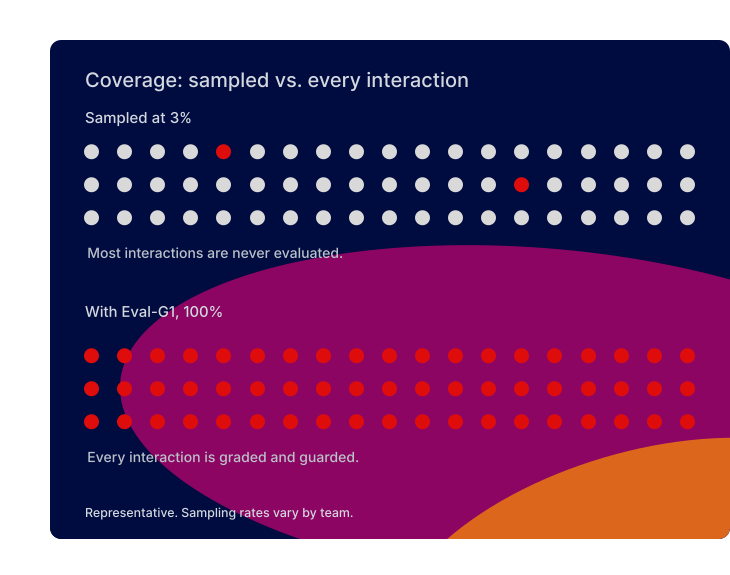
1回の評価で単一のトークンを予測します。そのため、判定のコストはフロンティアLLMによる判定と比べて最大98%低く、約0.3秒で判定が返されます。サンプリングではなく、すべてのインタラクションを評価して保護できます。
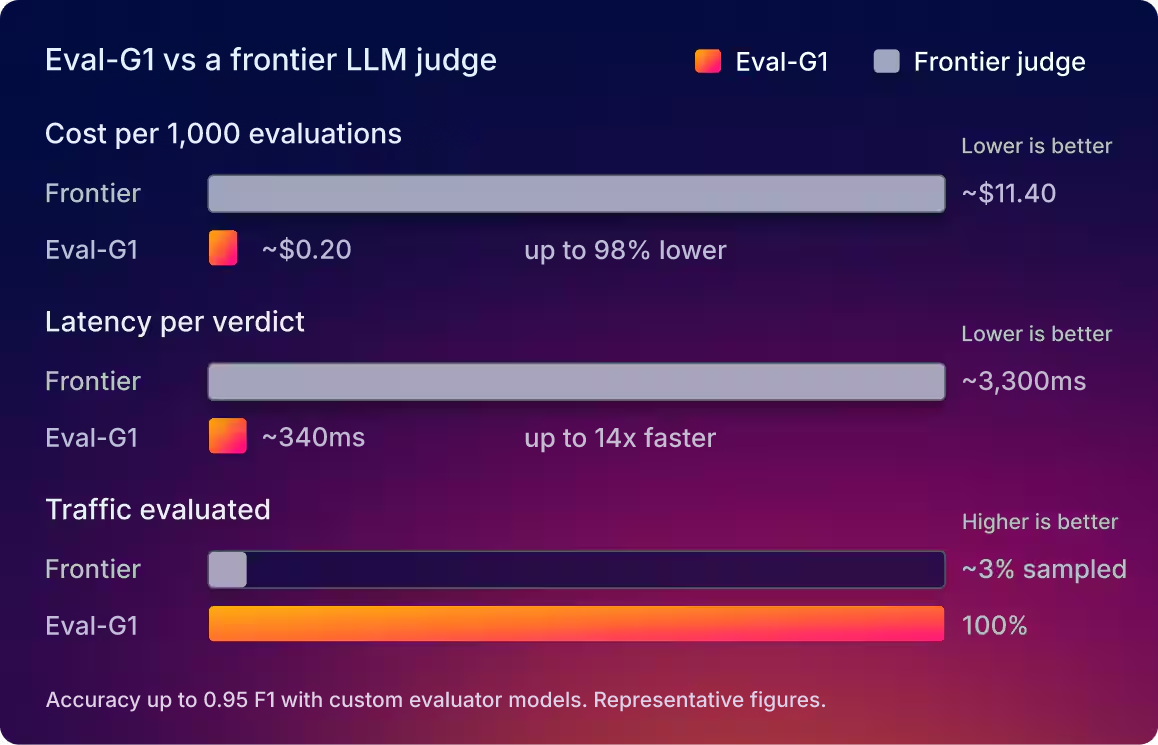
お客様のルールに合わせて調整された、評価に特化した小型言語モデルです。約0.3秒で、エージェントトラフィックの100%を評価し、ガードレールを適用します。
フロンティアLLMによる判定では、推論を書き出した後に判定を出し、多くの場合は1回の評価で数百トークンを使用します。本番環境の規模では、すべてを対象として評価するのは費用がかかり過ぎます。そのため、チームはサンプルをレビューして、残りも同じような結果になることを期待します。しかし、漏洩したアカウント番号、有害な返信、ポリシー違反など、見逃したものこそ被害をもたらすのです。
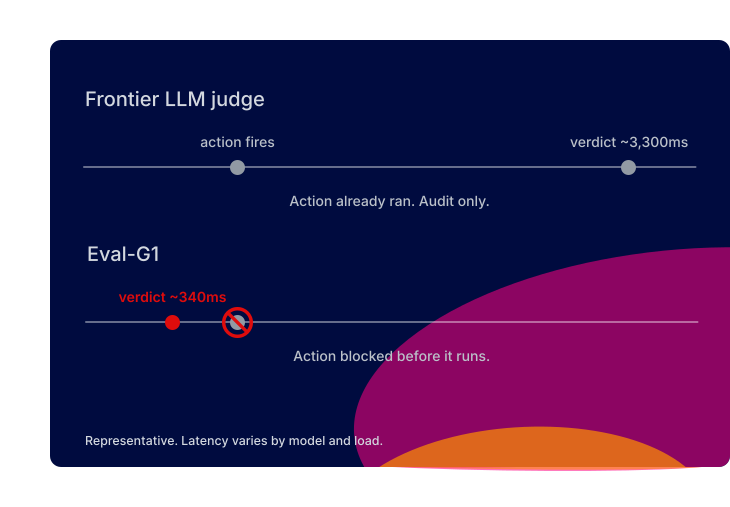
フロンティアLLMを使った評価では、判定が返されるまでに約2~5秒かかります。そのときには回答はすでにお客様に届いており、判定は過去の出来事を示すだけとなります。Eval-G1は約0.3秒で判定を返すため、最大で14倍高速です。そのため、ランタイムガードレールによって、ポリシー違反の回答が出される前に阻止できます。
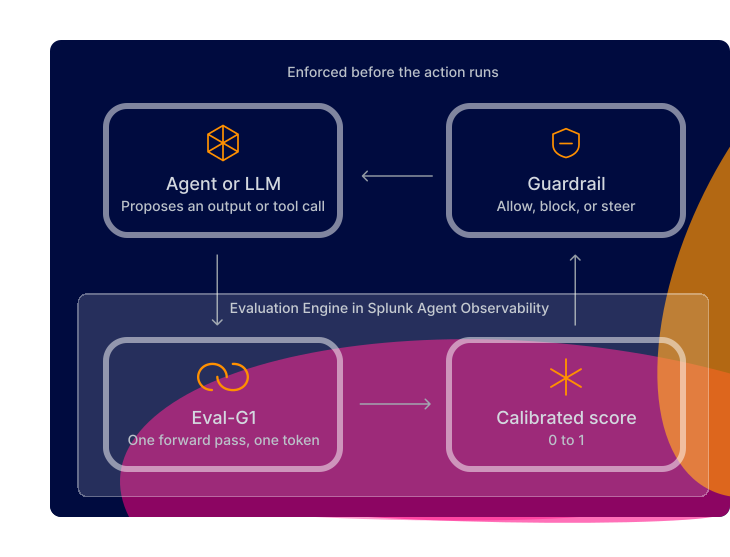
Eval-G1では、判定がキャリブレーションされた確率とともに単一のトークンとして返されるため、スコアリングは高速で、再現可能なものになります。同じ入力を2回実行しても同じ答えが返されるので、評価器としての信頼性を確保できます。
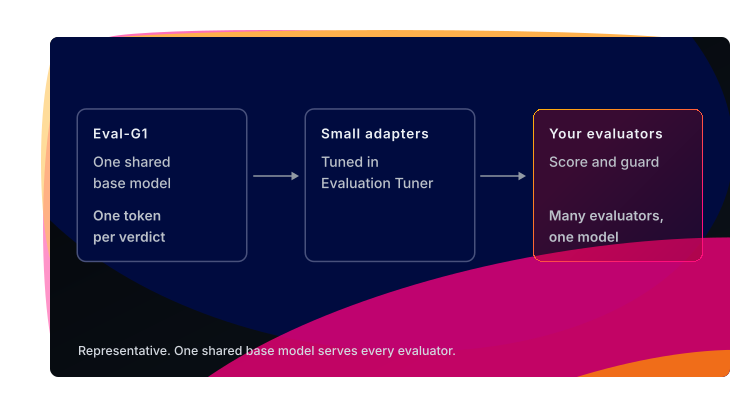
Eval-G1の評価器はすべて、1つの共有ベースモデル上の小型アダプターです。そのため、評価器を追加しても、モデルやサーバー、MLOpsチームを追加する必要はありません。Splunkがお客様のために各評価器を本番環境で実行するため、リアルタイムでスコアリングと保護を行える態勢になります。
特長

Splunk Agent Observabilityのシグナル機能が、エージェントトラフィック全体から失敗パターンを検出し、それぞれの背後にある会話まで追跡して確認します(たとえば、アシスタントがポリシーを繰り返し誤って適用しているなど)。これにより、次にどの評価器を構築すべきかを把握できます。

お客様の専門家に実際の会話を合格または不合格と判定してもらい、そのルールを簡潔な評価基準として記述してもらいます。これらのラベルが、すべての判定が従う基準となるため、このステップが最も重要となります。

評価チューナーは、お客様の専門家が作成した数十個のラベルから、数千件のトレーニングサンプルを生成します。言い換え、エッジケース、ニアミスまでカバーすることで、評価器は難しい判断にも対応できるようになります。

評価チューナーは、チームが通常の業務を続けている間に、これらの例に基づいてカスタム評価モデルを調整します。データサイエンスチーム、ラベリング用のパイプライン、モデルトレーニングに関する専門知識は不要です。

評価チューナーは、両方のモデルにとって未見の会話内容を使用して、新しい評価器とお客様のLLM判定を比較します。判定の不一致をそれぞれレビューし、お客様の基準を満たしていればその評価器を登録します。
お客様のカスタム評価器は、他の評価器とともにSplunk Agent Observabilityに表示されます。本番環境のトラフィックをスコアリングしたり、ランタイムガードレールとして実行したりできます。各判定は約0.3秒で完了します。
Eval-G1は、評価に特化した小規模言語モデルであり、お客様が調整するすべてのカスタム評価モデルのベースとなります。エージェントのインタラクションを低コストで高速に評価して保護できるため、データをサンプリングすることなく、合理的なコストでトラフィックを100%監視できます。
フロンティアLLMによる評価は、高コストで遅くなります。そのため、トラフィックの1~5%をサンプリングすることになり、しかもアクションが実行された後にレビューするだけとなってしまいます。Eval-G1は、エージェントのインタラクションを評価するという1つの作業のために構築されているので、すべてを評価できるくらいコストは低く、リアルタイムで保護できるくらい処理は高速です。
Eval-G1で評価とガードレール適用にかかるコストは、フロンティアLLMによる判定と比べて最大98%低くなります。これによって経済性が変わり、対象を制限することなくあらゆるインタラクションを評価できるようになります。
はい。Eval-G1では判定が単一のトークンとして返されるため、スコアは決定論的です。同じ入力を2回実行しても同じ答えが返されるので、モデルによる評価の信頼性を確保できます。
はい。評価チューナーでは、お客様の専門家が実際の会話にラベルを付け、ルールを記述します。評価チューナーはこれらのラベルをカスタム評価モデルに変換し、データサイエンスチームやモデルトレーニングの専門知識がなくても、最大0.95のF1スコアを達成できます。
© 2026 Cisco Systems, Inc. およびその関連会社。無断複写・転載を禁じます。