エージェントトークノミクスとは?
Artificial Intelligence Pratik Bhavsar主なポイント
- エージェントのコストは、ステップごとに膨れ上がっていきます。各ステップでは、ステートレスなAPIが使用されるため、同じ指示、スキーマ、履歴が繰り返し送信されます。そのため、15語程度のリクエストでも、タスクが完了するまでに課金対象のトークンが数万にも及んでしまう可能性があります。
- トークンを5つのカテゴリに分けることで、それらが実際に何に使われたかを知ることができます。すべてのトークンをコンテキスト、推論、検索、調整、ガバナンスに分類することで、請求書に内訳が記載されていなくても、どの支出がタスクの推進に寄与し、どの支出が純粋なオーバーヘッドであったかを正確に把握できるようになります。
- 何をもって成果とみなすかについての基準を設定し、その達成に要する実際のコストを追跡しましょう。その際には、トークンだけでなく評価のコストも含める必要があります。
これは実際に今月あった例ですが、あるエージェントがわずか15語のユーザーリクエストを処理したところ、最終的に6万のトークンを消費することになりました。これらのトークンのうち62%は、すでにモデルに送信されているコンテキストを再読み込みしたものでした。さらに、エージェントが一度も使用しなかったツールスキーマに割り当てられたトークンが3,000もありました。
企業のAI支出は大幅に増加しています。2024年には1社あたり120万ドルであった支出が、2026年には700万ドルにまで上昇しています。一方で、同時期にトークンあたりのAPI価格は約280分の1に下落しています。単価が下がったにもかかわらず、トークンの消費量は劇的に増加しているのです。Uber社は、2026年分のClaude Codeの予算を4月までにすべて使い果たしてしまいました。多くのチームでは、依然としてチャットボット時代のコストモデルに基づいた予算編成が行われています。このモデルでは、1回のプロンプトが1回の呼び出しに相当するとされますが、エージェントの登場によってその前提は崩れました。そのため、この計算方法を見直す必要があります。
シスコのJeetu Patelが、Cisco Live 2026において指摘したところによれば、トークンのコストと実際にトークンが生み出す価値が乖離し始めたときにこそリスクが生じます。したがって、その乖離を可視化して把握することが極めて重要です。トークンの生成コストは大幅に低下しましたが(例えば、12~18カ月間で1000分の1)、トークンの消費量は指数関数的に増加しました(1万倍から10万倍)。
この消費量を可視化して把握するための方法として、Patelはトークノミクスに対するスタックレベルでのアプローチについて説明しました。つまり、GPU層での利用率、モデル層でのパフォーマンス、アプリケーション層でのタスク完了、エージェント層での挙動を測定するアプローチです。そしてエージェント層が「最も難しい部分」であると指摘しました。Patelによれば市場はまだ第1段階にあります。トークンを適切に管理するためには、今後企業がトークンの支出に精通していく必要があります。こうしたトピックへの理解を深めることが、このシリーズの目的です。
エージェントトークノミクスとは?
簡単に言えば、エージェントトークノミクスとは、エージェントシステムにおけるトークンの流れを分類および管理するための方法論です。トークンはAIの知能を働かせるための運転資金の役割を果たします。計算資源を消費し、AIによるあらゆる作業単位のコストを決定づけます。重要なのは、どのトークンがタスクの推進に寄与し、どのトークンが信頼性構築に貢献し、どのトークンが無駄に消費されているかということです。
トークンの種類
エージェントの呼び出しに含まれるすべてのトークンが、以下のカテゴリのいずれかに分類されます。この分類が、その後に行う最適化のためのあらゆる意思決定の基礎となります。
コンテキストトークン
コンテキストトークンとは、システム指示、会話履歴、ツールスキーマなどを指します。すべての呼び出しに付随するあらゆる情報です。これには、安全ポリシーやタスク状況などの必要な情報もあれば、オーバーヘッドとなる無駄な情報もあります。例えば、そのタスクでは使用しないツールのスキーマや、すでに重要性を失ったステップにおける古い会話のやり取りなどがこれに該当します。スタンフォード大学デジタル経済研究所の調査では、エージェントの推論コストの62%が、再送信されたコンテキスト情報に起因することが判明しました。その62%に含まれる無駄な情報の具体例としては、無関係なスキーマ、古くなった履歴、キャッシュすべきなのにそうされていない固定的なプレフィックスなどが挙げられます。
推論トークン
推論トークンは、AIモデルが計画、思考の連鎖(Chain of Thought)、中間ステップのために思考する際に生成されます。複数のステップを要する複雑な問題についてはより優れた結果につながりますが、単純な問題では無駄なコストを生じさせるため、現在ではほとんどのAPIで、推論モデルの呼び出しごとに推論の深さを調整できるようになっています。
検索トークン
検索トークンはRAGの過程で発生します。RAGは、モデルが事実に基づいた回答を生成できるように、関連データを取り込む手法です。取得するデータが少なすぎるとハルシネーションが発生します。データが多すぎるとコンテキストにノイズが混入し、それを補正するために、モデルが追加の推論ループを実行することになります。また、取得したコンテキストが長大になると、コンパクション(圧縮)の回数が増えることもあり、その過程で有用な情報が失われるリスクが高まります。
ツールトークン
ツールトークンは、モデルがツールを呼び出し、ツールが返した値(APIレスポンス、データベース行、検索結果、関数出力など)を読み取る過程で生成されます。呼び出しそのものは安価ですが、応答は巨大になる可能性があります。その巨大な応答がコンテキストウィンドウに取り込まれ、ループにおけるそれ以降のすべてのステップに引き継がれます。
調整トークン
調整トークンは、マルチエージェントシステムにおいて発生する、役割定義プロンプト、同期メッセージ、共有ステートなどのトークンです。これらによって専門性を高めることができますが、トークンが急速に肥大化します。ある時点を超えると、エージェント間のやり取りのオーバーヘッドが、複数のエージェントに作業を分担させるメリットを上回ります。
ガバナンストークン
ガバナンストークンは、検証、セキュリティチェック、評価、人間によるレビューのトリガーに関するトークンです。請求書にはほとんど現れない項目であり、そのためにわざわざ予算が計上されることもありません。
目標は、どのカテゴリがコストに見合うメリットを生み出し、どれが純粋なオーバーヘッドとなっているかを把握することです。これを見極めることが、単なる推測に頼った運用と、真に有効な最適化戦略の分かれ目となります。
トークンのコスト
トークノミクスの観点から、ある1つの呼び出しについて詳しく見てみましょう。ユーザーは、「check if this customer's last three orders are eligible for a refund (この顧客の直近3件の注文が返金の対象となるかどうかチェックして)」という12単語からなるリクエストを入力します。
システムは、1,500のコンテキストトークンからなるシステム指示を送信します。さらに、このタスクとは無関係なツールを含むツールスキーマの3,000のコンテキストトークンと、顧客データの検索トークン2,500がこれに加わります。ユーザーが入力したわずか20トークンのメッセージは、モデルがまだ何も生成していない段階で、7,000もの入力トークンになっています。
これに対して出力は、推論、1回のツール呼び出しと最終出力で約3,000トークンになります。
エージェントはさらにループします。すべてのAPI呼び出しはステートレスであるため、すべての情報を含んだコンテキストがステップごとに再送信されます。2回目の呼び出しは1万トークン。3回目は1万3,000。4回目はこれにツールの結果が加わって1万7,000。5回目の呼び出しまでに、モデルは同じコンテキストを4回も再処理しており、コンテキストウィンドウは、モデルがそれまでのステップで処理済みの情報でいっぱいになっています。
本来なら1万トークン未満のコストで済むはずだった5ステップからなる作業が、最終的に4万トークン超を消費することになってしまいました。
LeanOps社が、本番環境でエージェントを運用している30のエンジニアリングチームを調査したところ、同じチーム内で同様の作業を行っている開発者の間でも、最も低コストな場合と最も高コストな場合とで20倍もの開きがあることが分かりました。ある企業では、トークン支出を分類してアーキテクチャを変更した結果、コストの月額が8万7,000ドルから2万4,000ドルに減少しました。節約できた費用はすべて、これまで全く注目されることも分類されることもなかったオーバーヘッドの削減によるものです。さらに驚くべきことに、削減しても開発ペースは変わりませんでした。
エージェントトークノミクスのメトリクス
トークン効率とは、100万トークンあたりにどれだけの品質が達成できたかを示す指標です。ワークフローにとって何が重要な品質基準となるかは、ユーザーが自分で選択します。サポートエージェントの場合であれば、それはタスクが完了し、ハルシネーションが許容範囲内に収まり、人間の担当者へのエスカレーションの必要が生じなかったことを意味するかもしれません。セッションが成功とみなされるのは、必須項目としてマークしたすべての基準が満たされた場合のみです。トークン効率は100万トークンあたりの成功セッション数で表されます。何をもって「成功」とするかはユーザーの評価基準によって決まるため、基準が定まってはじめて数値が意味を持ちます。返金照会と要約は異なるワークフローであるため、それぞれに基準を設定し、トークン効率を個別に算出します。
これとは別に、「承認されたタスク1件あたりのコスト」は、良好な成果を達成したタスクの実際のコストを表します。計算方法は以下のとおりです。
承認されたタスク1件あたりのコスト = モデルのコスト + ツールやランタイムのコスト + 人間によるレビューのコスト
低価格なモデルで稼働しているサポートエージェントの1タスクあたりのコストが0.02ドルだったとします。これは非常にコスト効率の良いモデルに見えます。しかし、仮に回答の40%が人間の手によるレビューを必要とするとしましょう。レビュー1件あたりには15分かかり、サポートスタッフの人件費が時給30ドルだとします。こうしたレビューが必要な回答では、実際のコストは約3.02ドルとなります。レビューを必要としないタスクのコストは0.02ドルですが、レビューの必要なタスクも加味したコストは、請求金額をはるかに上回ります。
トークノミクスの始め方
いきなりモデルを切り替えたり、コンテキストを削減したりするところから始めてはいけません。まずは、現状で把握できる数字から着手しましょう。
完全なカテゴリ分けは出発点ではなく、あくまで最終目標です。推論トークンと検索トークンを区別するには高い粒度が必要となり、ほとんどのチームはまだそれを備えてはいません。したがって、すでにあらゆるAPIレスポンスが提供している情報、つまり呼び出しごとの合計入力トークン数と出力トークン数から着手しましょう。
悪影響の最も大きい要因を見つけ出し、追跡精度が向上するにつれて、より細かい区分を追加するようにします。
無料でできるトークノミクスのチェック
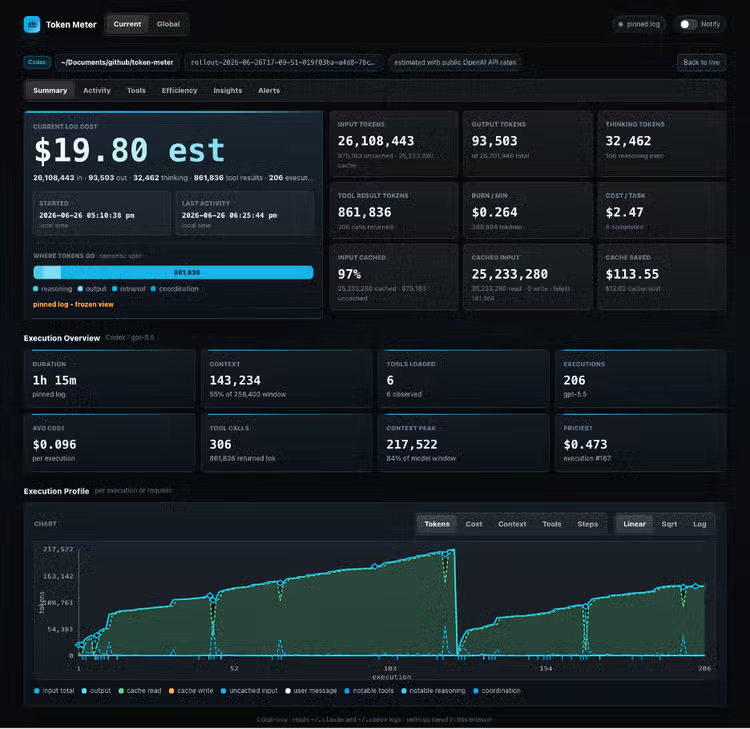
コーディングにClaude CodeまたはCodexを使用しているなら、これらの数値をリアルタイムで確認できます。Galileo Agent Labsが提供するオープンソースツールであるToken Meterは、ローカルエージェントのログを監視し、実行時のコストをユーザーマシンのダッシュボードにストリーミング配信します。これは完全にローカルで動作し、APIキーもテレメトリも使用しないため、システムの変更を行う前にトークンがどこで消費されているかを低リスクで確認できます。長時間を要するタスクの次回実行時にこのツールで監視し、どのカテゴリのトークン消費量が増えていくか観察してみてください。
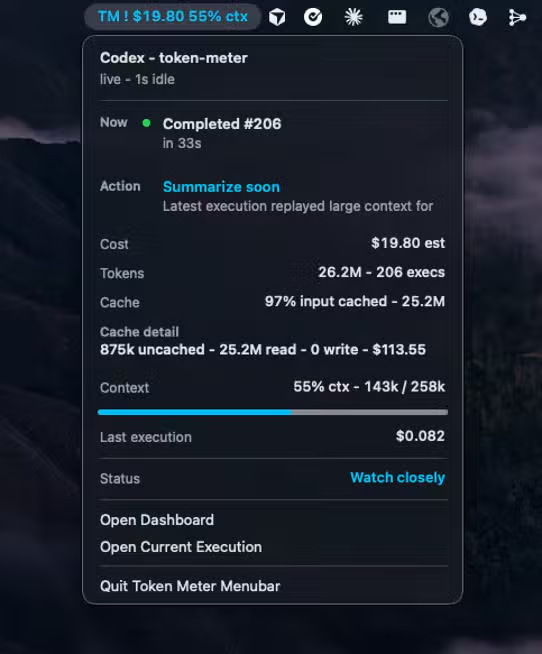
Token Meterのメニューバーウィジェットは、ダッシュボードの内容を簡単に確認できる補助ツールです。macOSのメニューバーに常駐し、アクティブなエージェントセッションの状態を一目で確認できます。
Splunk Agent ObservabilityのWebサイトで詳細を確認し、Splunk Observability Cloud Free Editionを今すぐ実際にお試しください。