
Machine Data Lake
より多くのマシンデータをすぐ活用できる状態で保持
ペタバイト規模のマシンデータを低コストかつ完全忠実な状態で保持し、その場所でサーチを行えます。高速な処理が必要になったときは、重要なデータのみをSplunkインデックスに移します。
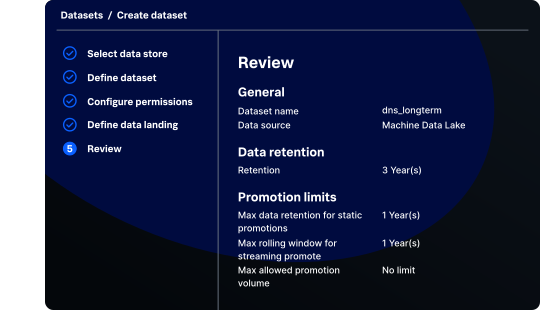
忠実度を維持しながら、より多くのデータを保持
将来の調査や分析、AIでの活用に必要となる生データの詳細、ガバナンス、コンテキストを維持しながら、ペタバイト規模のマシンデータを低コストな環境に保持します。
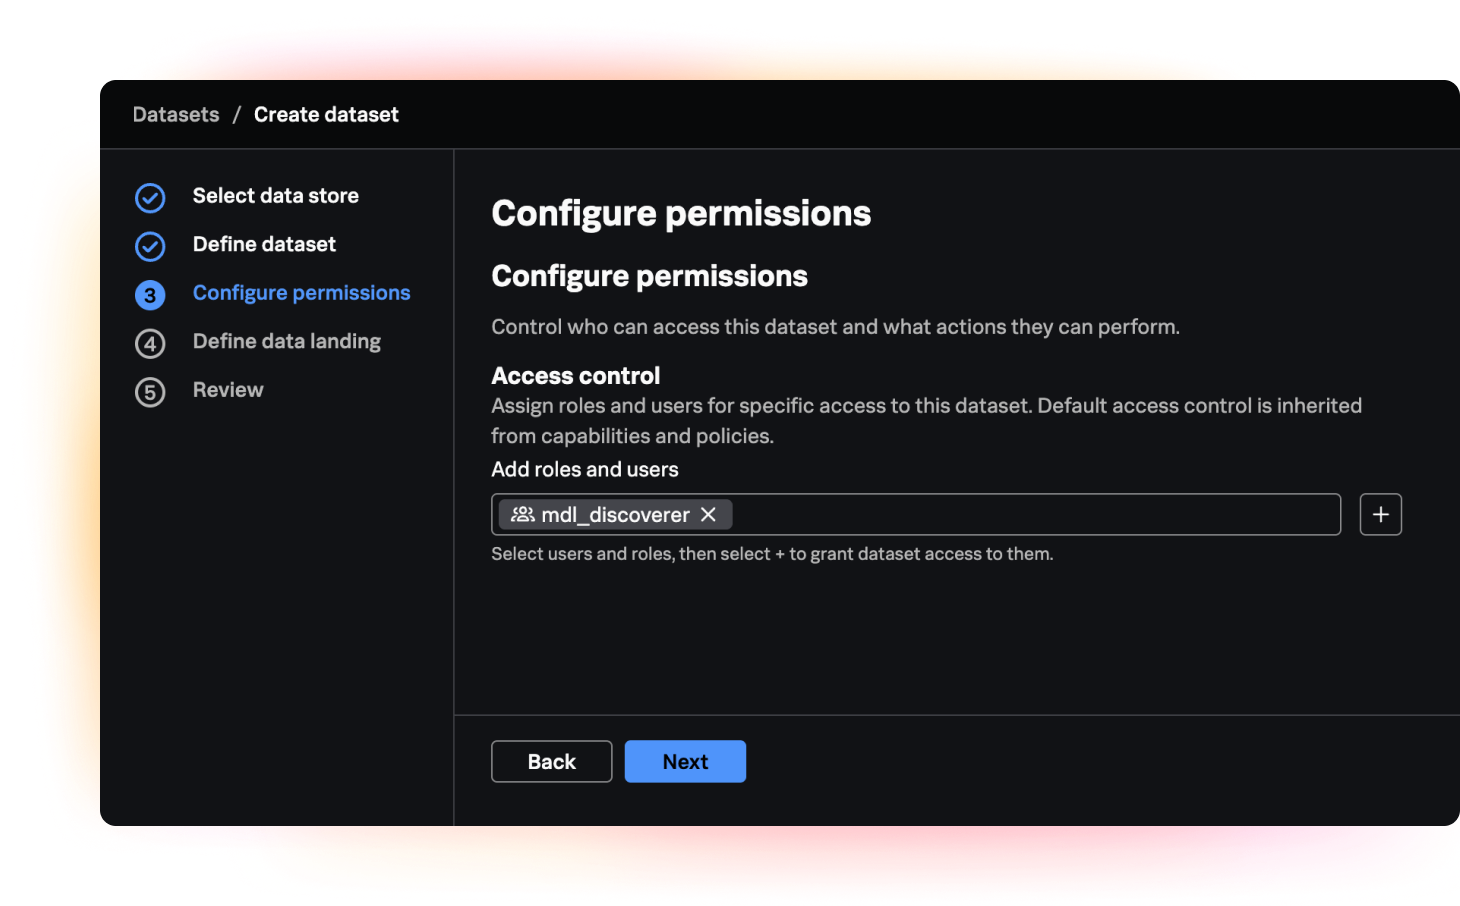
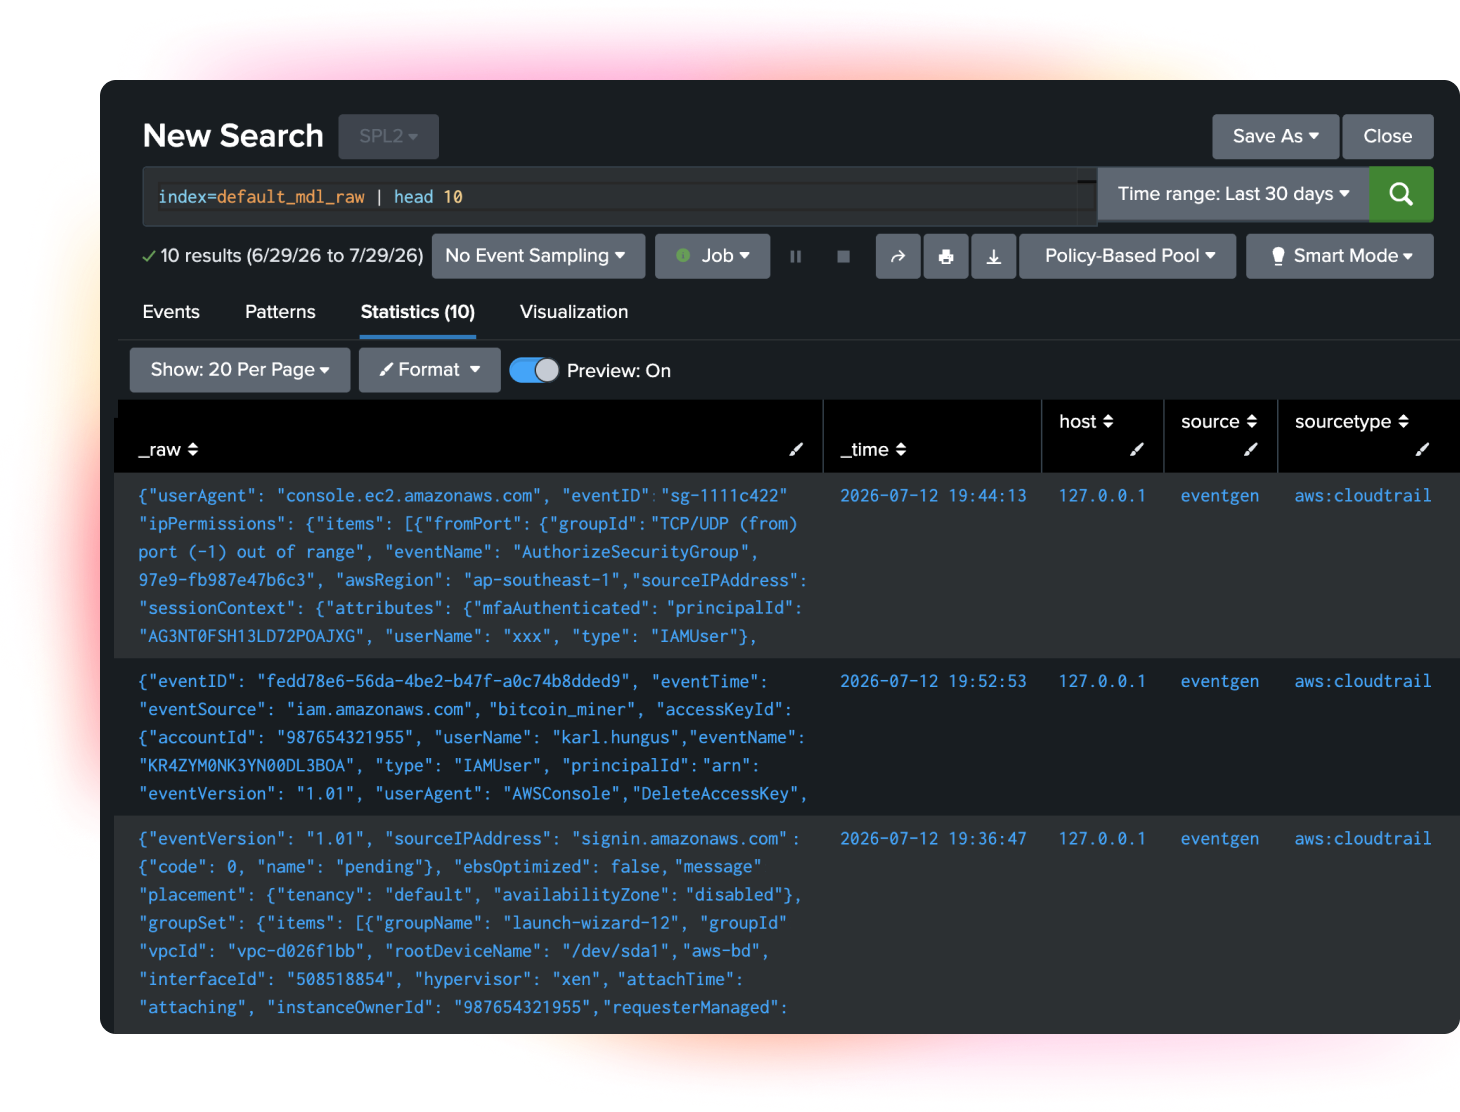
データの把握とサーチをデータの保存場所で実行
Splunk Catalogを使用して、保持しているマシンデータを把握、理解、管理します。さらに、統合サーチを使えば、データをあらかじめSplunkインデックスに移したり複製したりすることなく、その場でクエリーを実行できます。
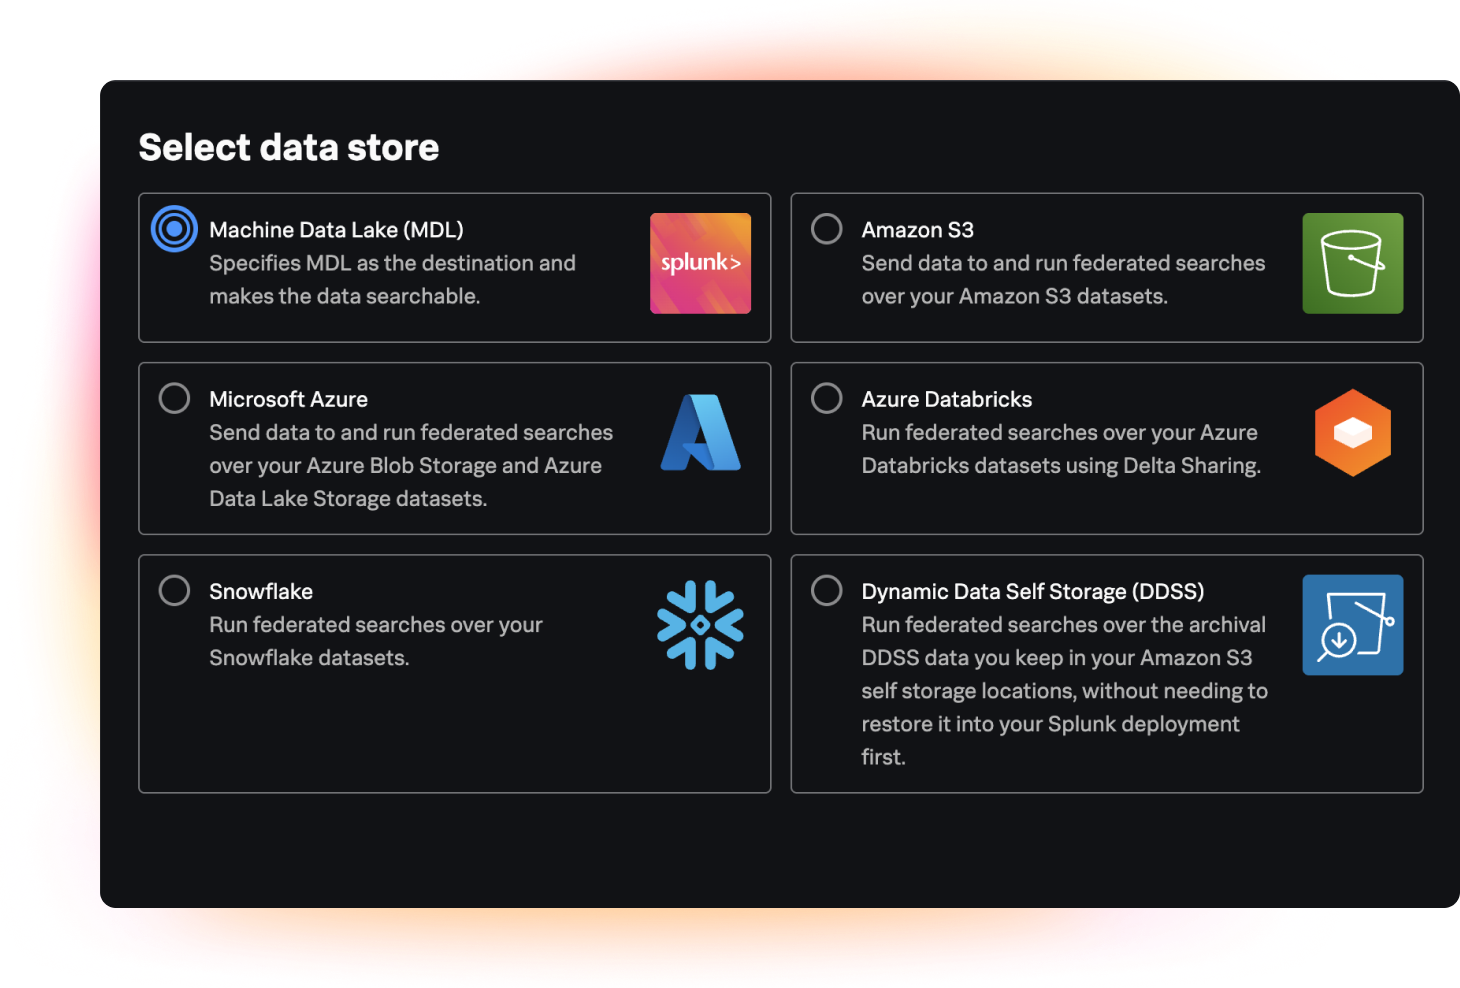
高速な処理が必要な場合はデータをインデックス化
選択したデータをSplunkインデックスに移して、高性能な分析、リアルタイム検出、ダッシュボード、アクティブなワークフローに活用できるようにしながら、元のデータを完全忠実な状態で保持します。
Machine Data Lakeに関するよくある質問
Machine Data Lakeは、ペタバイト規模のマシンデータを低コストかつ完全忠実な状態で保持するように設計されたSplunk環境です。データを把握可能かつ保存された場所でサーチ可能な状態に維持すると同時に、高性能が求められるワークフローで必要となったときにデータをSplunkインデックスに移せる状態にしておきます。
はい。SPL2と統合サーチを使えば、保持されているデータに対してその場でクエリーを実行できます。Splunk Catalogにより、チームはサーチ、調査、分析、AIワークフローにデータを活用する前に、利用可能なデータを把握、理解、管理できます。
Machine Data Lakeにより、マシンデータを保存する場所や、高性能が求められる利用のためにデータをインデックス化するタイミングをより細かく制御できます。量が多く利用頻度が低いテレメトリを低コストの環境に保持できるため、すべてのデータセットを継続的にインデックス化する必要がありません。
Machine Data LakeとSplunkインデックスは、それぞれ補完的な役割を担います。Machine Data Lakeは、データを低コストかつ完全忠実な状態で保持し、保存された場所でサーチするために使用します。リアルタイム検出、ダッシュボード、高性能な分析、またはアクティブなワークフローでデータが必要になった場合は、選択したデータをSplunkインデックスに移します。
Machine Data Lakeは、完全忠実な過去のマシンデータを保持しており、AIにとって価値のあるコンテキストを提供できます。Splunk Catalogを使用してデータを把握、理解、管理しながら、保存された場所でのサーチやデータのインデックス化によって、分析や調査、AIドリブンなワークフローで必要な情報を利用できるようになります。
