splunk background

Bewertung

Agenten- und Modellbewertung

Bewerten Sie die Richtigkeit, Sicherheit und Tool-Nutzung jeder Agenteninteraktion in der Produktion – nicht nur einer Stichprobe.

Free Edition Holen Sie sich Observability Cloud für bis zu 15 Hosts kostenlos.
Produkt-Tour starten 5 Minuten Zeit? Jetzt die wichtigsten Funktionen kennenlernen.
pd-ao-eval-hero-d

Probleme finden, bevor sich diese auf Ihre Kunden auswirken

Mit einem kleinen Modell statt einem Frontier-LLM als Judge ist die Beurteilung jeder Interaktion erschwinglich. Ganz ohne Stichproben und Erkennungslücken.

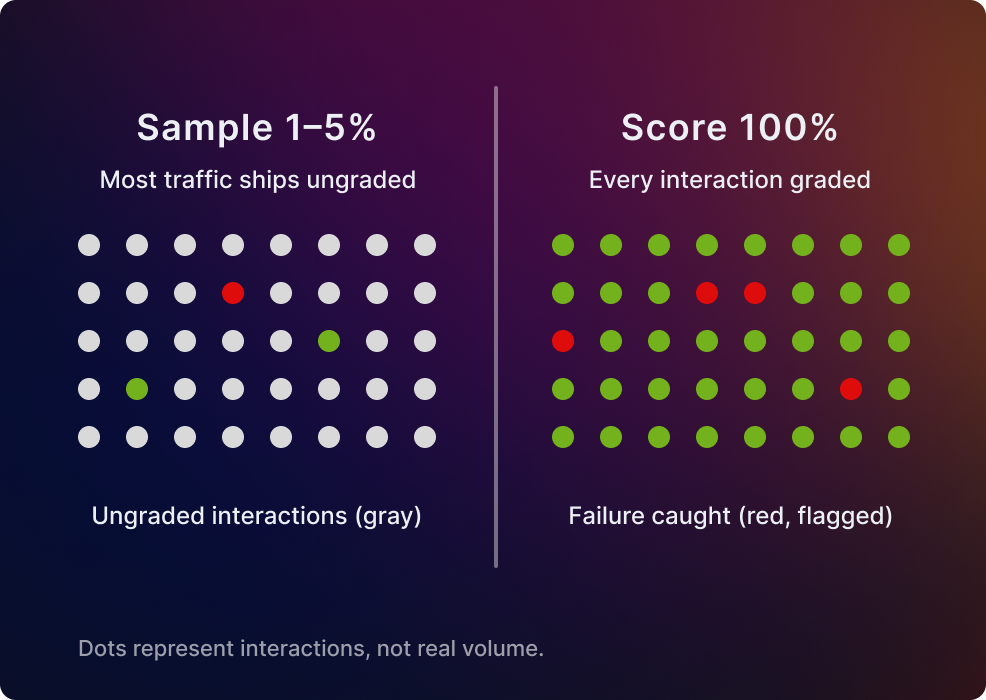
Bewerten jeder Agenteninteraktion, nicht nur von Stichproben

Da es sich bei Luna nicht um ein Frontier-LLM, also einem LLM an der Spitze der technologischen Leistungsfähigkeit, sondern um ein kleines Modell handelt, ist es kostengünstiger, jede Anforderung in der Produktion zu bewerten, anstatt nur zufällige Stichproben. So können Sie Korrektheit, Sicherheit und Tool-Nutzung bei 100 % des Datenverkehrs bewerten.

Evaluatoren an spezifische Kriterien anpassen

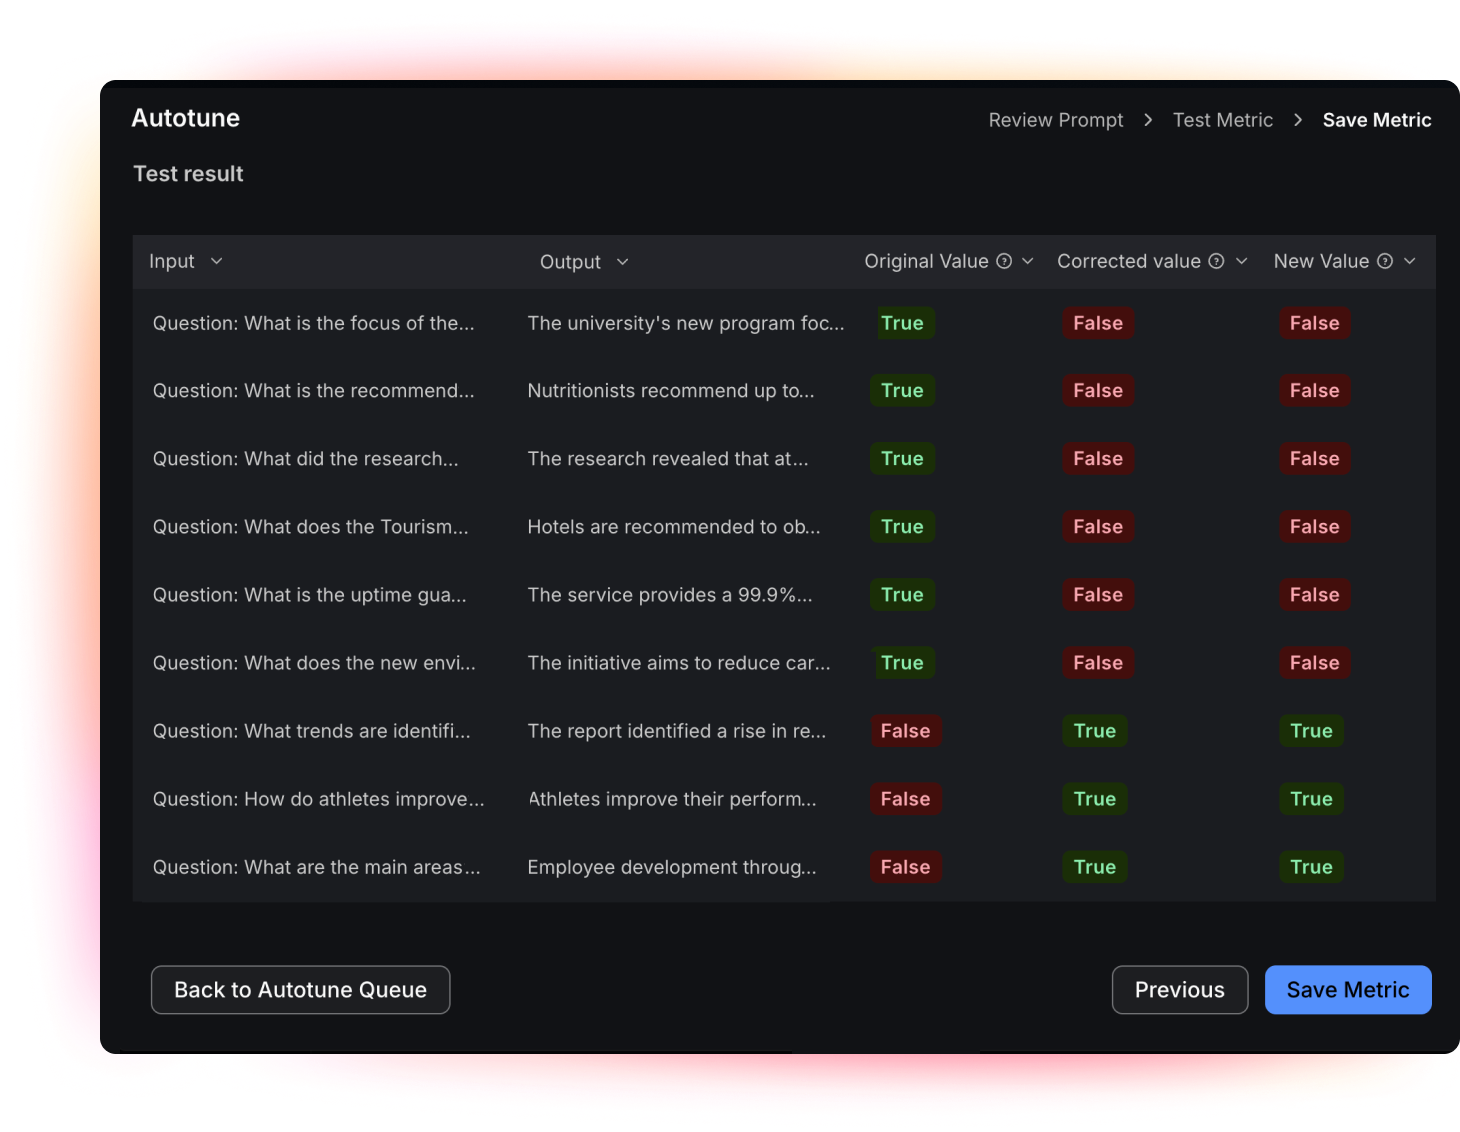
Vorkonfigurierte Metriken entsprechen selten dem, was in einem spezifischen Fachgebiet als gute Antwort gilt. Bei der automatischen Optimierung mit Autotune passt sich der Evaluator an Ihren Standard an, anstatt einen generischen Standard zu verwenden. Dadurch spiegeln die Bewertungen wider, wie Ihr Team die Arbeit tatsächlich beurteilt.

Bewerten Sie neben Latenz, Fehlern und Kosten auch die Qualität

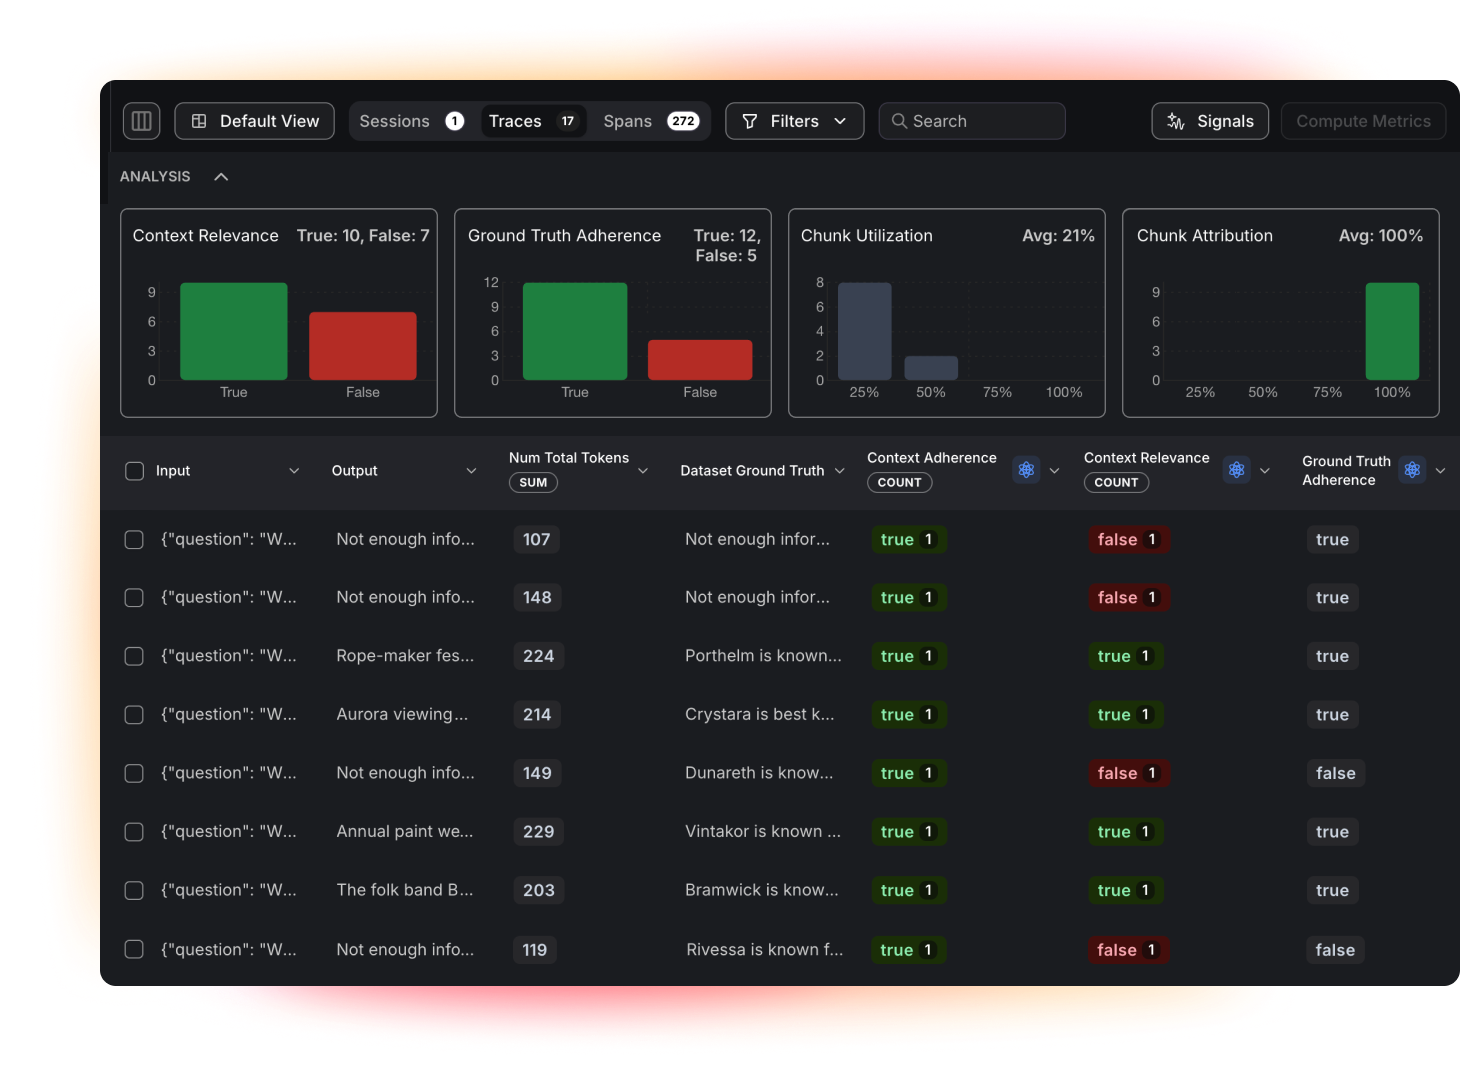
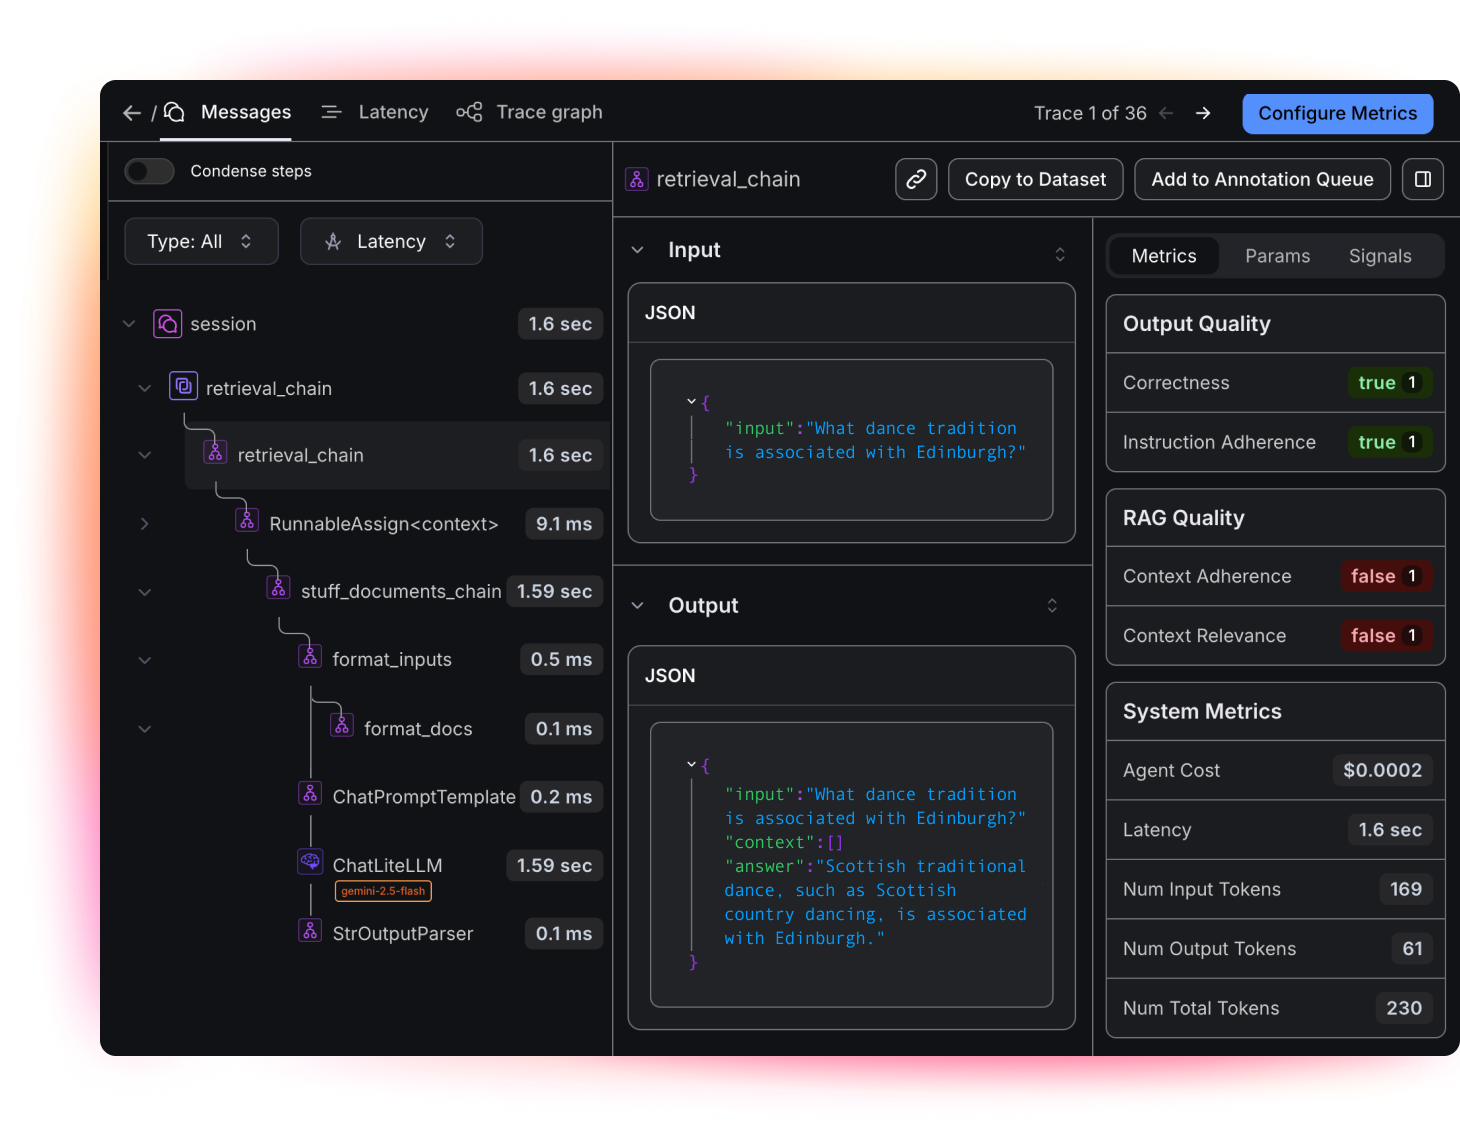
Jede Bewertungsnote wird im gleichen Trace wie Latenz, Fehler und Token-Kosten angezeigt. So sehen Sie nicht nur, dass eine Antwort falsch war, sondern auch, wie viel sie gekostet hat und wie lange sie gedauert hat. Sie bekommen also eine zentrale Sicht auf Qualität und Leistung, statt vier separater Tools.

.Conf 26 promo image

Keynotes der .conf26 live ansehen

Sichern Sie sich einmalige Insights der klügsten Köpfe bei Splunk und führender Branchenexperten.

Jetzt streamen

Funktionen

Sicherstellen, dass Agenten richtig funktionieren – vor und nach der Auslieferung

Dokumentation kennenlernen
continuous-auditing continuous-auditing

Bewerten der Schwächen von Agenten

Bewerten Sie Aktionsabschluss, Tool-Auswahl, Halluzinationen, RAG-Einhaltung und mehr. Verwenden Sie vorkonfigurierte Metriken oder definieren Sie eigene Kennzahlen und zeigen Sie die Bewertungen in einem Trace neben Latenz, Fehlern und Kosten an.

Blog Blog

Inline-Optimierung eines Evaluators ohne Data Scientist

Korrekturen an einer falschen Bewertung sind direkt im Trace möglich, und Autotune aktualisiert den Evaluator damit. So müssen keine Projekte erstellt oder Aufgaben an das Prompt-Engineering-Team übergeben werden. Bei etwa fünf Beispielen liegt die Richtigkeit bei rund 95 %, mit Sprüngen um 10 bis 17 Punkte nach dem Formel 1-System.

real-time-performance real-time-performance

Durchführen von Experimenten und A/B-Tests

Vergleich von Prompts, Modellen und Agentenversionen anhand derselben Bewertungen vor der Produktion. Stellen Sie fest, welche Änderung die Richtigkeit und Tool-Nutzung tatsächlich verbessert hat, anstatt anhand von Stichproben nur raten zu können.

reduce-cyber-security-threats reduce-cyber-security-threats

Vertrauenswürdige Bewertungen werden zu Leitplanken

Eine Bewertung, die bei Tests zuverlässige Ergebnisse liefert, wird in der Produktion zur Kontrolle. Weiten Sie sie zur Laufzeitprüfung aus, die die fehlerhafte Aktion blockiert, bevor das Tool ausgeführt wird.
Informationen zu Leitplanken


Ressourcen
Mehr von Splunk

Was ist Evaluierungs-Engineering?

Blog-Beitrag lesen

Agentenbewertung – FAQs

Bei der Agentenbewertung wird beurteilt, was ein Agent tatsächlich getan hat: vom Abschluss von Aktionen über die Tool-Auswahl bis hin zu Halluzinationen und der RAG-Einhaltung. So kann man feststellen, ob sich der Agent richtig verhalten hat, anstatt anhand von Stichproben nur raten zu können.

Bei der Stichprobenuntersuchung bleibt der Großteil des Datenverkehrs unbewertet, und Fehler, die bis zum Kunden gelangen, liegen meist genau in dem Teil, der nicht überprüft wurde. Da der Judge ein kleines Modell und kein Frontier-LLM ist, ist es erschwinglich, jede Interaktion zu bewerten – und nicht nur einen zufälligen Ausschnitt.

Ja. Mit Autotune können Sie eine Handvoll von Bewertungen direkt im Trace korrigieren, und der Evaluator passt sich an Ihren Standard an , ohne dass Projekte erstellt oder Aufgaben an das Prompt-Engineering-Team übergeben werden müssen.

Eine Bewertung, die bei Tests zuverlässige Ergebnisse liefert, kann zu einer Laufzeitprüfung weiterentwickelt werden, die die fehlerhafte Aktion blockiert oder reguliert, bevor das Tool ausgeführt wird. So muss kein separates Modell für die Richtigkeitsprüfung unterhalten werden.
Ja. Sie können Experimente und A/B-Tests ausführen, die Prompts, Modelle und Agentenversionen mit denselben Bewertungen vergleichen. So lässt sich feststellen, welche Änderung die Richtigkeit verbessert hat.

Ähnliche Produkte

Splunk Cloud Platform

Daten, Kontext und Aktionen domänenübergreifend vereinheitlichen.

Mehr erfahren

Splunk Enterprise Security

Einheitliche Bedrohungserkennung, -untersuchung und -reaktion (TDIR) für das agentenbasierte SOC.

Mehr erfahren

Splunk IT Service Intelligence

IT-Probleme mit KI-gestütztem Service-Monitoring prognostizieren und verhindern.

Mehr erfahren
Erste Schritte mit Splunk

Bewerten Sie jede Agenteninteraktion und liefern Sie – mit gutem Gefühl.

Demo anfordern
Kostenlose Testversionen entdecken