
评估
智能体和模型评估
对生产环境中每一次智能体交互的正确性、安全性和工具使用率进行评分,而非仅针对抽样。
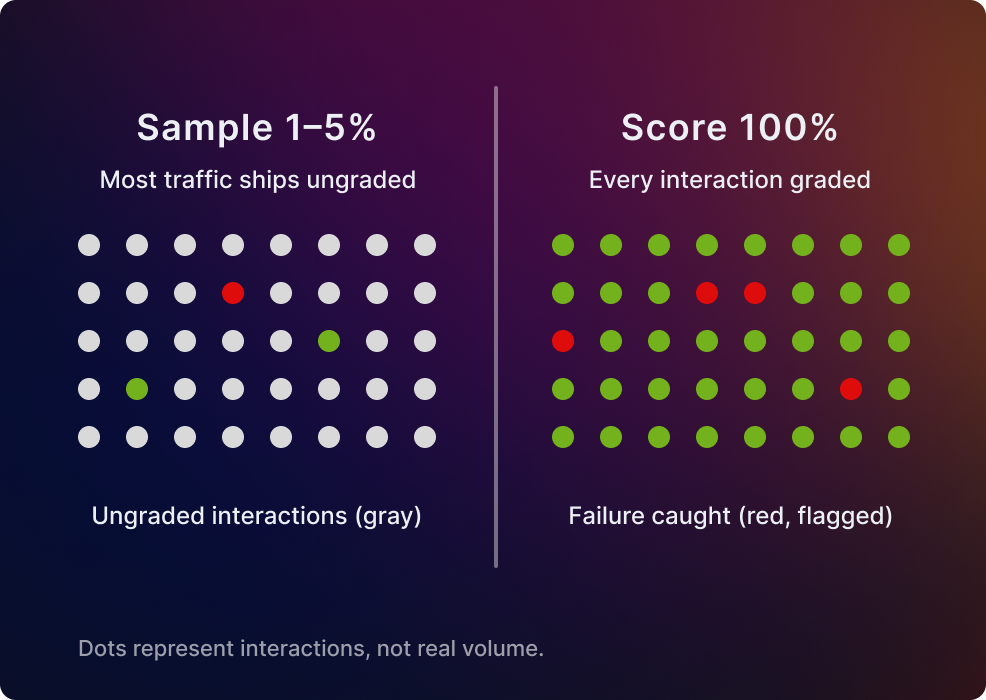
在影响您的客户之前解决问题
当评估模型是小模型而非前沿 LLM 时,我们就能有效管控每一次交互的评分成本。无需抽样,消除盲点。
对每一次智能体交互进行评分,而非仅针对抽样
Luna 是一款小模型,无需依赖前沿 LLM,即可经济高效地对生产环境中的每个请求进行评分,而不仅针对抽样片段。对 100% 的流量进行正确性、安全性和工具使用率评分。
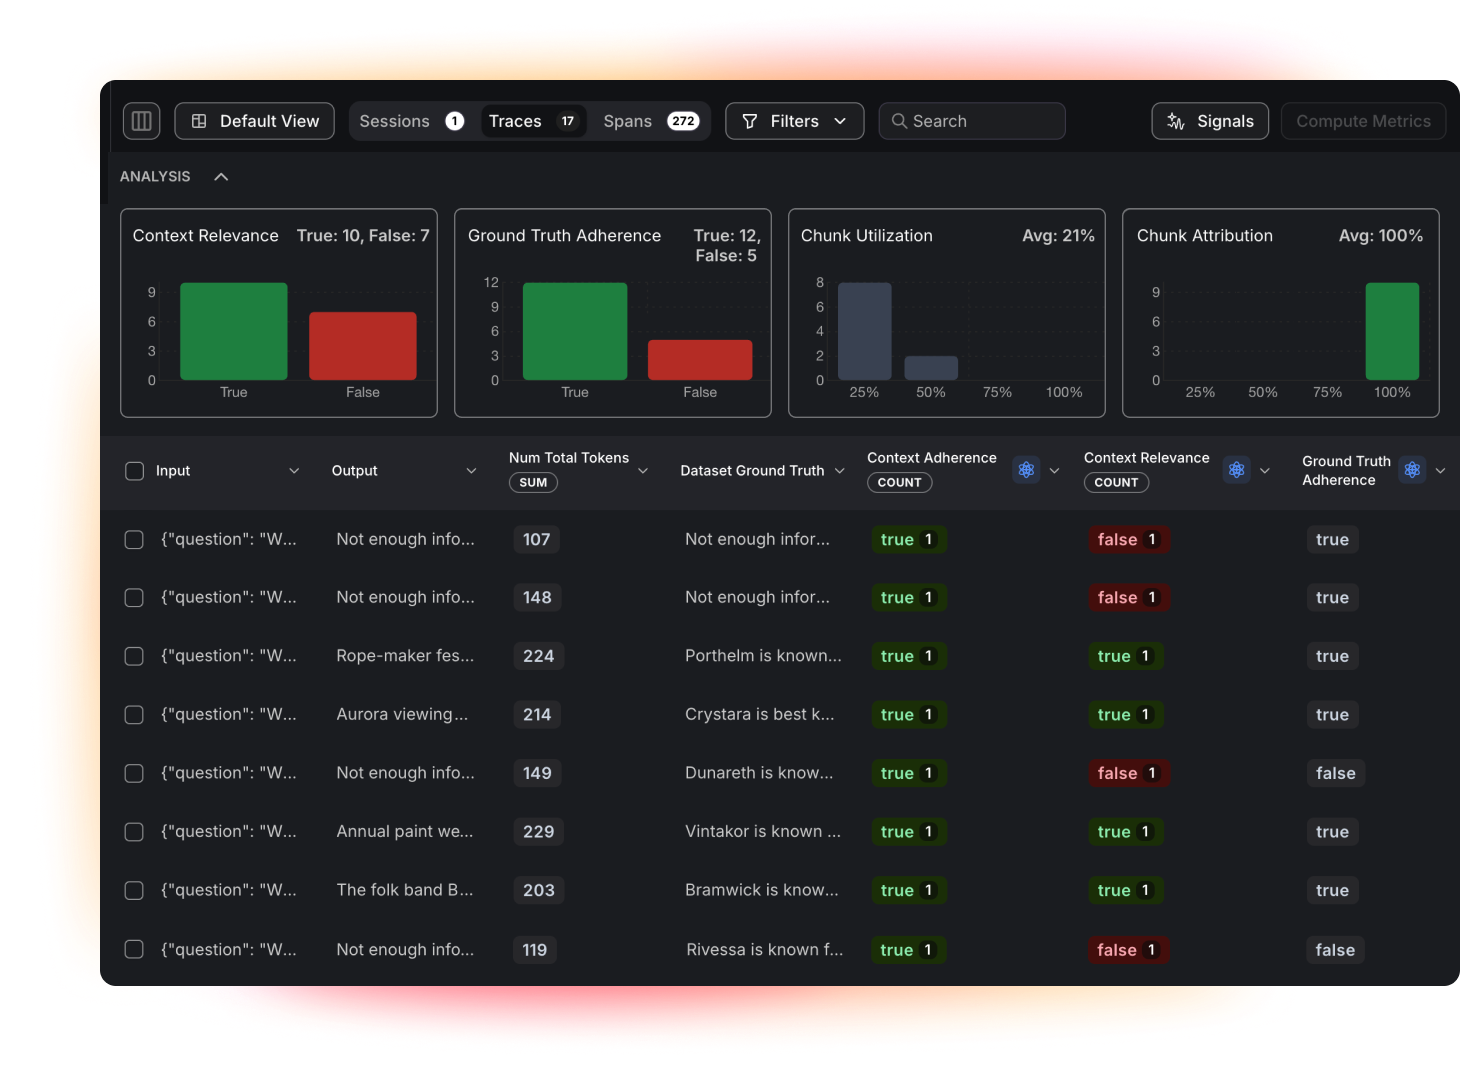
根据您的具体标准定制评估模型
开箱即用的指标很少能满足特定领域对优质答案的要求。借助 Autotune,评估模型会根据您的标准而非通用标准进行调整,因此评分能够反映团队对实际成果的评价。
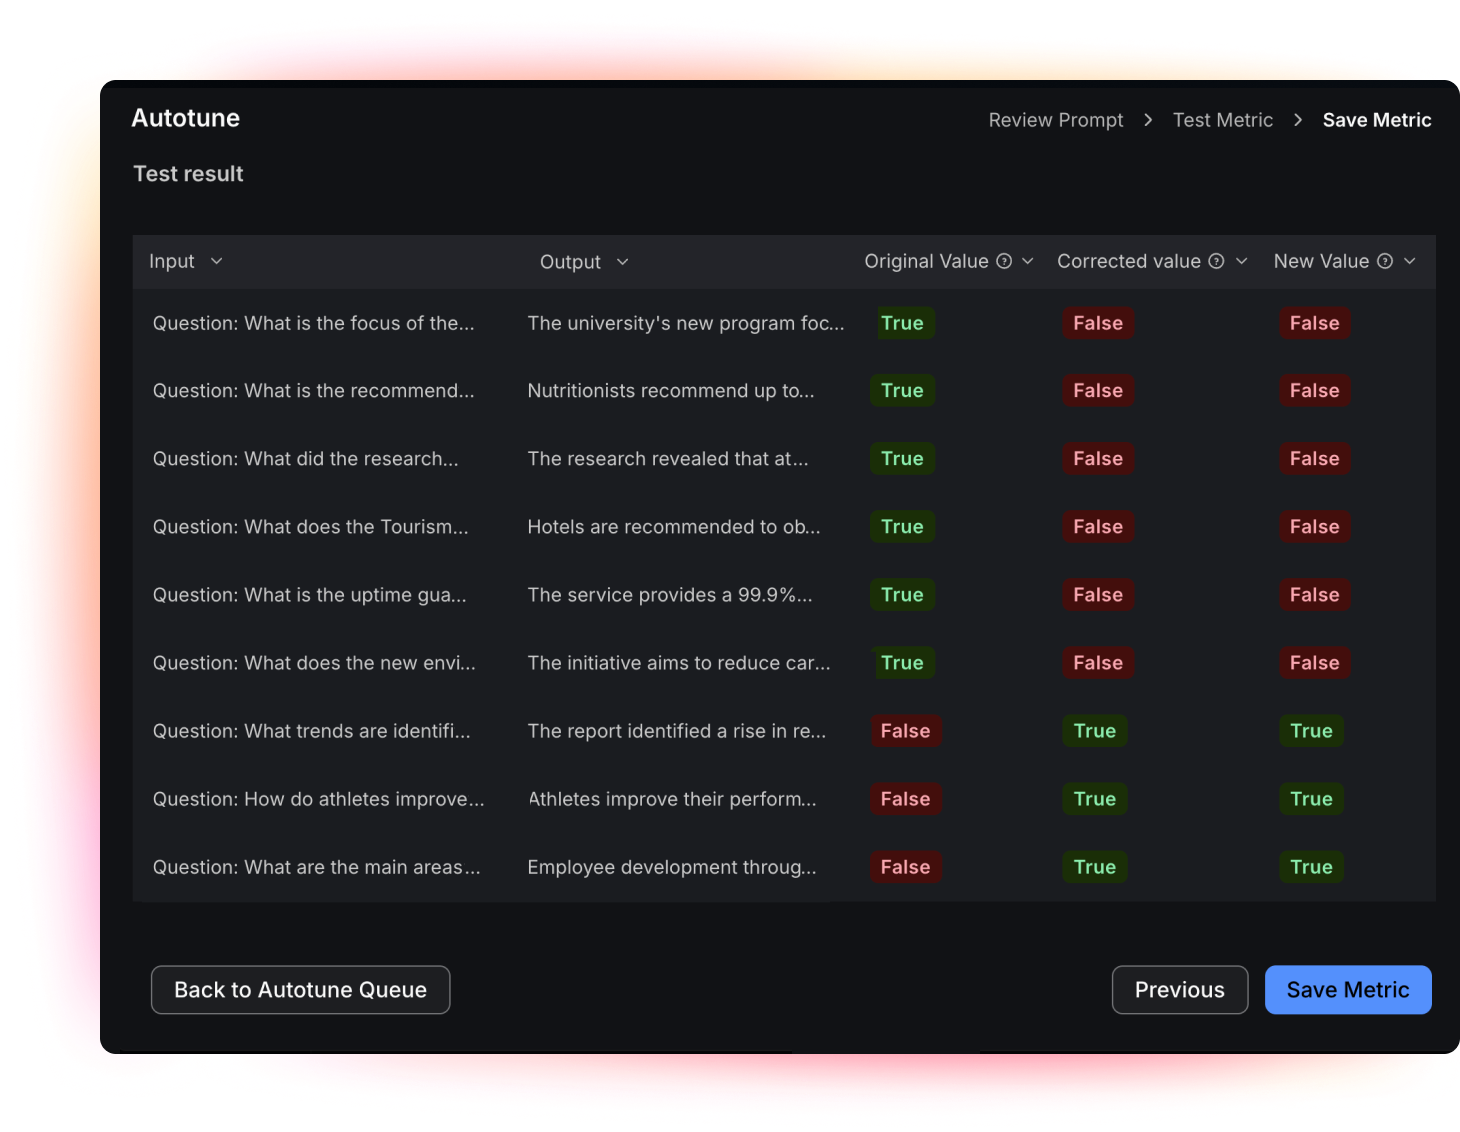
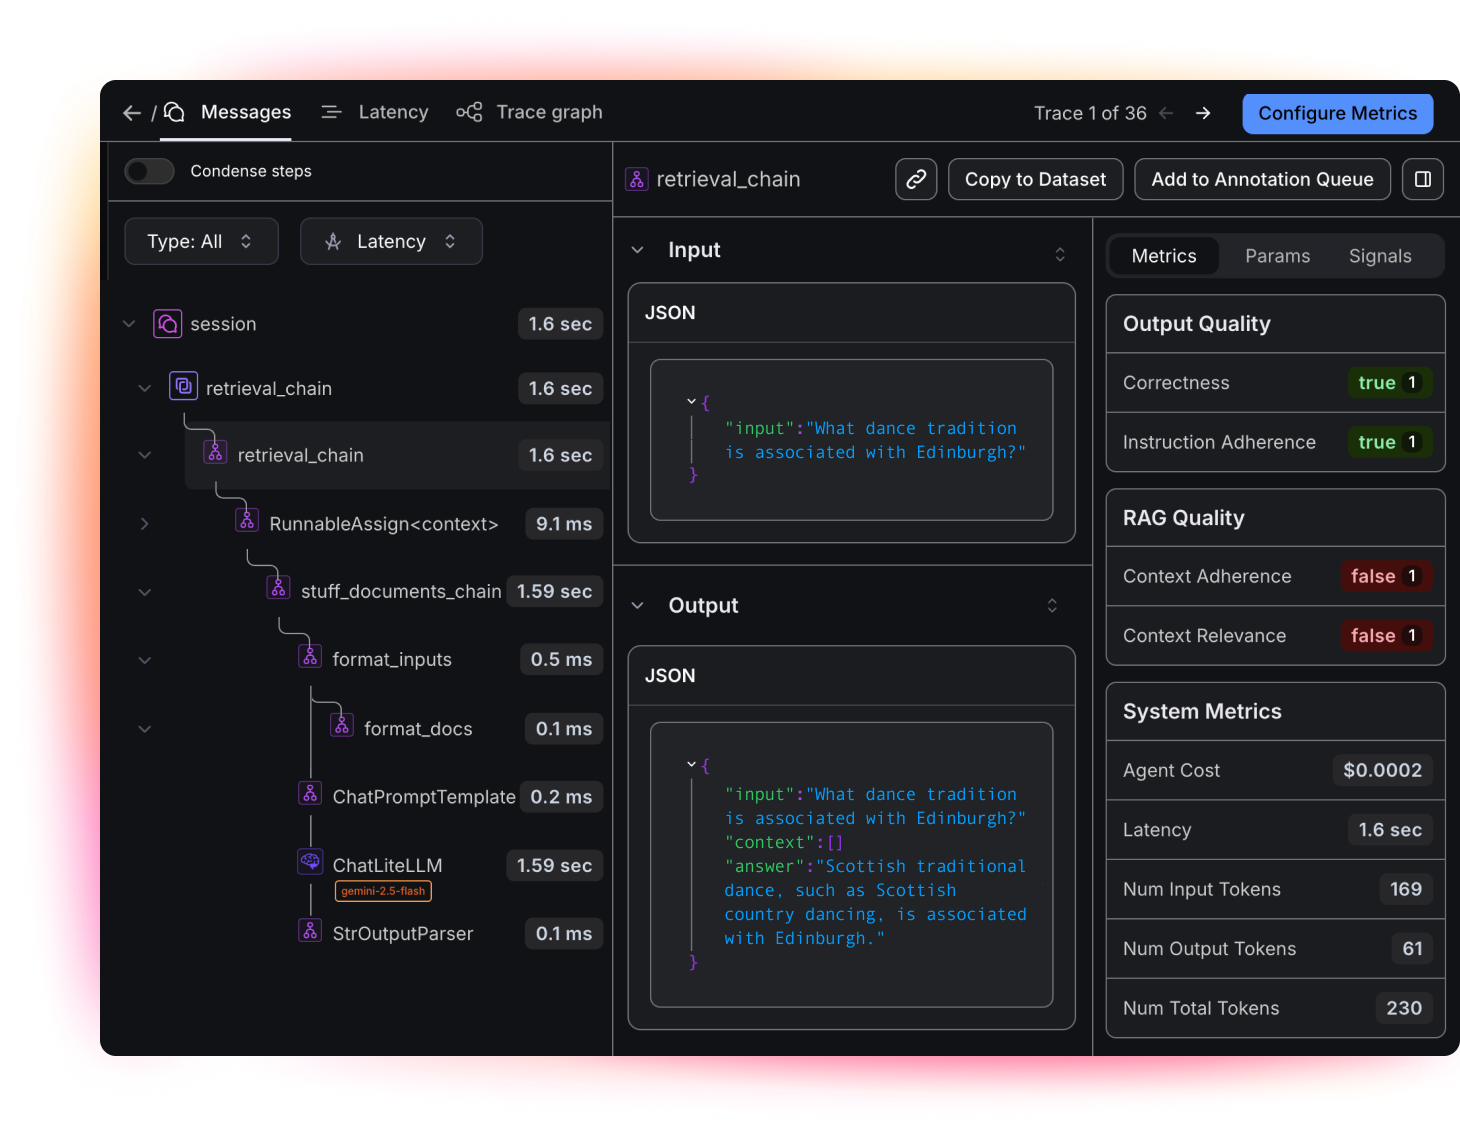
除了延迟、错误和成本之外,还要评估质量
您可以跟踪每个评估分数与延迟、错误以及令牌成本,因此您不仅能了解答案是否有误,还能确定其产生的成本以及所花费的时间。获取质量与性能的统一视图,而非四个互不关联的工具。


资源
了解来自 Splunk 的更多产品
智能体评估常见问题
智能体评估会对智能体实际执行的操作进行评分,涵盖操作完成率、工具选择、幻觉和 RAG 遵循度,让您能够判断其行为是否正确,而非根据抽查结果盲目猜测。
抽样检测会导致大部分流量未经评级,而最终影响客户的故障通常出现在无人检查的环节。由于评估模型是小模型而非前沿 LLM,您可以对每一次交互进行评分,而不仅针对抽样片段。
能。借助 Autotune,您可以直接在跟踪过程中更正部分评分,评估模型会根据您的标准进行调整,而无需标注项目或完成提示工程交接。
在测试中评分表现稳定的评估结果可以升级为运行时检查,在工具触发任务之前拦截或引导不当操作,因此无需维护单独的正确性模型。
能。您可以运行实验和 A/B 测试,依据相同的评估数据比较提示、模型和智能体版本,以了解哪项更改提高了正确性。
