
machine data lake
Gardez davantage de données machine à disposition
Conservez des pétaoctets de données machine haute fidélité dans un stockage économique. Interrogez les données in situ et indexez celles qui comptent dans Splunk quand la situation exige de la vitesse.
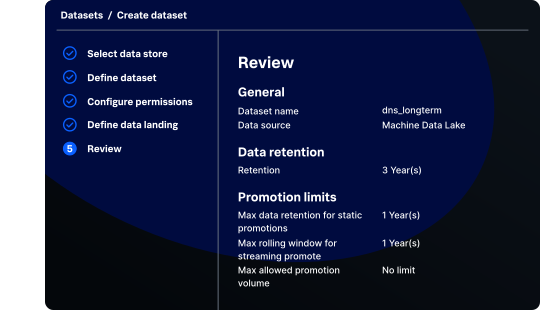
Conçu pour le stockage et l’action
Conservez les données machine dans un stockage économique et interrogeable, et promouvez-les lorsque le scénario d’utilisation nécessite des performances élevées.
Conservez davantage de données sans perdre en fidélité
Hébergez des pétaoctets de données machine dans un environnement de stockage économique sans perdre les détails, la gouvernance ni le contexte indispensables aux futures activités d’investigation, d’analyse et d’IA.
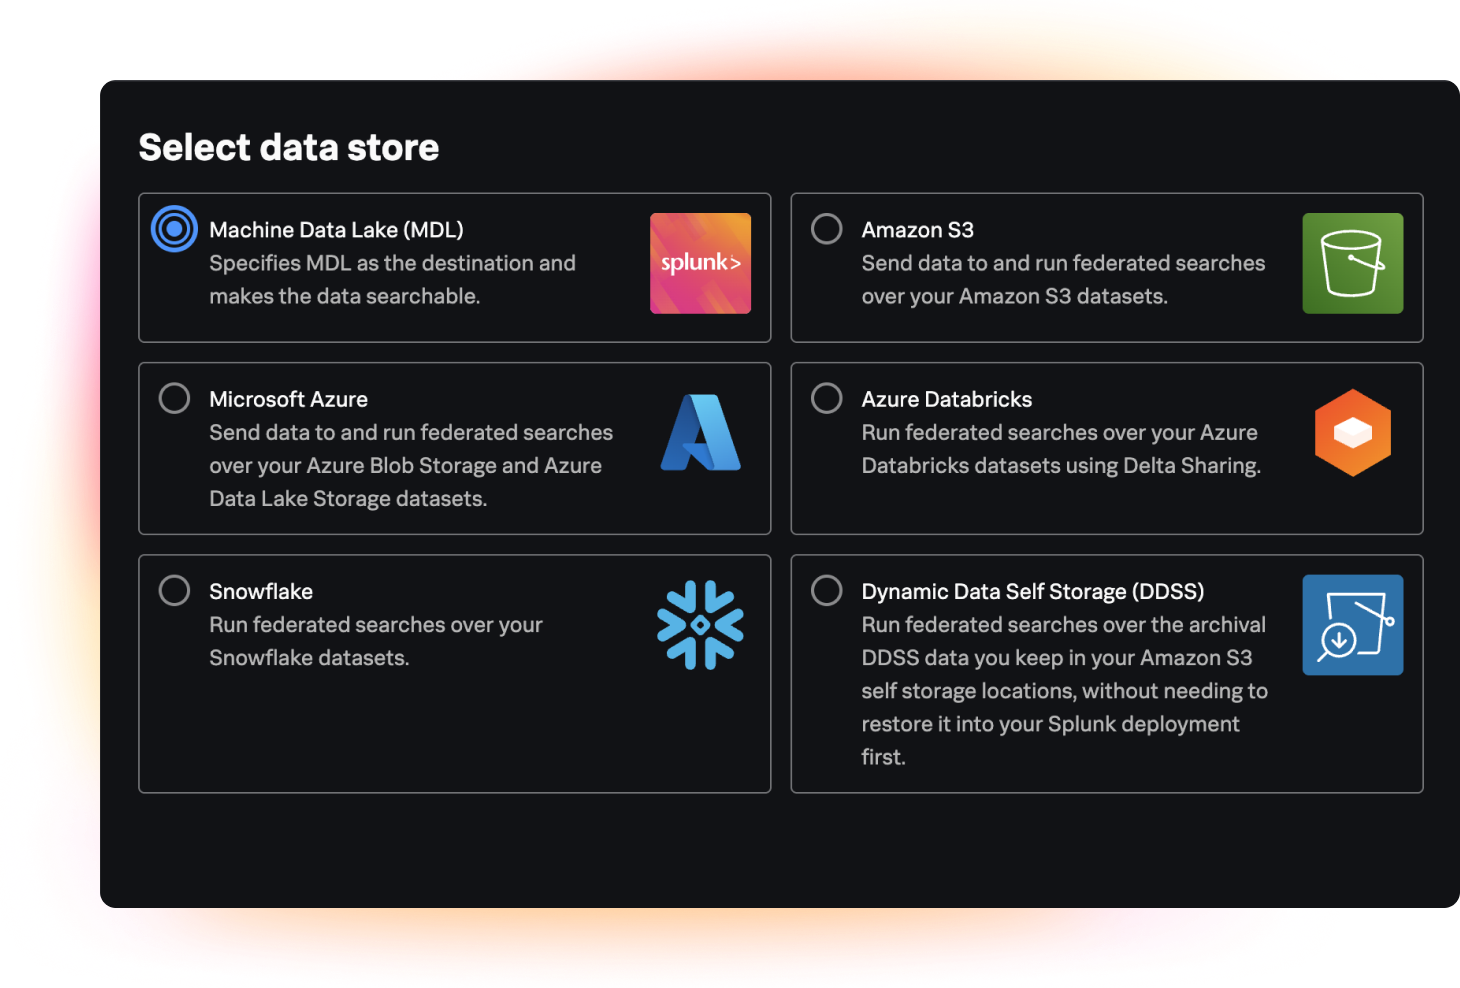
Découvrez et interrogez les données là où elles se trouvent
Utilisez Catalog pour découvrir, comprendre et encadrer les données machine que vous conservez. Interrogez-les in situ avec Federated Search, sans avoir à les promouvoir ni à les dupliquer dans un index Splunk au préalable.
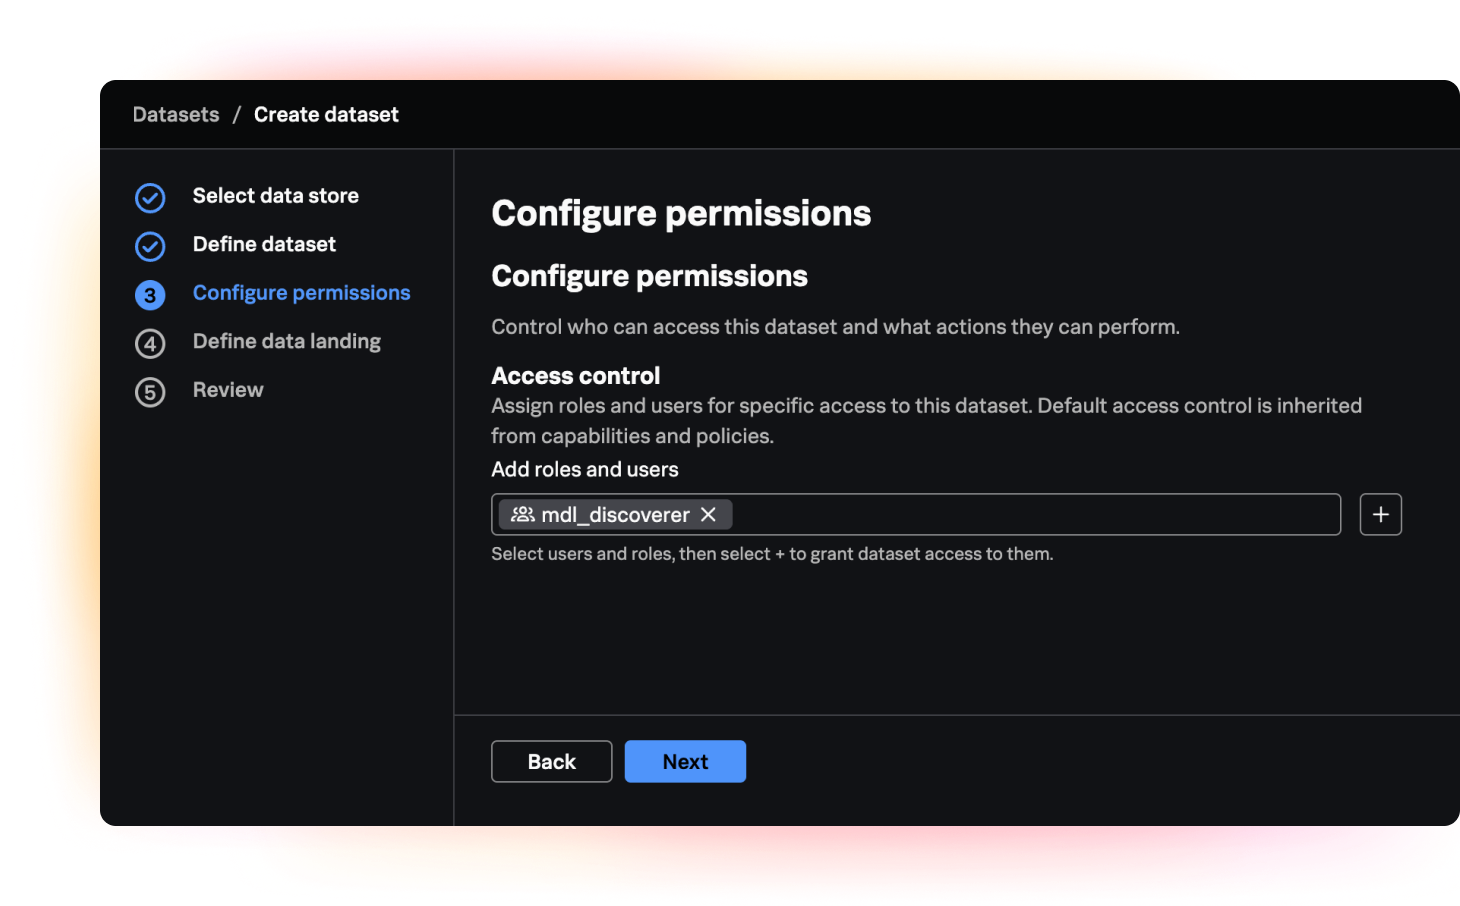
Promouvez les données quand la situation demande de la rapidité
Déplacez les données dans les index Splunk pour les utiliser dans des analyses haute performance, des détections en temps réel, des tableaux de bord et des workflows actifs, tout en préservant les données haute fidélité d’origine.
Machine Data Lake – FAQ
Machine Data Lake est un environnement Splunk qui offre un moyen économique de conserver des pétaoctets de données machine haute fidélité. Les données qu’il héberge peuvent être découvertes et interrogées in situ, et prêtes à être indexées dans Splunk lorsque des workflows haute performance l’exigent.
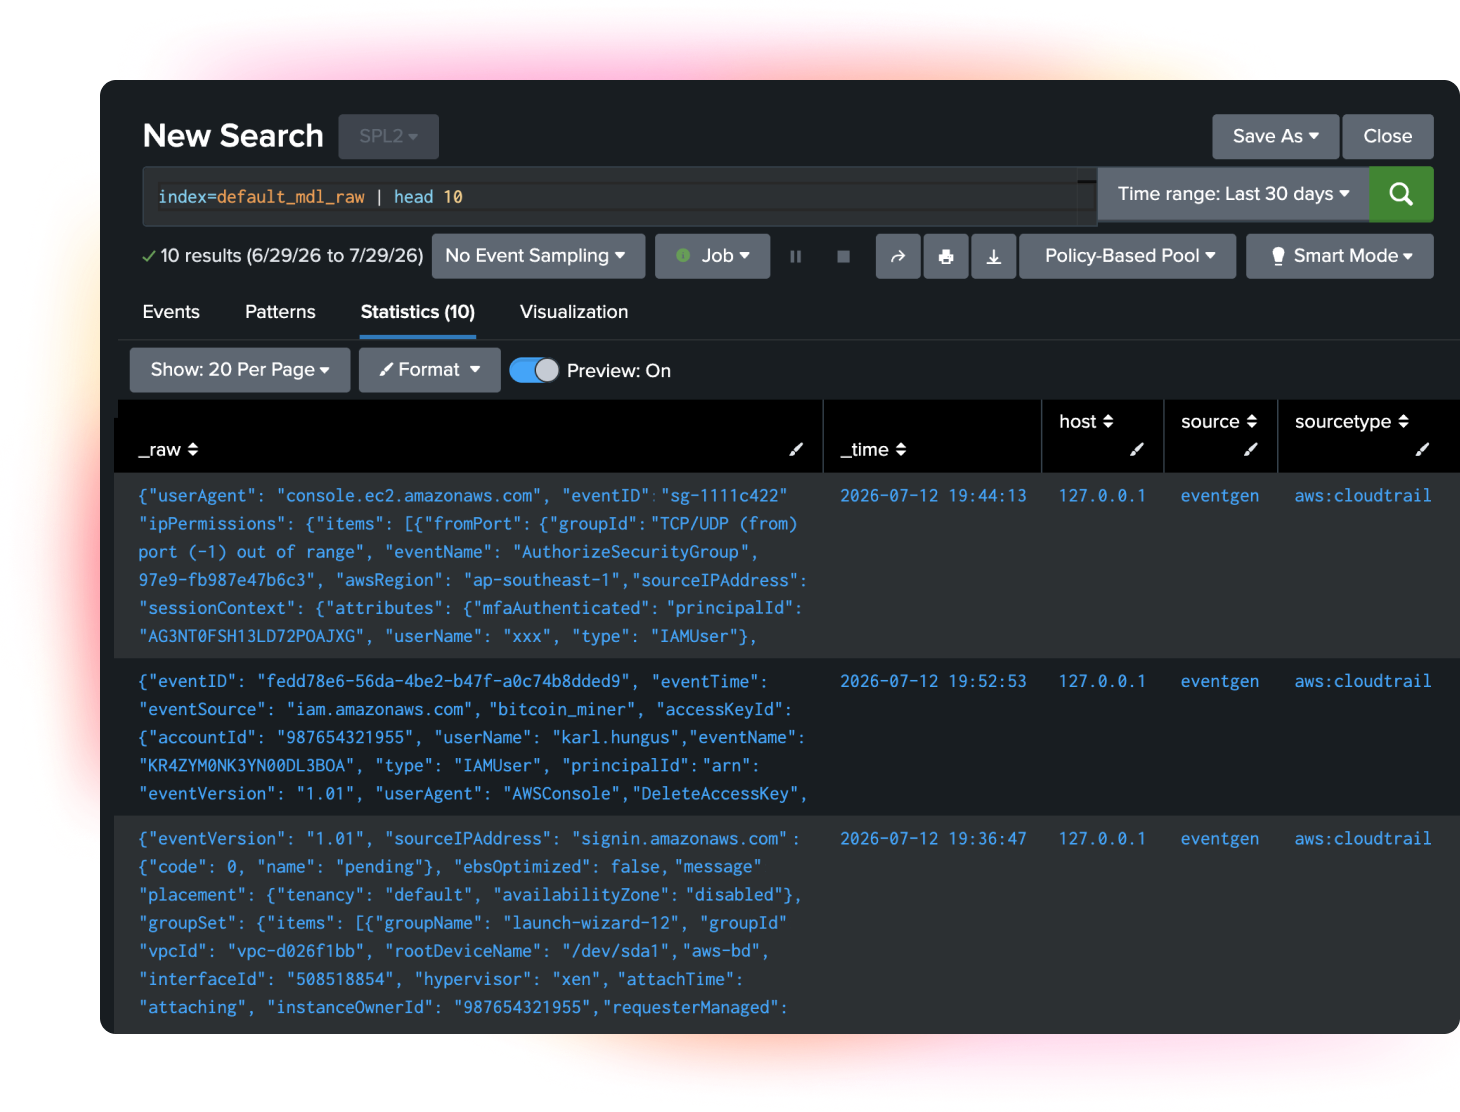
Oui. Utilisez SPL2 et Federated Search pour interroger les données conservées in situ. Splunk Catalog facilite la découverte, la compréhension et la gouvernance des données disponibles pour aider les équipes à les exploiter dans leurs recherches, leurs investigations, leurs analyses et leurs workflows d’IA.
Machine Data Lake offre aux entreprises un contrôle accru sur la conservation des données machine et leur permet de choisir à quel moment les promouvoir pour des usages exigeant des performances élevées. Les grands volumes de données télémétriques rarement utilisés peuvent rester dans un environnement de stockage économique, afin d’éviter l’indexation continue de tous les groupes de données.
Machine Data Lake et les index Splunk remplissent deux fonctions complémentaires. Machine Data Lake est un espace de stockage économique et haute fidélité qui permet d’interroger les données in situ. Promouvez des données dans les index Splunk de façon sélective pour vos détections en temps réel, vos tableaux de bord, vos analyses haute performance et vos workflows actifs.
Machine Data Lake préserve des données historiques haute fidélité qui peuvent apporter un contexte précieux à l’IA. Splunk Catalog facilite la découverte, la compréhension et la gouvernance de ces données, tandis que la recherche in situ et la promotion des données permet de mettre les bonnes informations au service de l’analyse, des investigations et des workflows pilotés par IA.
Solutions connexes
Splunk Platform
La plateforme unifiée de sécurité et d’observabilité pour l’analyse en temps réel.
Federated Search
Interrogez et analysez les données des environnements externes sans les déplacer.
Cisco Data Fabric
Connectez et sécurisez la télémétrie de tout l’environnement de votre entreprise.
Agent Launchpad
Transformez les alertes, les recherches et les investigations en actions agentiques.
