
Machine Data Lake
让更多机器数据随时做好行动准备
在 PB 级规模下经济高效地保留全保真机器数据。就地进行搜索,然后在速度至关重要时将重要内容提升至 Splunk 索引中。
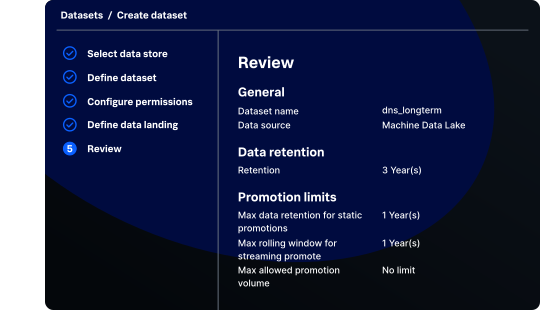
保留更多,同时不会失去保真度
以 PB 级规模将机器数据落地到经济高效的留存环境中,同时保留未来调查、分析和 AI 所需的原始细节、治理与上下文。
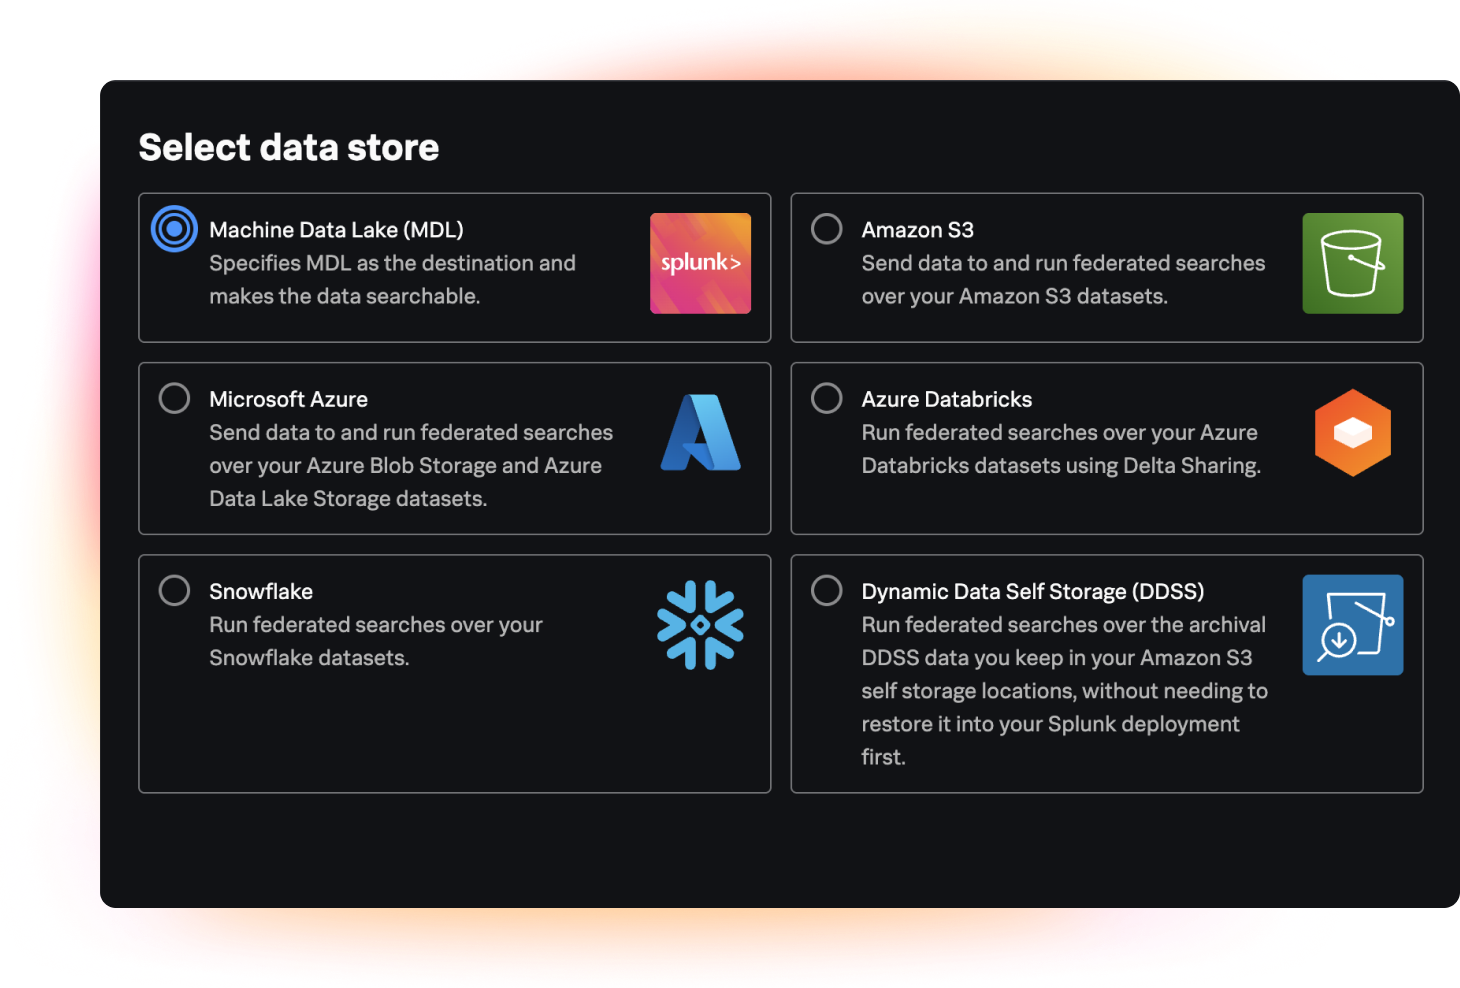
就地发现和搜索数据
使用 Catalog 发现、了解并治理保留的机器数据。然后使用联合搜索在原地查询这些数据,无需先在 Splunk 索引中提升或复制这些数据。
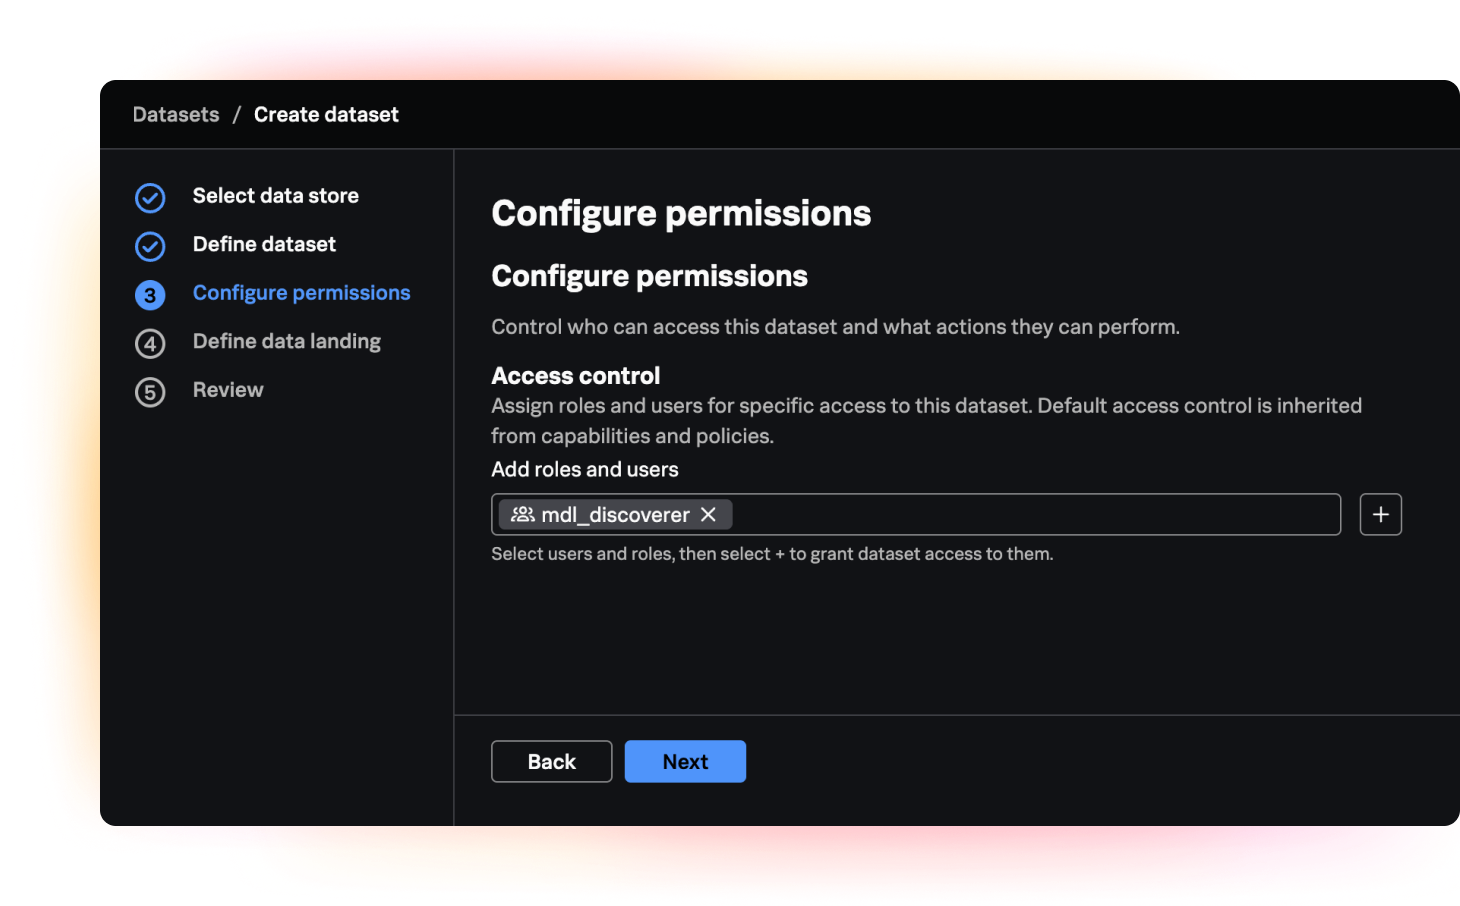
在速度至关重要时提升数据
将选定数据移至 Splunk 索引中,以进行高性能分析、实时检测、仪表板以及活动工作流,同时保留原始全保真数据。
Machine Data Lake 常见问题解答
Machine Data Lake 是一种 Splunk 环境,旨在以经济的方式保留 PB 级全保真机器数据。它使保留的数据可被发现、可在原处搜索,并可在需要更高性能工作流时随时提升至 Splunk 索引。
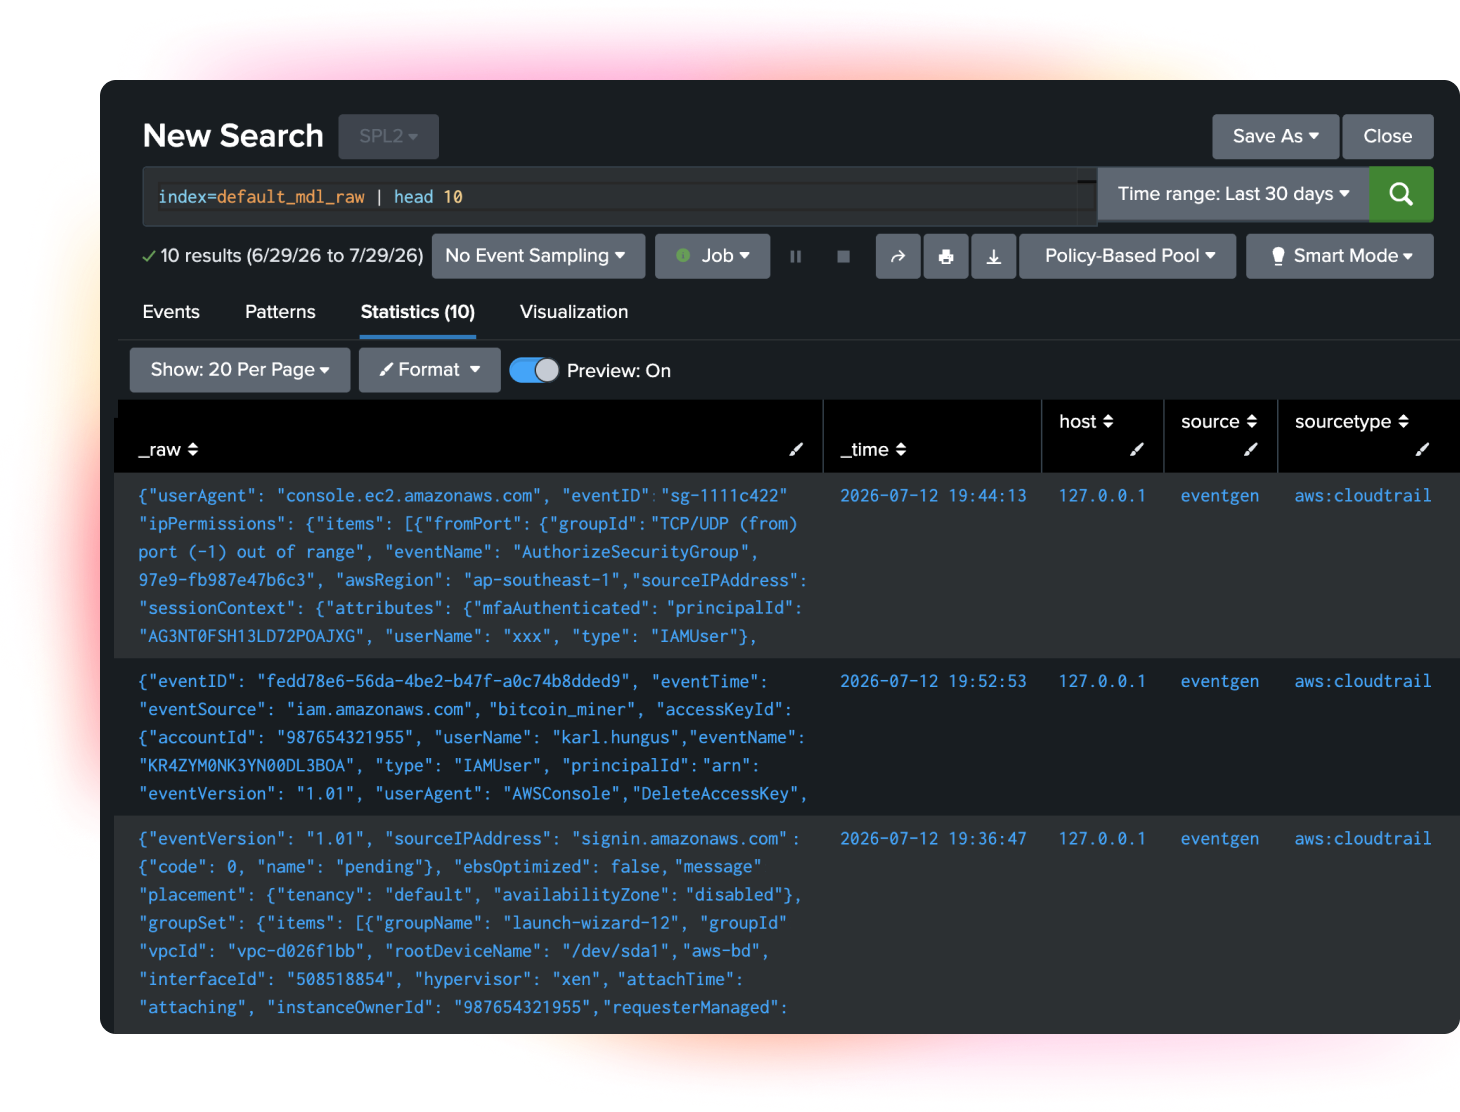
可以。使用 SPL2 和联合搜索就地查询保留的数据。Splunk Catalog 可帮助团队在将可用数据用于搜索、调查、分析和 AI 工作流之前,发现、了解和治理这些数据。
Machine Data Lake 让组织能够更好地掌控机器数据的留存位置,以及何时将其提升用于高性能需求。海量、低接触度的遥测数据可以保留在经济高效的留存环境中,而无需对每个数据集进行持续索引。
Machine Data Lake 和 Splunk 索引用途互补。使用 Machine Data Lake 可经济高效地进行全保真保留和原地搜索。当需要进行实时检测、仪表板、高性能分析或活跃工作流时,可将选定的数据提升至 Splunk 索引。
Machine Data Lake 保留全保真的历史机器数据,可为 AI 提供宝贵的上下文。Splunk Catalog 帮助团队发现、理解和治理该数据,而就地搜索和数据提升则将适当的信息提供给分析、调查以及 AI 驱动的工作流。
