
머신 데이터 레이크
더 많은 머신 데이터를 즉시 활용 가능한 상태로 준비
페타바이트 규모의 full-fidelity 머신 데이터를 비용 효율적으로 보존하세요. 데이터를 저장된 위치에서 바로 검색하고, 빠른 처리가 필요한 데이터를 Splunk 인덱스로 전환하여 활용할 수 있습니다.
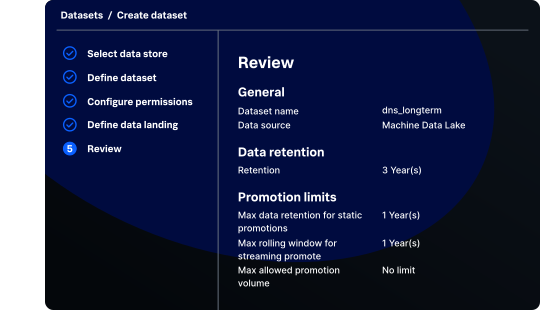
단순한 저장을 넘어, 실제 활용을 위해 설계
full-fidelity 머신 데이터를 비용 효율적으로 보존하고, 검색 가능한 상태로 유지하며, 고성능 작업에서 필요로 할 때 데이터를 전환하여 활용하세요.
완전한 품질을 유지하면서 더 많은 데이터 보존
페타바이트 규모의 머신 데이터를 비용 효율적인 보관 환경에 보존하면서도 향후 조사, 분석, AI 활용에 필요한 원시 데이터의 세부 정보, 거버넌스, 컨텍스트를 그대로 유지할 수 있습니다.
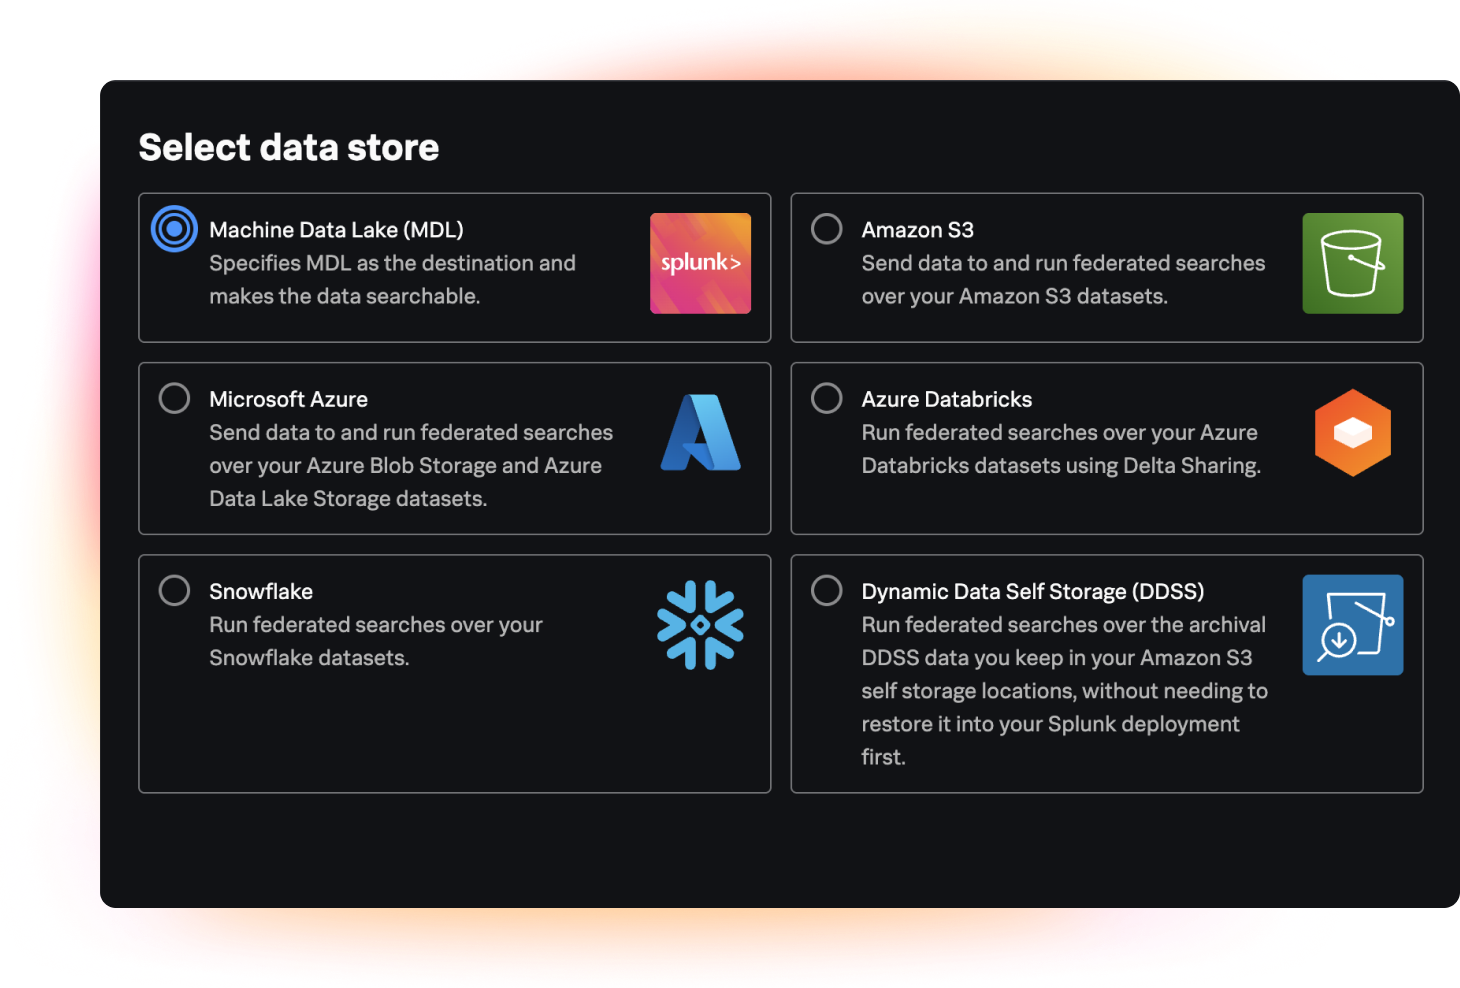
데이터가 있는 위치에서 데이터 탐색 및 검색
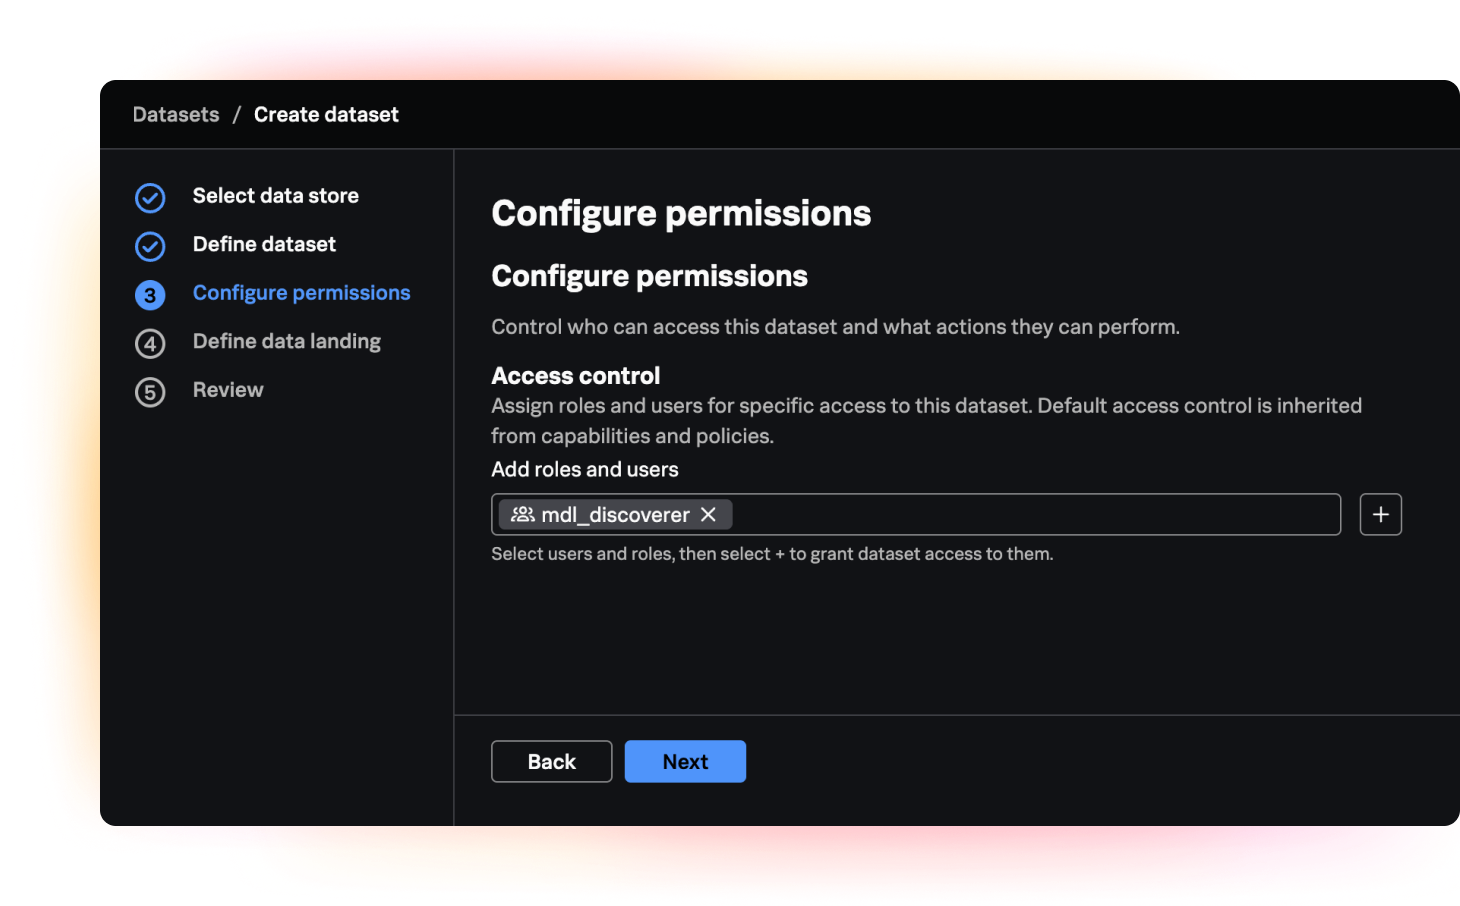
카탈로그를 사용하여 보존된 머신 데이터를 검색하고, 파악하고, 거버넌스를 적용하세요. 그런 다음 연합 검색을 사용하여 데이터가 저장된 위치에서 바로 쿼리하세요. Splunk 인덱스로 전환하거나 복제할 필요가 없습니다.
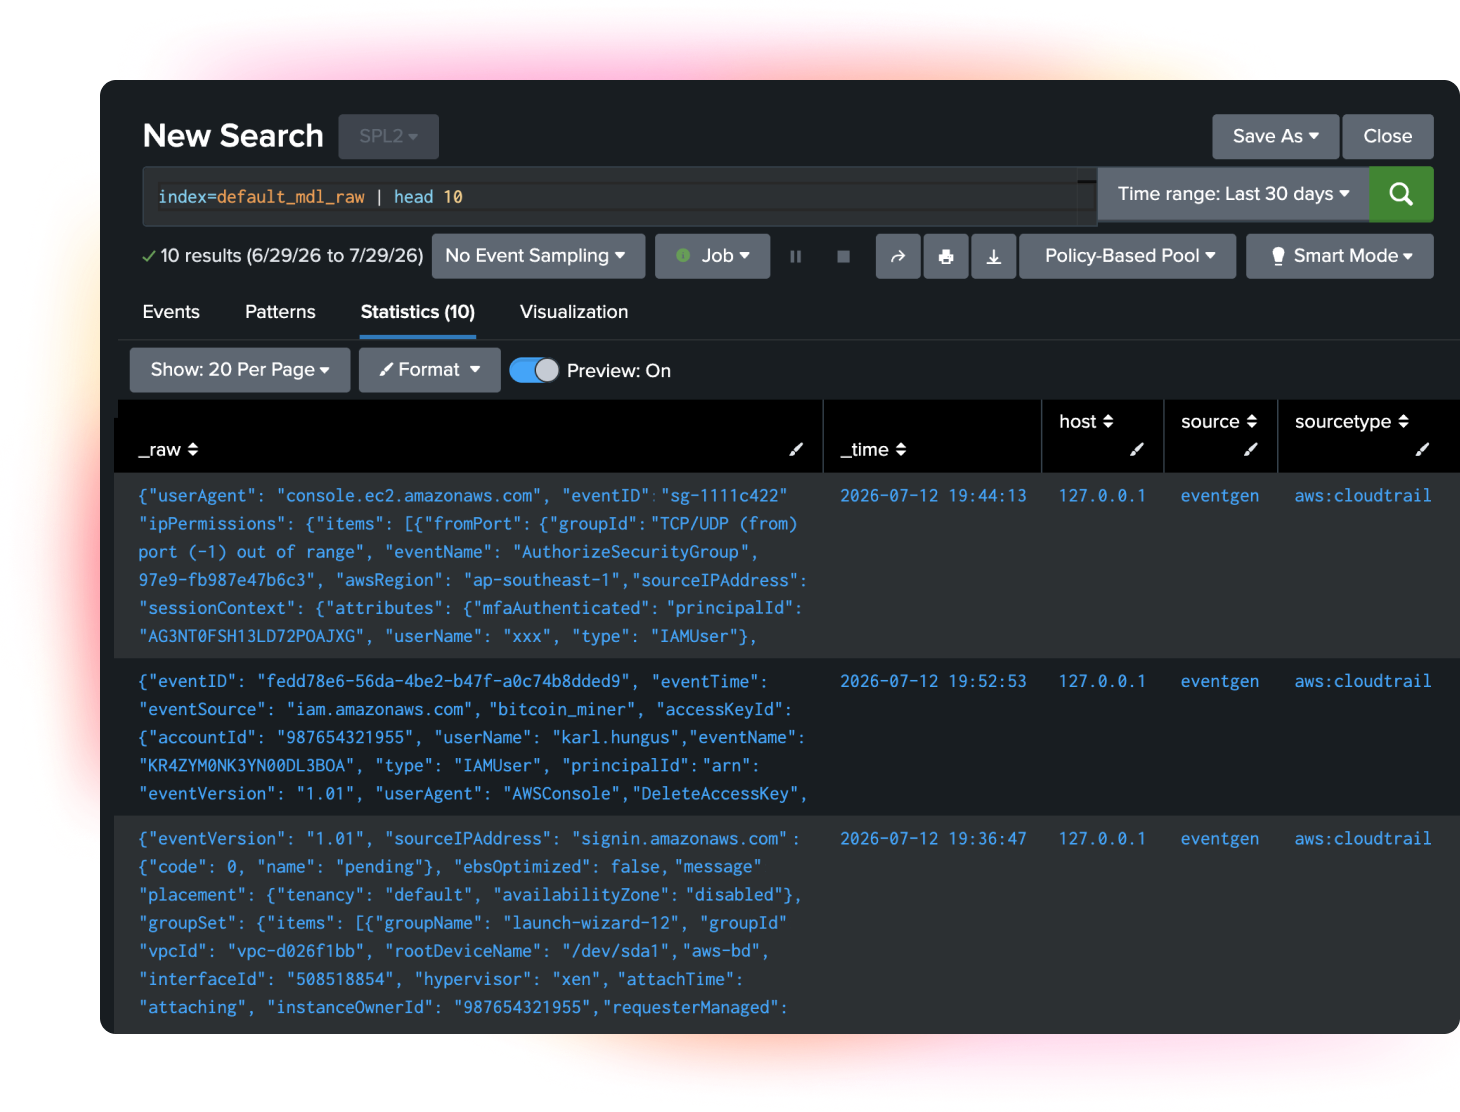
속도가 중요한 경우 데이터 전환
선택한 데이터를 Splunk 인덱스로 이동하여 고성능 분석, 실시간 탐지, 대시보드, 활성 워크플로에 활용할 수 있습니다. 이때 원본 full-fidelity 데이터는 그대로 보존할 수 있습니다.
머신 데이터 레이크 관련 FAQ
머신 데이터 레이크는 페타바이트 규모의 full-fidelity 머신 데이터를 비용 효율적으로 보존하도록 설계된 Splunk 환경입니다. 보존된 데이터를 검색하고 탐색할 수 있는 상태로 유지하며, 더 높은 성능이 필요한 워크플로에서는 Splunk 인덱스로 전환하여 활용할 수 있도록 지원합니다.
네. SPL2와 연합 검색을 사용하여 보존된 데이터를 원래의 저장된 위치에서 직접 쿼리할 수 있습니다. Splunk 카탈로그를 사용하면 팀이 검색, 조사, 분석, AI 워크플로에 데이터를 활용하기 전에 사용 가능한 데이터를 검색하고, 파악하며, 거버넌스를 적용할 수 있습니다.
머신 데이터 레이크를 사용하면 조직이 머신 데이터를 어디에 보존할지, 언제 더 높은 성능이 필요한 용도로 전환할지를 보다 효과적으로 제어할 수 있습니다. 대량으로 생성되지만 자주 활용하지 않는 텔레메트리 데이터는 모든 데이터 집합을 지속적으로 인덱싱할 필요 없이 비용 효율적인 데이터 보존 환경에 그대로 유지할 수 있습니다.
Machine Data Lake와 Splunk 인덱스는 상호 보완적인 역할을 합니다. 머신 데이터 레이크는 full-fidelity 데이터를 비용 효율적으로 보존하고 데이터가 저장된 위치에서 직접 검색하는 데 사용할 수 있습니다. 실시간 탐지, 대시보드, 고성능 분석 또는 활성 워크플로에 데이터가 필요한 경우에는 선택한 데이터를 Splunk 인덱스로 전환하여 활용할 수 있습니다.
머신 데이터 레이크는 AI에 유용한 컨텍스트를 제공할 수 있는 과거의 full-fidelity 머신 데이터를 보존합니다. Splunk 카탈로그를 사용하면 팀이 이러한 데이터를 검색하고, 파악하며, 거버넌스를 적용할 수 있으며 데이터가 저장된 위치에서 바로 검색하고 필요한 데이터를 전환할 수 있어 분석, 조사, AI 기반 워크플로에 적합한 정보를 활용할 수 있습니다.
