splunk background

Transparenz

Einblick in den gesamten Agenten-Trace

Protokollieren und verfolgen Sie alle Schritte eines KI-Agenten – von Entscheidungsschritten bis hin zur GPU, auf der er ausgeführt wurde, und identifizieren Sie schnell die Kernursache, wenn Probleme auftreten.

Free Edition 14 Tage lang kostenlos und unverbindlich testen – keine Kreditkarte erforderlich.
Produkt-Tour starten 5 Minuten Zeit? Jetzt die wichtigsten Funktionen kennenlernen.
Transparenz

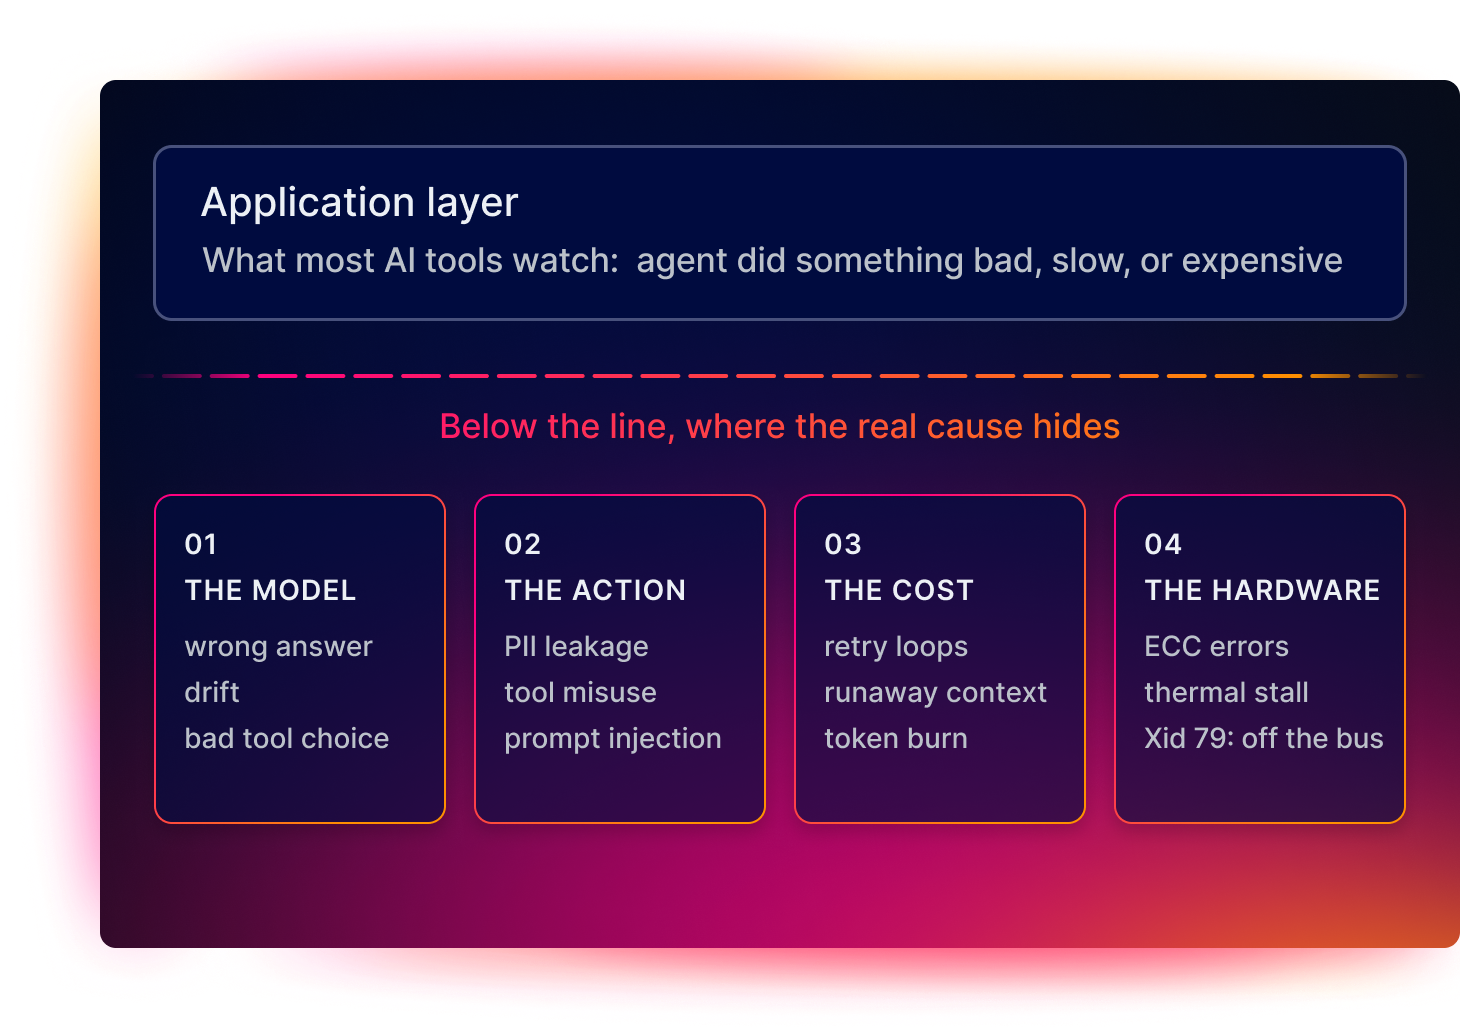
Finden Sie die Ursache unterhalb der Anwendungsebene

Mit dem Agenten-Trace und dem Hardware-Ereignis auf einer Zeitachse verfolgen Sie eine fehlerhafte Antwort oder eine abgebrochene Ausführung bis hinunter zu dem Chip, der dafür verantwortlich war.

Fehler erkennen, deren Ursprung auf der Ebene unter dem Code liegt

Die Kernursache versteckt sich häufig hinter der Orchestrierungsebene: Das Modell halluzinierte, der Agent benutzte ein Tool, das er nicht benutzen sollte, die Infrastruktur trieb still und heimlich die Rechnung in die Höhe oder die Hardware streikte.

Verfolgen und Dokumentieren von Workflows mit mehreren Agenten von der Anfrage bis zur Antwort

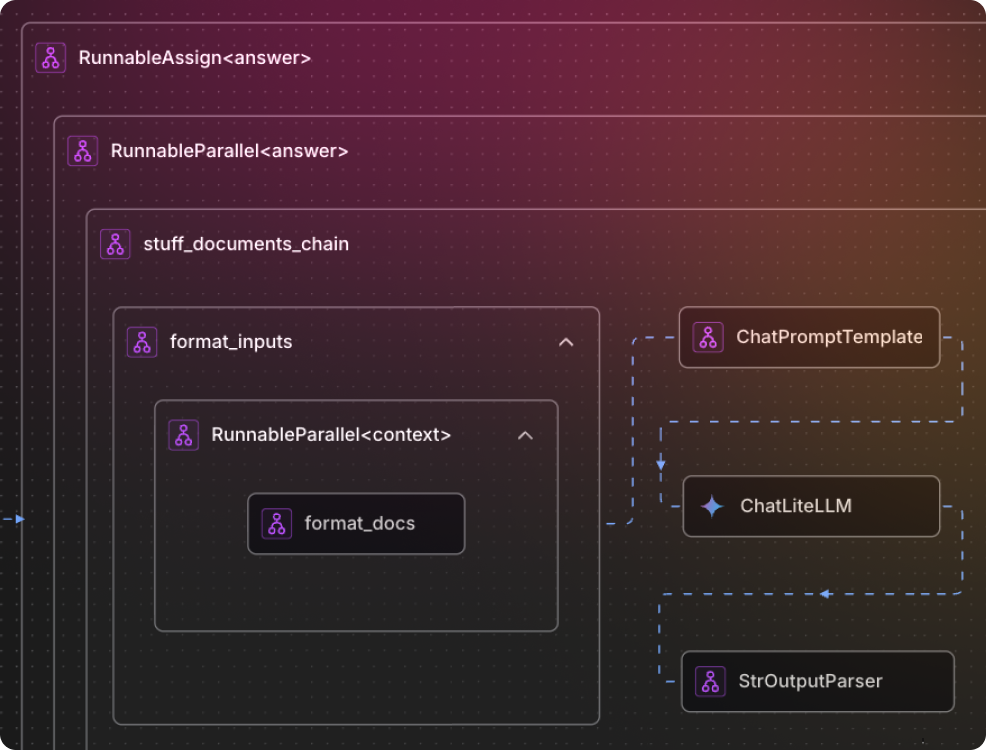
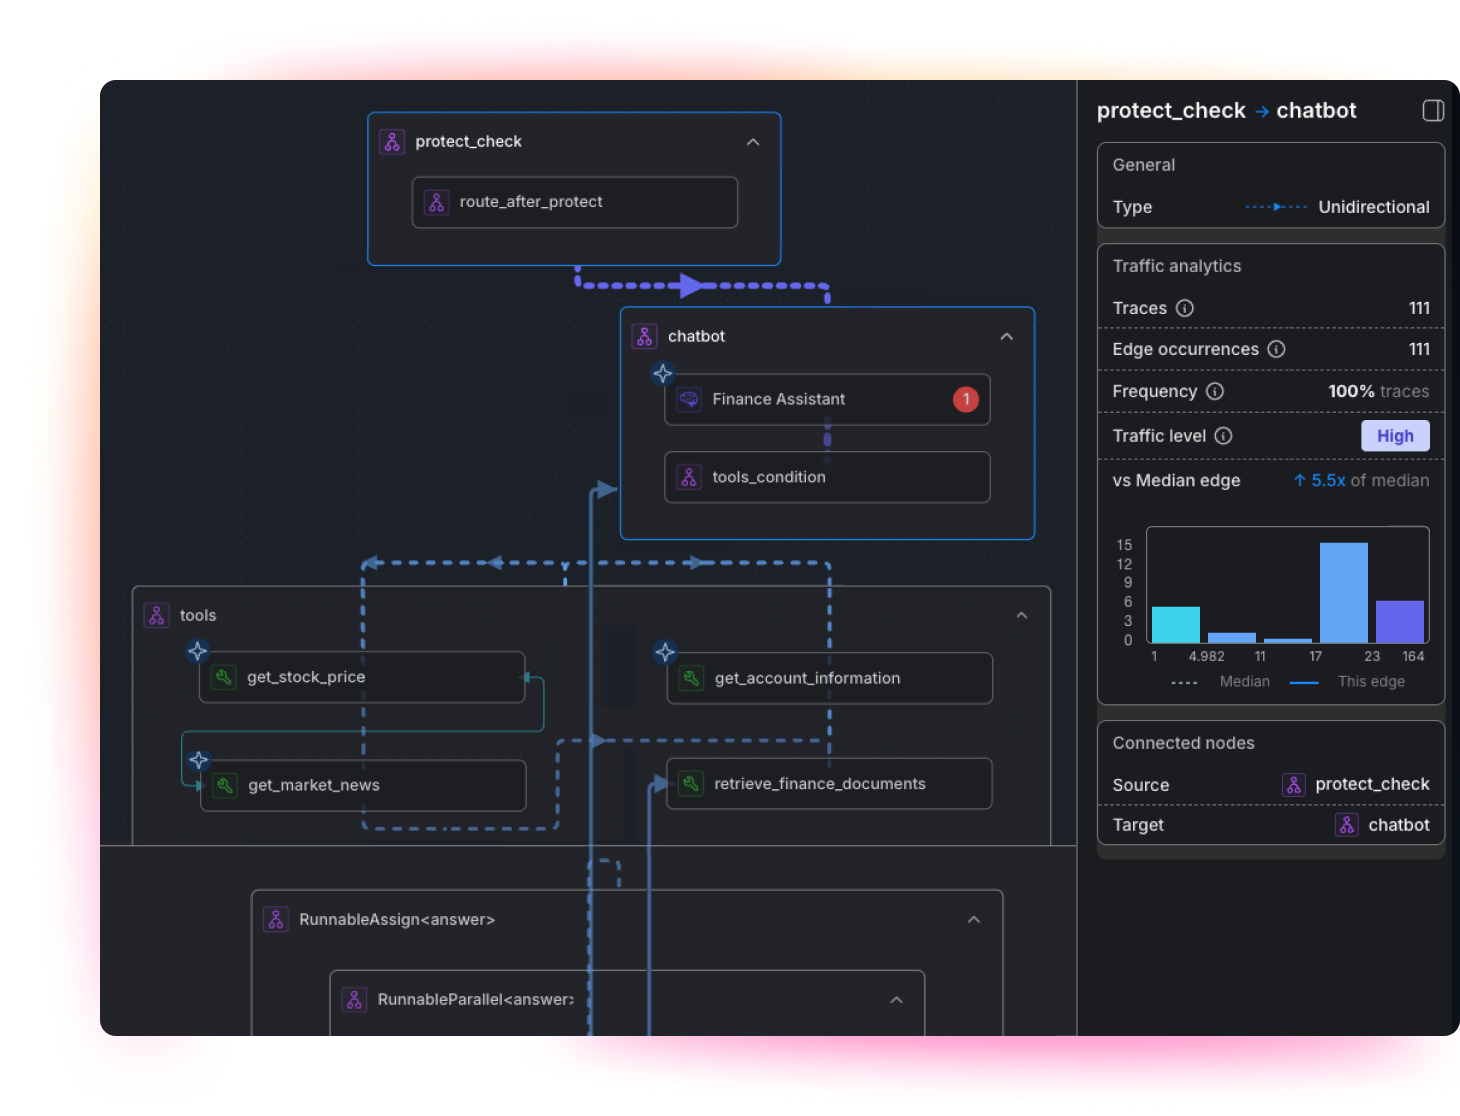
Folgen Sie einer Anfrage vom Anfang bis zum Ende. Sehen Sie, wie Agenten Arbeit übergeben, bei welchen Schritten es zu Verzögerungen kommt und wo Probleme auftreten. Ein Trace zeigt die Argumentation eines Agenten, sodass Sie nachvollziehen können, was er getan hat und warum – und nicht nur, dass er fehlgeschlagen ist.

Korrelieren von Agent und Infrastruktur auf einer Zeitachse

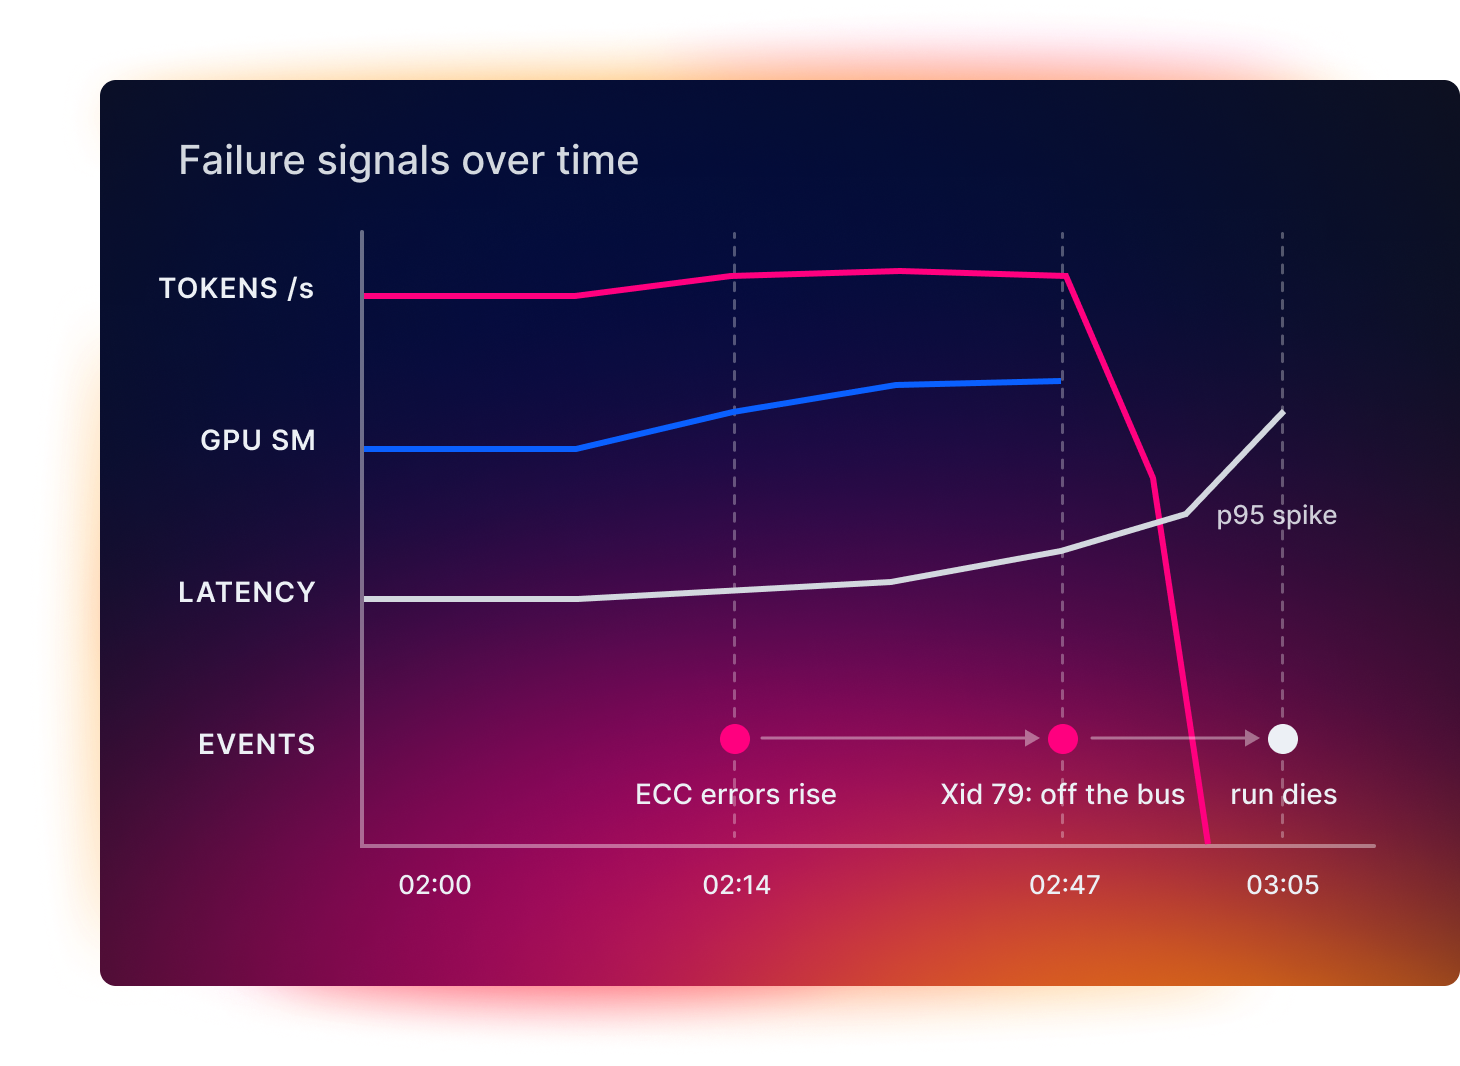
Mithilfe korrelierter Telemetriedaten lassen sich frühe Anzeichen von Leistungsproblemen visualisieren. Wenn ein sprunghafter Anstieg des Token-Verbrauchs, eine ausgelastete GPU, eine Latenzspitze, eine zunehmende Zahl von ECC-Fehlern und ein Xid-79-Ereignis gleichzeitig auftreten, können Teams Risiken früher erkennen, Fehler schneller beheben und Maßnahmen ergreifen, bevor die Ausführung abbricht.

.Conf 26 promo image

Keynotes der .conf26 live ansehen

Sichern Sie sich einmalige Insights der klügsten Köpfe bei Splunk und führender Branchenexperten.

Jetzt streamen

Funktionen

Betrachten des gesamten Stacks, von der Argumentation bis zur GPU

Dokumentation kennenlernen
Verfolgen eines Agenten von der Argumentation bis zur GPU Verfolgen eines Agenten von der Argumentation bis zur GPU

Verfolgen eines Agenten von der Argumentation bis zur GPU

Sehen Sie sich die Tool-Aufrufe, Modelle und Abrufschritte eines Workflows von der Anfrage bis zur Antwort an und verknüpfen Sie dieses Verhalten mit der zugrundeliegenden Infrastruktur. Die Kernursache zeigt sich auf einer Zeitachse, nicht in vier separaten Tools.
Ausgaben Ausgaben

Betrachten der zugrundeliegenden Infrastruktur

Verfolgen Sie die GPU- und Speicherauslastung, den Stromverbrauch und die Time-to-First-Token für Ihre Modelle, Vektordatenbanken und den Rest Ihres KI-Stacks. Wenn ein Anstieg des Token-Verbrauchs und eine ausgelastete GPU zusammenkommen, ist das Rätsel um die lange Antwortzeit gelöst.
Gescheiterte Ausführung Schritt für Schritt nachvollziehen Gescheiterte Ausführung Schritt für Schritt nachvollziehen

Gescheiterte Ausführung Schritt für Schritt nachvollziehen

Folgen Sie einer einzelne Zeitachse von einer ECC-Spitze zu einer Temperatur- oder Leistungsanomalie bis zu einem Xid 79-Ereignis und einer abgebrochenen Ausführung, indem Sie den Agenten-Trace und GPU-Telemetriedaten nebeneinander anzeigen. Die Antwort auf die Frage nach der Fehlerursache wird in einer Ansicht erkennbar.

Traffic Traffic

Ereignisabfolge erkennen, bevor die Ausführung scheitert

Katastrophale Ausfälle treten selten ohne Vorwarnung auf. Schon früh zeigen sich erste Anzeichen dafür, sodass Sie durch die Auswertung korrelierter Telemetriedaten gewarnt werden können, solange noch Zeit bleibt, die Ausführung zu retten, bevor sie in der 47. Stunde abgebrochen wird.

Wissen, was in Ordnung und was gefährdet ist Wissen, was in Ordnung und was gefährdet ist

Wissen, was in Ordnung und was gefährdet ist

Beobachten Sie die Verfügbarkeit und den Zustand des gesamten KI-Stacks, damit Beeinträchtigungen frühzeitig erkannt werden. Erkennen Sie steigende ECC-Werte oder eine Cache-Auslastung, bevor die Ausführung in Stunde 47 abgebrochen wird.

Splunk als Basis, Cisco für die Korrelation Splunk als Basis, Cisco für die Korrelation

Splunk als Basis, Cisco für die Korrelation

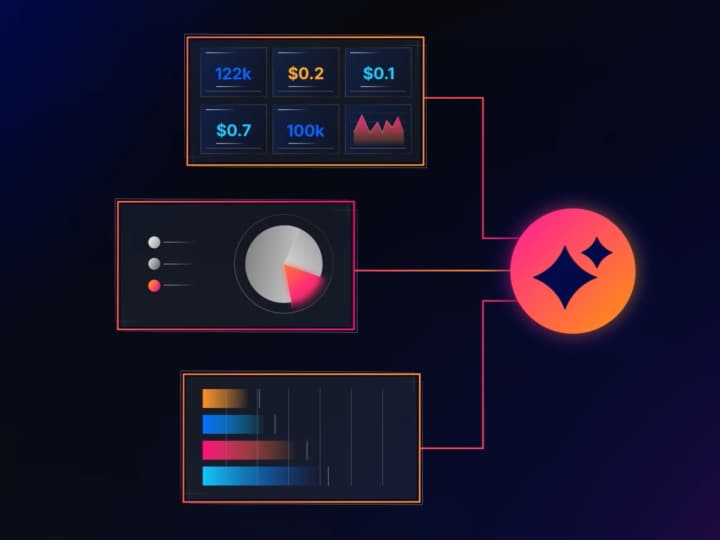
Zweckspezifische KI-Tools sehen Prompts, nicht aber den physischen Chip. Allgemeines Monitoring gilt der GPU, nicht jedoch der Argumentation des Agenten oder der Netzwerkstruktur. Splunk und Cisco umfassen den gesamten Stack. Eine falsche Antwort und der Chip, der sie hervorgerufen hat, zeigen sich an einem zentralen Ort.


Ressourcen
Mehr von Splunk

Agent Observability und Tracing – FAQs

Beim Tracing wird eine einzelne Anfrage von Anfang bis Ende über einen Workflow mit mehreren Agenten verfolgt, wobei jeder Tool-Aufruf, jedes Modell und jeder Abrufschritt zusammen mit der Argumentation des Agenten erfasst werden und dieses Verhalten dann mit der Infrastruktur verbunden wird, auf der es ausgeführt wurde.

Die Ursache verbirgt sich meist unterhalb der Anwendungsschicht in Form eines von vier Punkten: Das Modell war falsch, der Agent hat etwas getan, was er nicht sollte, das Ganze hat im Stillen ein Vermögen gekostet oder die Hardware hat gestreikt.

Ja. Ein Anstieg des Token-Verbrauchs, eine ausgelastete GPU und eine Latenzspitze können auf einer Zeitachse aufgetragen werden, sodass eine langsame oder fehlgeschlagene Ausführung auf ihre wahre Ursache und nicht nur auf ein Symptom hindeutet.

Wenn Sie Open-Weight-Modelle auf Ihrer eigenen Hardware ausführen, gibt es keine Statusseite des Anbieters, auf der Sie nachsehen können. Mithilfe korrelierter Telemetriedaten können Sie einen Ausfall bis zum Chip zurückverfolgen und frühe Anzeichen wie eine steigende Zahl von ECC-Fehlern erkennen, bevor eine bereits lange laufende Ausführung abgebrochen wird.

Splunk Agent Observability basiert auf der Splunk-Datenplattform und korreliert mit der Cisco-Infrastruktur, sodass das Trace mit der Argumentation des Agenten, die Ausgabequalität, die Kosten sowie die zugrunde liegenden GPUs, Vektordatenbanken und Netzwerkstruktur alle in einem einzigen Aufzeichnungssystem vorliegen.

Ähnliche Produkte

Splunk Cloud Platform

Daten, Kontext und Aktionen domänenübergreifend vereinheitlichen.

Mehr erfahren

Splunk Enterprise Security

Einheitliche Bedrohungserkennung, -untersuchung und -reaktion (TDIR) für das agentenbasierte SOC.

Mehr erfahren

Splunk IT Service Intelligence

IT-Probleme mit KI-gestütztem Service-Monitoring prognostizieren und verhindern.

Mehr erfahren
Erste Schritte mit Splunk

Finden der Kernursache – von der Argumentation bis zur GPU

Demo anfordern
Kostenlose Testversionen entdecken