fonctionnalités
Visualisez toute la pile, du raisonnement au GPU

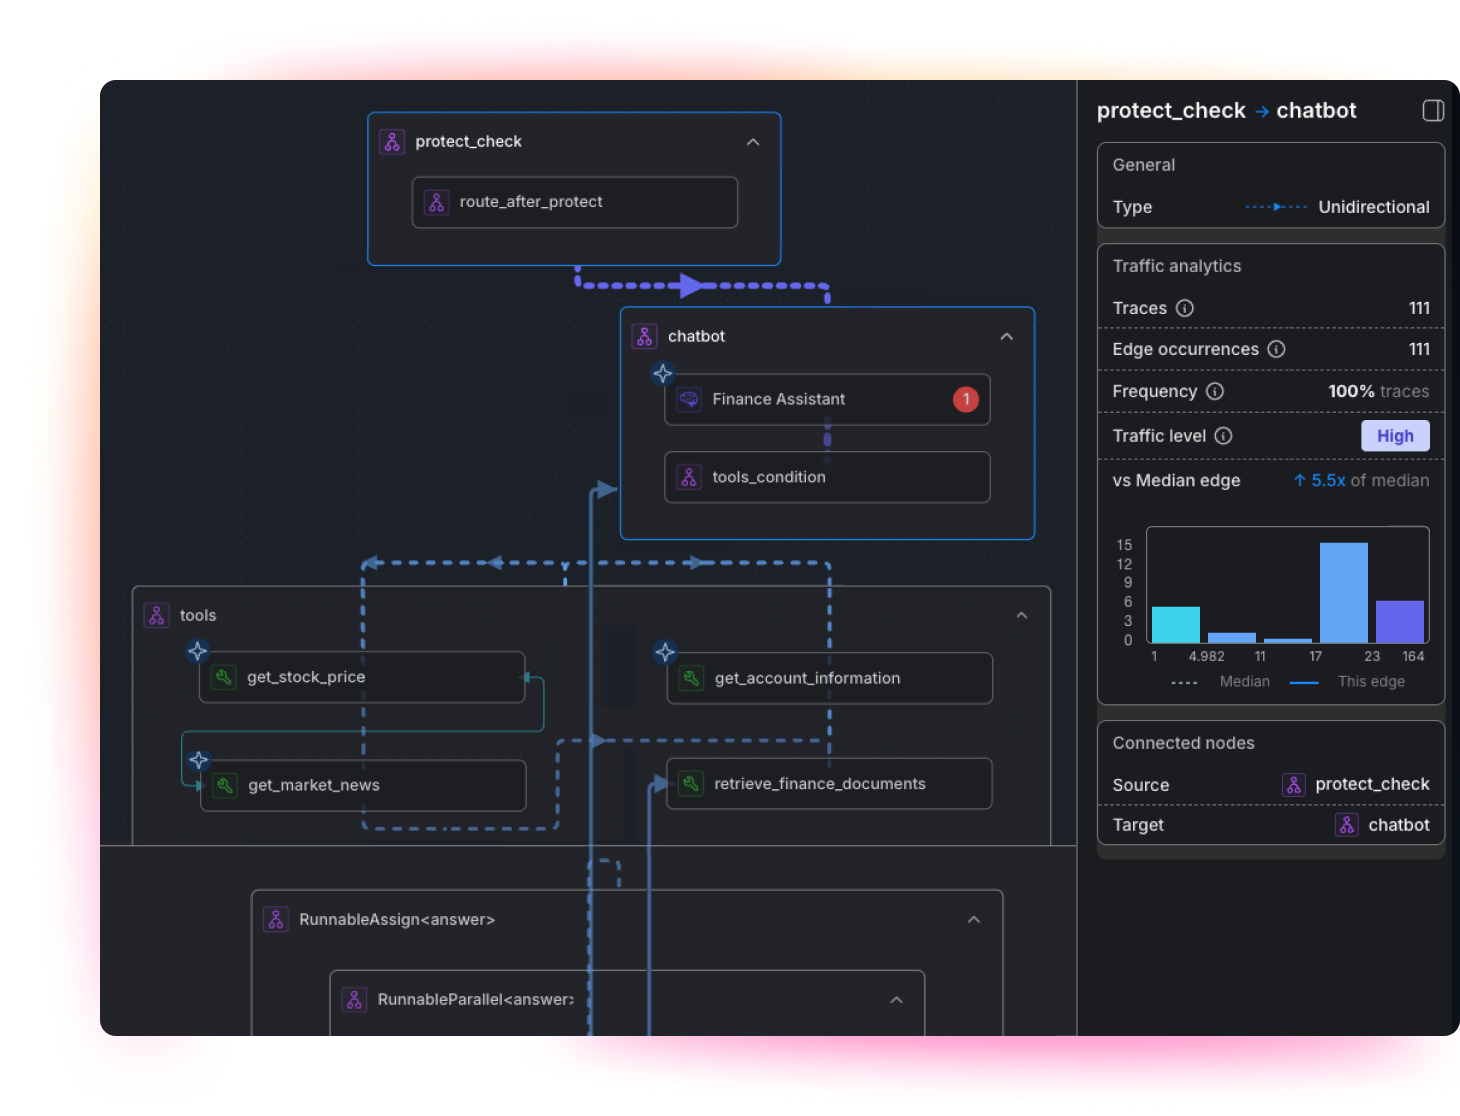
Suivez un agent du raisonnement au GPU
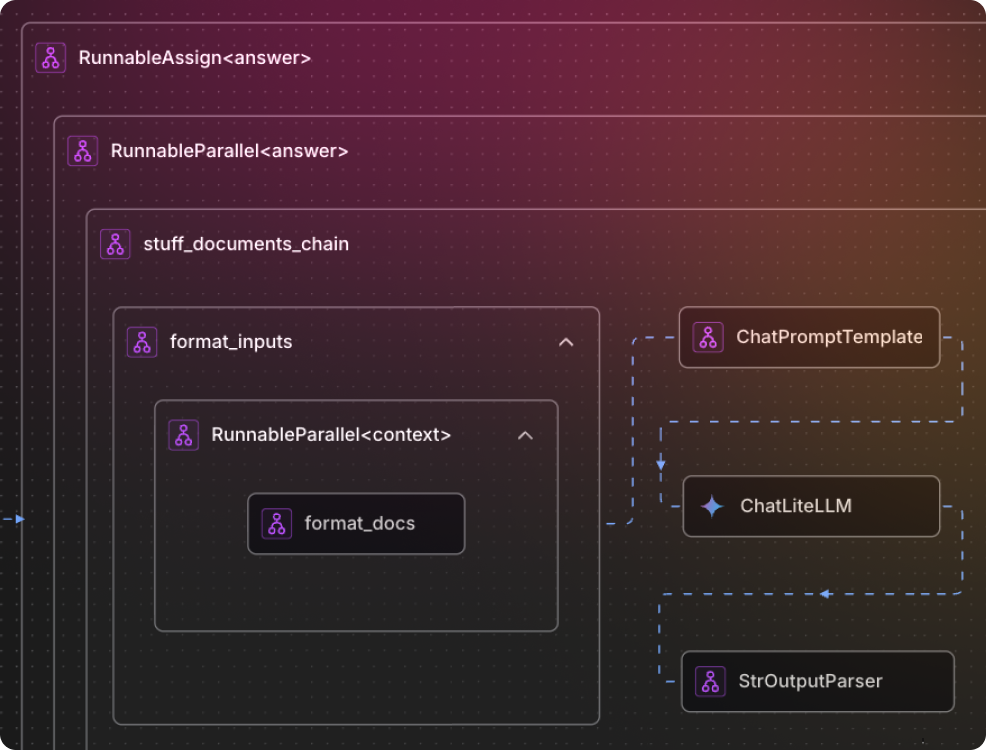
Consultez les appels d’outils, les modèles et les étapes de récupération d’un workflow de la requête à la réponse, puis reliez ce comportement à l’infrastructure sous-jacente. L’analyse de la cause profonde se fait sur une même chronologie, pas dans quatre outils déconnectés.
Visualisez l’infrastructure sous-jacente
Suivez l’utilisation des GPU et de la mémoire, la consommation d’électricité et le délai jusqu’au premier token des modèles, des bases de données vectorielles et du reste de votre pile d’IA. Lorsqu’un pic dans la consommation de tokens coïncide avec un GPU saturé, la latence de la réponse n’a plus rien de mystérieux.
Parcourez toutes les étapes d’un échec d’exécution
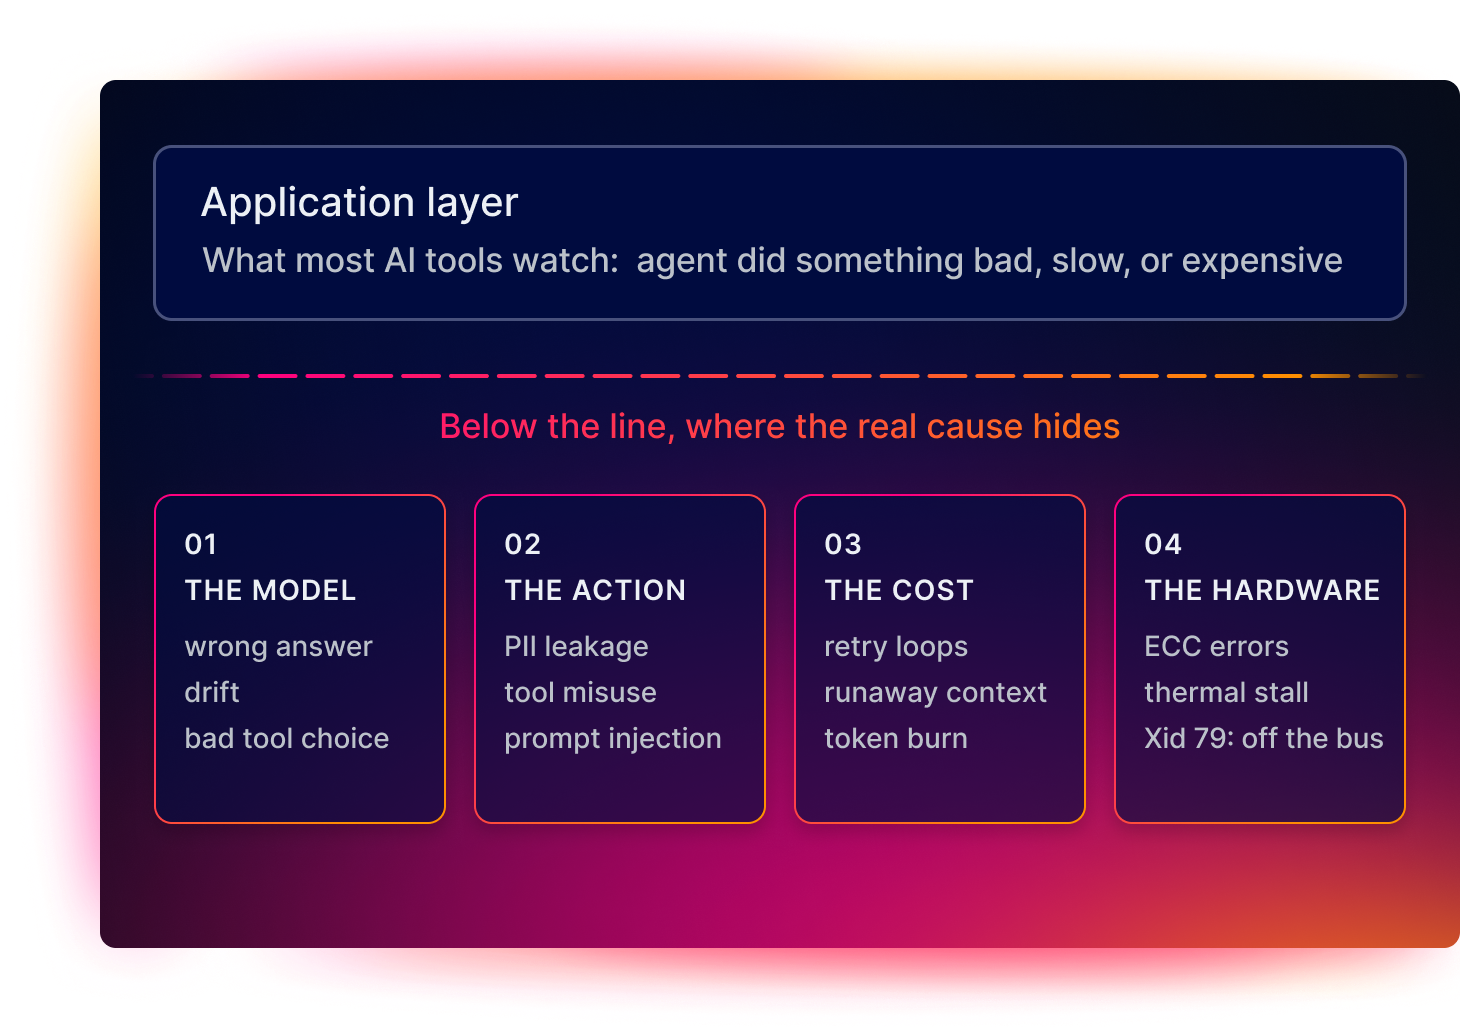
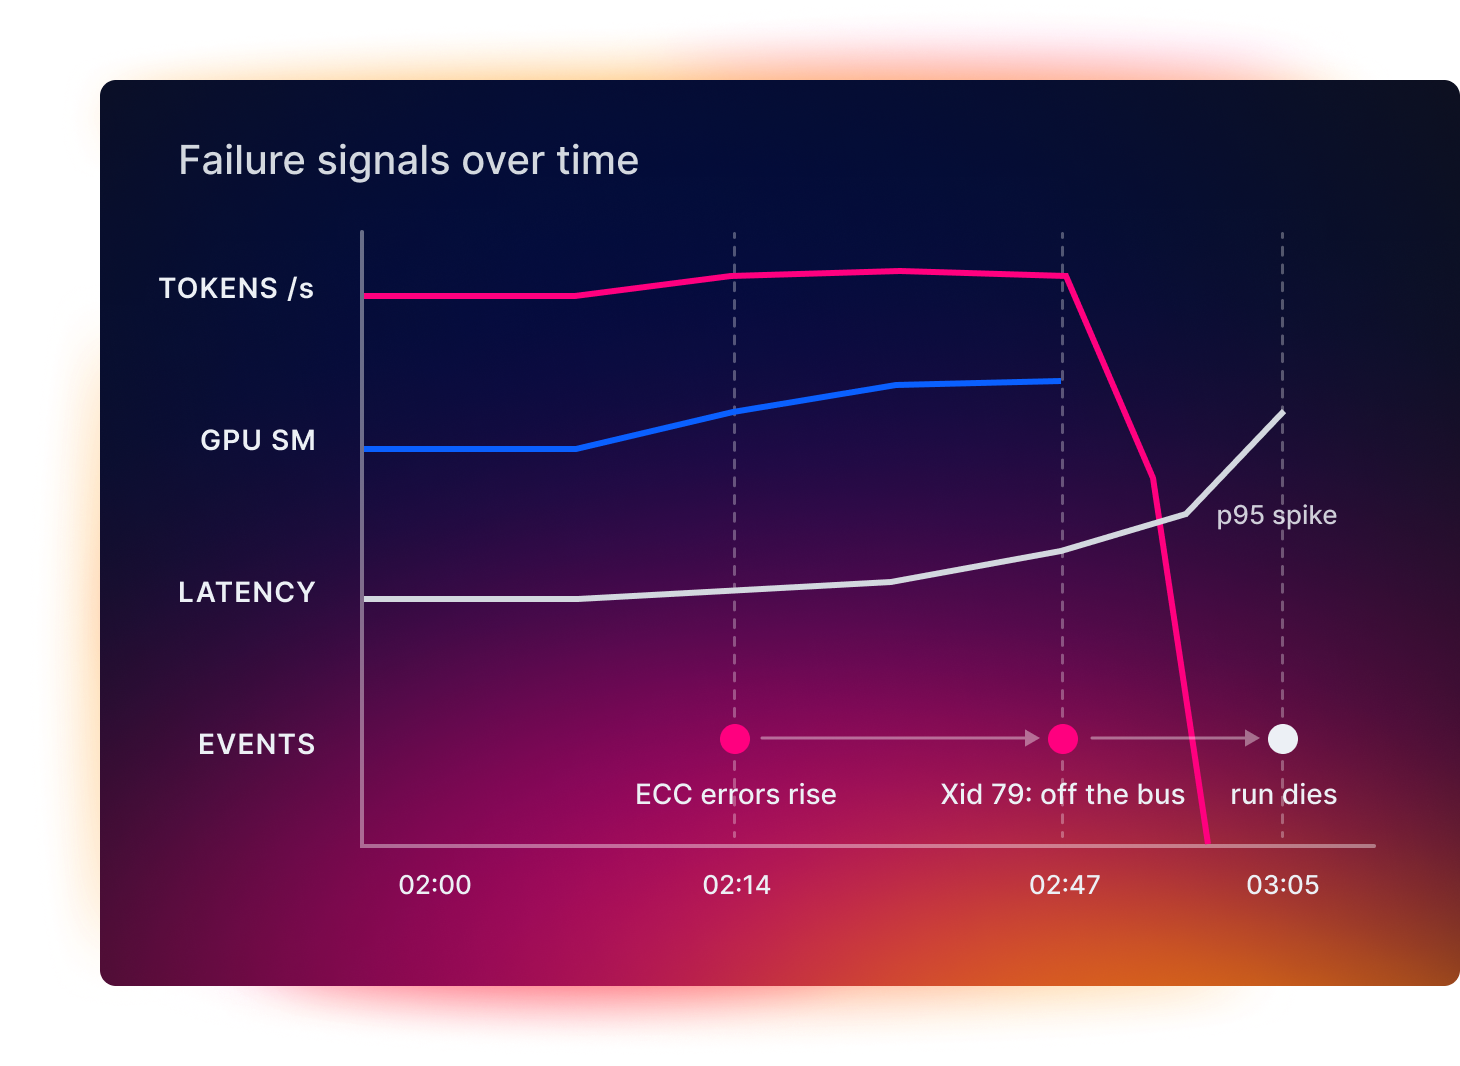
Parcourez une chronologie unique réunissant aussi bien un pic ECC qu’une anomalie thermique ou électrique, un Xid 79 qu’un échec d’exécution, et visualisez côte à côte la trace de l’agent et la télémétrie du GPU. Une seule vue pour répondre à la question : « Pourquoi est-ce que cela a échoué ? ».

Visualisez la cascade avant l’échec de l’exécution
Les échecs catastrophiques arrivent rarement sans s’annoncer. Les signaux avant-coureurs sont souvent visibles et la télémétrie peut vous avertir tant qu’il est encore temps de sauver une exécution avant qu’elle n’échoue à la 47e heure.

Sachez quels éléments du système fonctionnent et lesquels sont précaires
Supervisez la disponibilité et l’intégrité de la pile d’IA pour détecter les dégradations au plus tôt. Repérez la hausse du nombre d’ECC ou la saturation d’un cache avant qu’elles ne fassent échouer l’exécution à la 47e heure.

Bâti sur Splunk, corrélé avec Cisco
Les outils purement dédiés à l’IA voient les prompts, mais jamais la puce. La supervision généraliste voit le GPU, mais pas le raisonnement de l’agent ni le tissu du réseau. Splunk et Cisco couvrent l’intégralité de la pile pour afficher au même endroit une réponse erronée et la puce qui l’a produite.