splunk background

évaluation

Évaluation des agents et des modèles

Évaluez la justesse, la sécurité et l’utilisation des outils dans chaque interaction d’agent en production, sans échantillonnage.

Édition gratuite Bénéficiez d’Observability Cloud gratuitement pour 15 hôtes.
Suivre la visite guidée Vous avez 5 minutes ? Découvrez son fonctionnement.
pd-ao-eval-hero-d

Corrigez les problèmes avant qu’ils n’atteignent vos clients

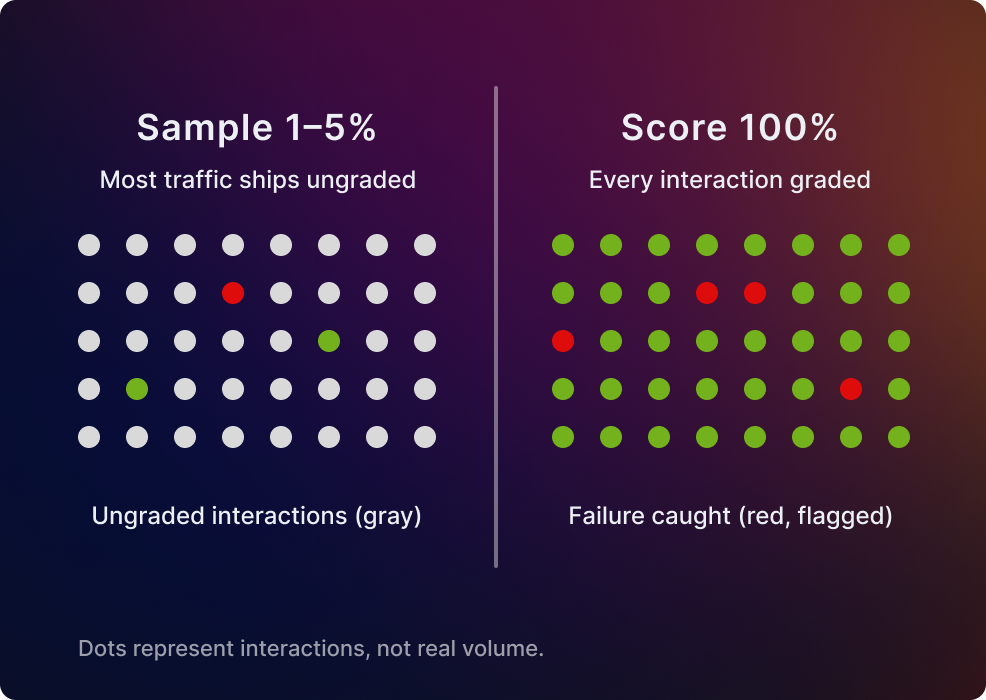
Lorsque le juge est un petit modèle plutôt qu’un LLM frontière, l’évaluation de chaque interaction devient abordable. Pas d’échantillonnage, aucun angle mort.

Évaluez chaque interaction, sans échantillonnage

Oubliez les LLM frontière : Luna est un petit modèle qui offre un moyen économique d’évaluer chaque requête en production au lieu de miser sur un échantillonnage hasardeux. Évaluez la justesse, la sécurité et l’utilisation des outils sur 100 % du trafic.

Adaptez les évaluateurs à vos critères

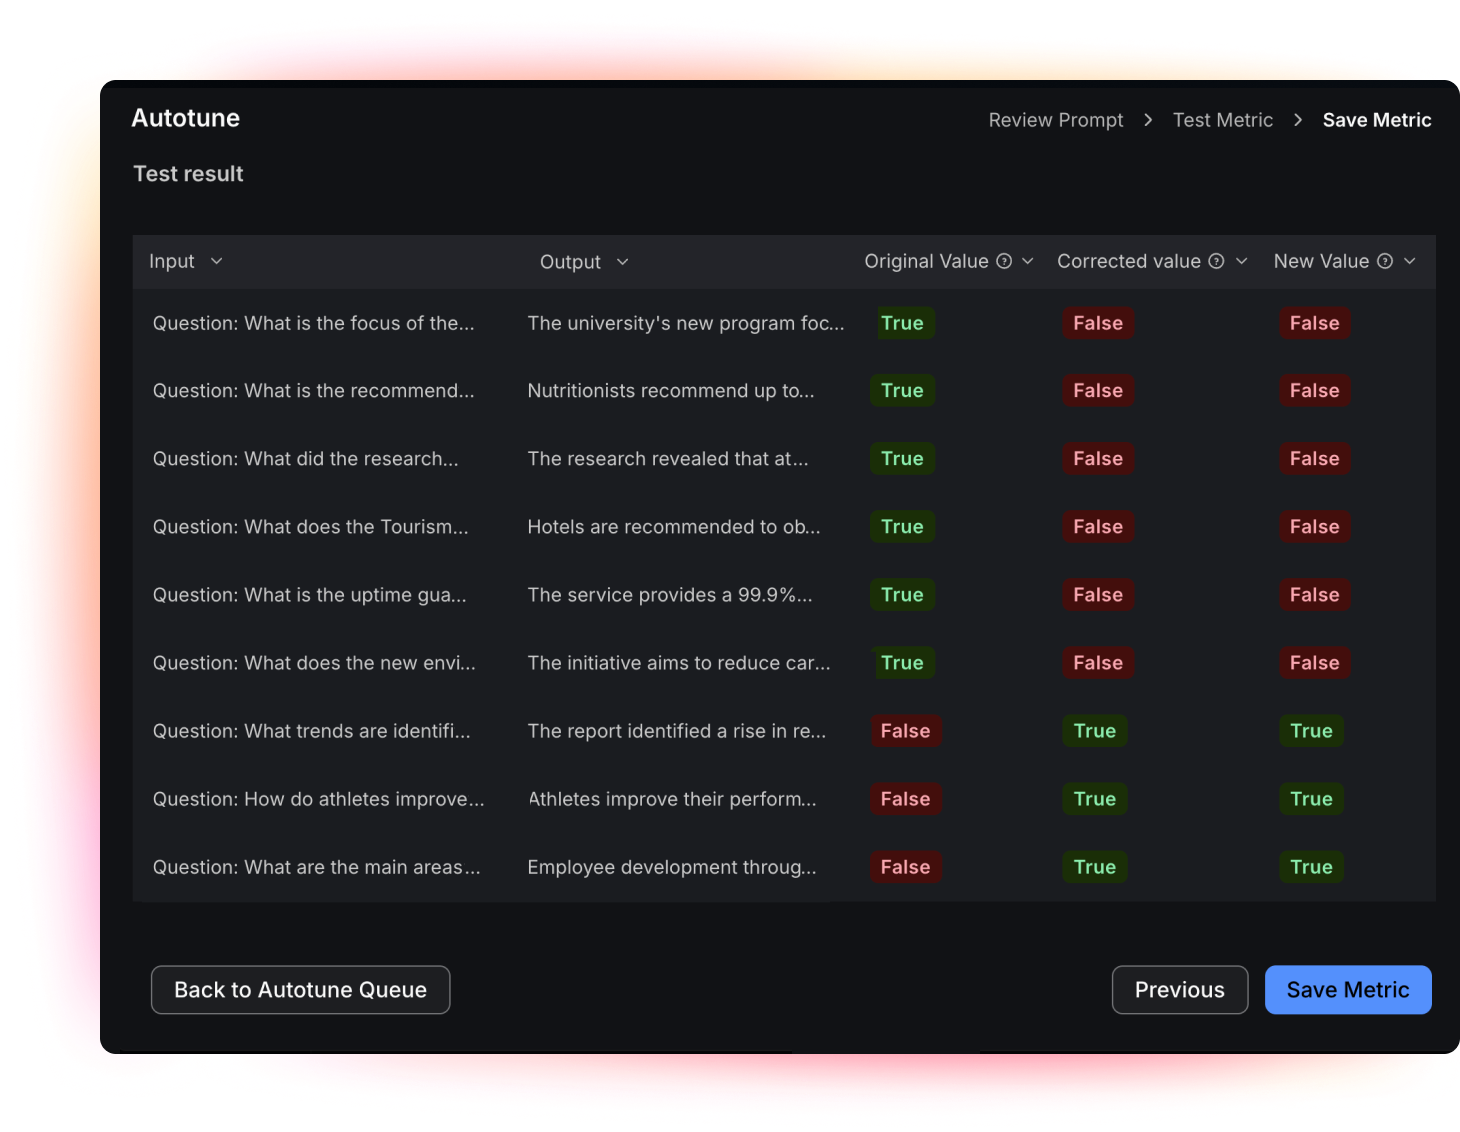
Les métriques prêtes à l’emploi reflètent rarement les normes de qualité d’un domaine spécifique. Avec Autotune, l’évaluateur s’adapte à vos standards, pour que les scores correspondent réellement à la façon dont votre équipe juge le travail.

Évaluez la qualité parallèlement à la latence, aux erreurs et au coût

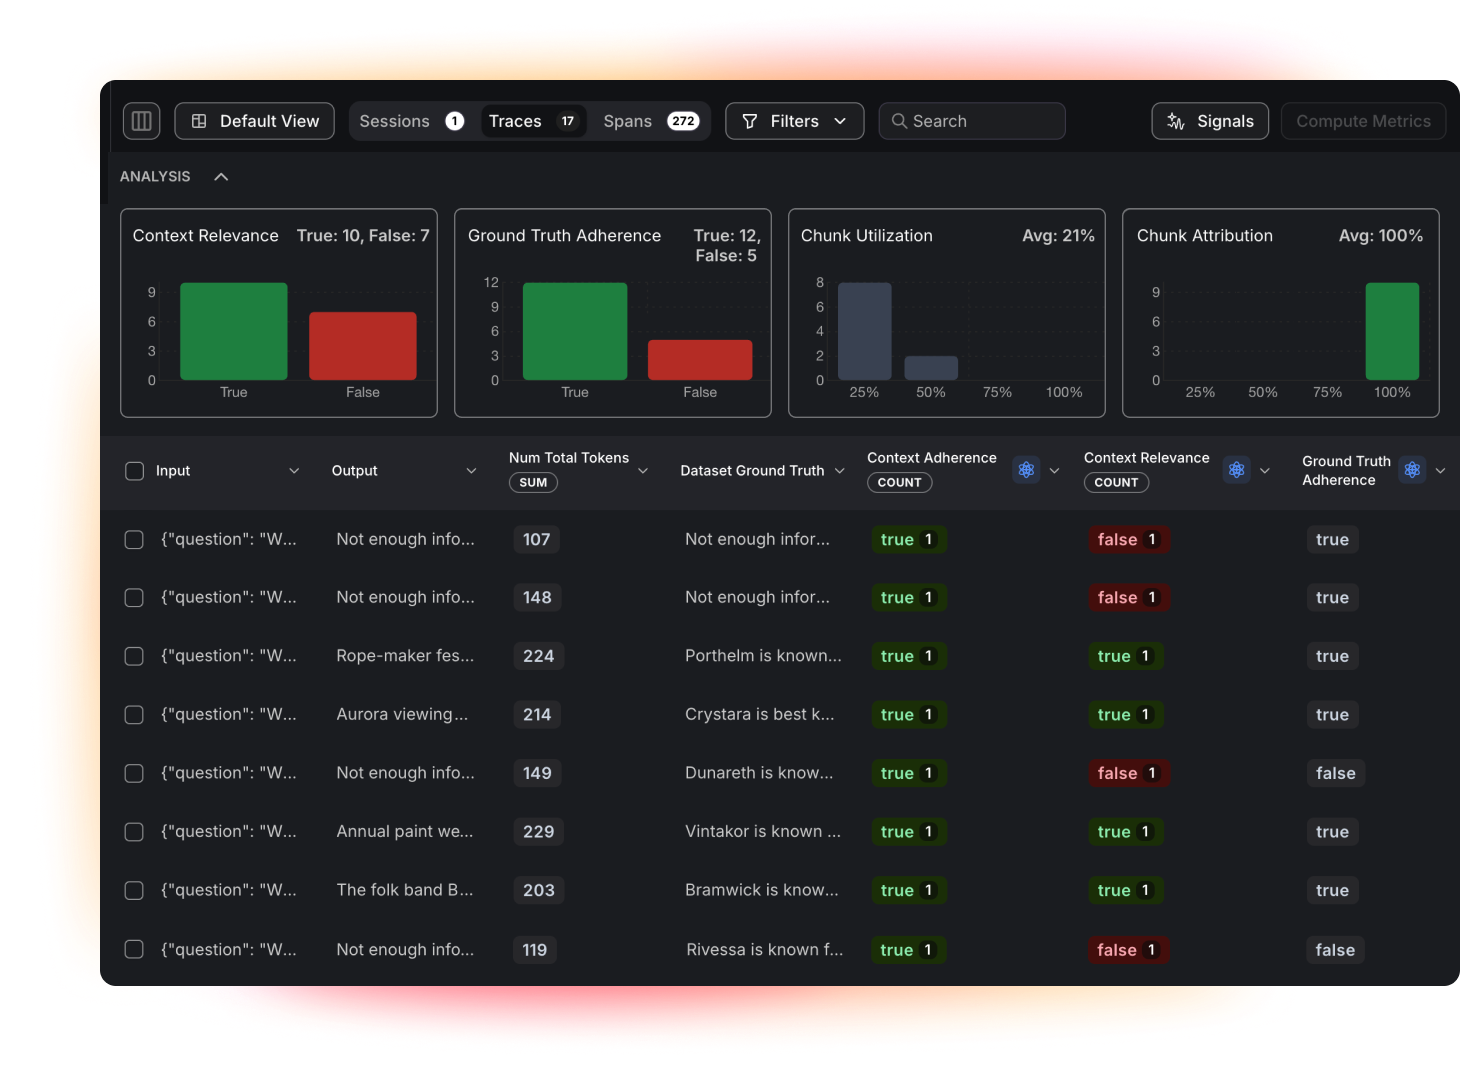
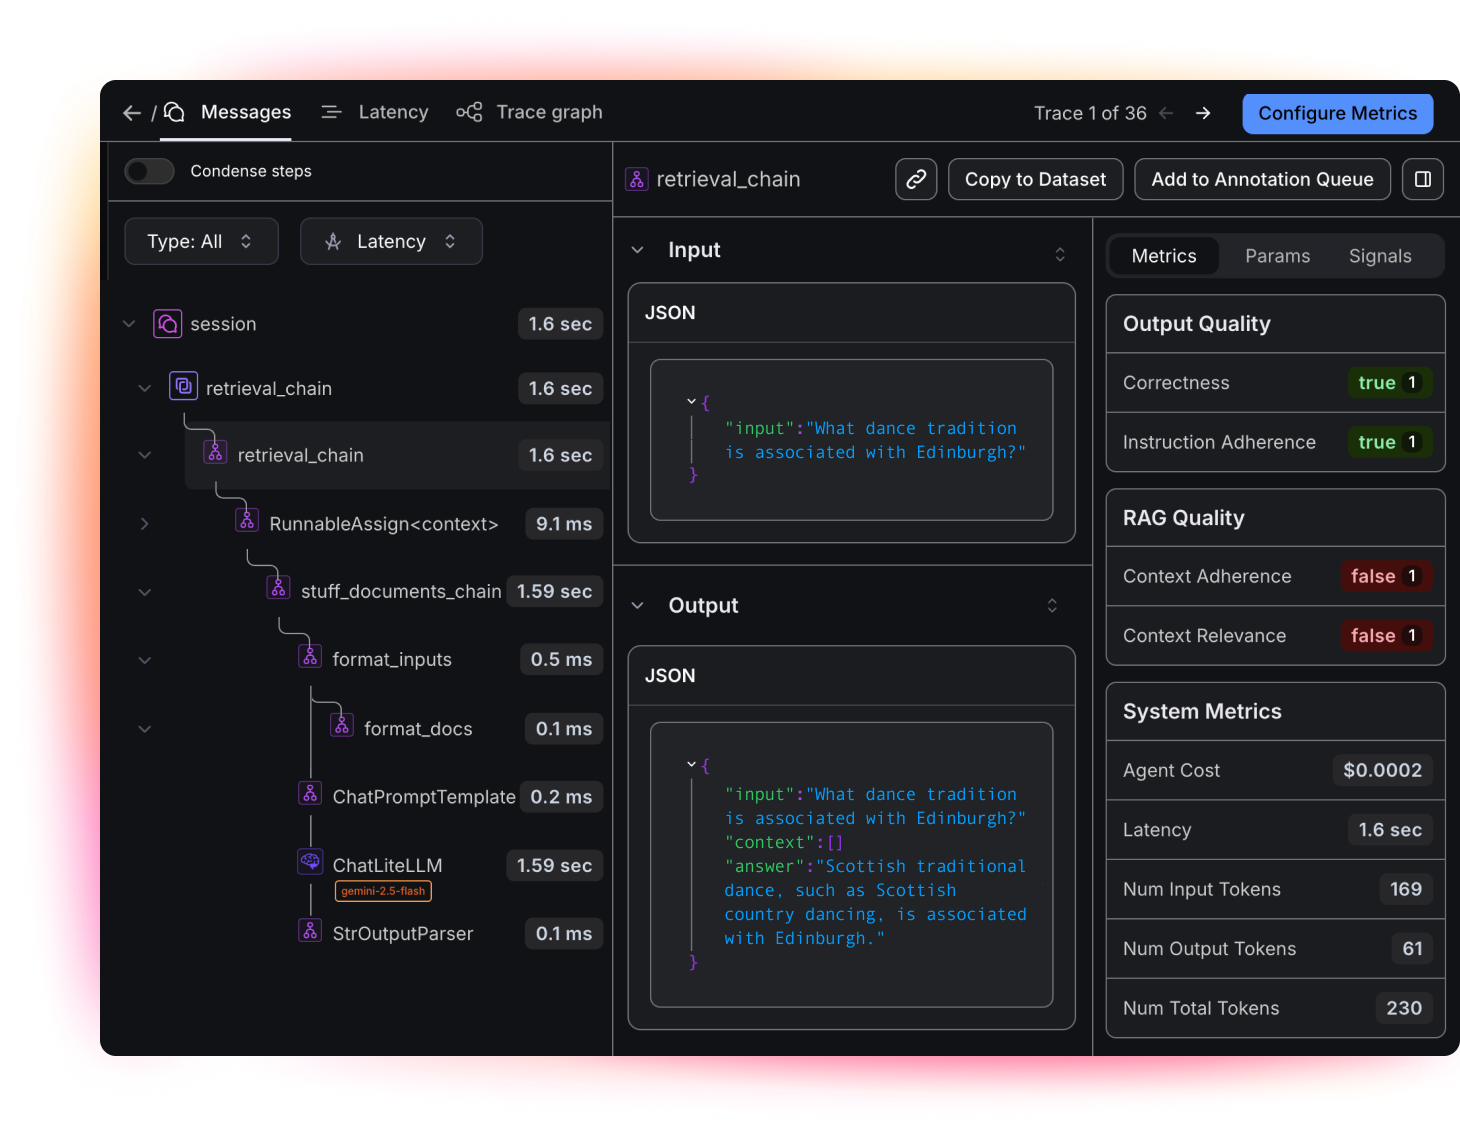
Tous les scores d’évaluation figurent dans la même trace que la latence, les erreurs et le coût en tokens : vous ne voyez pas seulement si une réponse était correcte ou non, vous savez aussi combien elle a coûté et le temps qu’il a fallu pour l’obtenir. Obtenez une vue unifiée de la qualité et de la performance, pas quatre outils déconnectés.

image promo .conf26

Regardez les présentations de .conf26 à la demande

Découvrez les conseils des experts de Splunk et des leaders du secteur à l’ère de l’agentique.

Voir dès maintenant

fonctionnalités

Vérifiez que vos agents sont dans le vrai avant et après la livraison

Lire la documentation
continuous-auditing continuous-auditing

Notez les erreurs des agents

Notez l’achèvement des actions, le choix des outils, l’importance des hallucinations, le respect de la RAG et bien d’autres critères. Utilisez nos métriques prédéfinies ou rédigez les vôtres, et affichez les scores parallèlement à la latence, aux erreurs et au coût sur une même trace.

Blog Blog

Ajustez l’évaluateur en ligne, sans solliciter de data scientist

Corrigez les scores erronés directement sur la trace pour qu’Autotune mette à jour l’évaluateur. Épargnez-vous les projets d’étiquetage et les transferts à l’ingénierie de prompt. À partir de 5 exemples environ, la précision atteint 95 %, avec des hausses d’environ 10 à 17 points F1.

performance-temps-réel performance-temps-réel

Exécutez des expérimentations et des tests A/B

Comparez les prompts, les modèles et les versions d’agent en appliquant les mêmes évaluations avant qu’ils n’atteignent la production. Découvrez quelles modifications ont bien amélioré la correction et l’utilisation des outils au lieu de faire des conjectures à partir de vérifications ponctuelles.

reduce-cyber-security-threats reduce-cyber-security-threats

Vos évaluations fiables deviennent des garde-fous

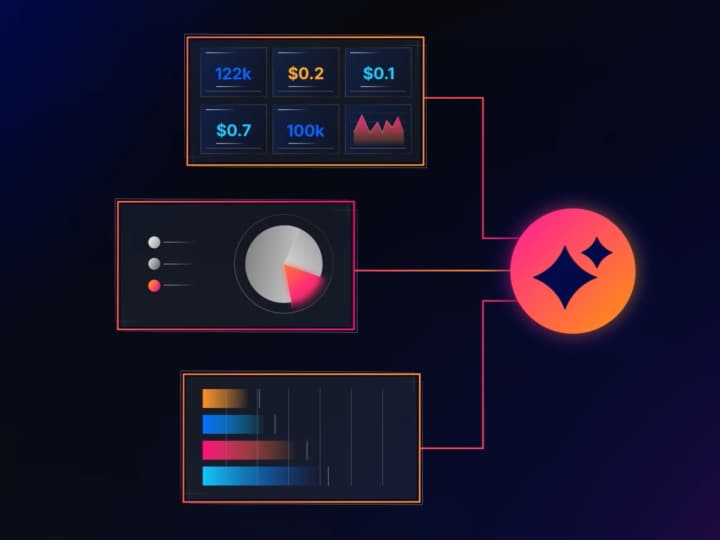
Une évaluation qui donne un score fiable pendant les tests devient un mécanisme de contrôle en production. Donnez-lui le statut de vérification en cours d’exécution pour qu’elle arrête les opérations nuisibles avant le déclenchement de l’outil.
Visualiser les garde-fous


Ressources
En savoir plus sur Splunk

Qu’est-ce que l’ingénierie d’évaluation ?

Lire le blog

FAQ sur l’évaluation des agents

L’évaluation des agents attribue un score à ce qu’un agent a réellement fait : achèvement des actions, choix des outils, hallucinations et respect de la RAG. Vous avez toutes les informations pour déterminer s’il a bien fonctionné, sans avoir à le deviner à partir de contrôles ponctuels.

Avec l’échantillonnage, l’essentiel du trafic échappe à l’évaluation et les échecs qui atteignent vos clients proviennent généralement dans la portion que personne n’a inspectée. Comme le juge est un petit modèle plutôt qu’un LLM frontière, vous pouvez vous permettre d’évaluer chaque interaction plutôt qu’une sélection hasardeuse.

Oui. Avec Autotune, il vous suffit de corriger une poignée de scores directement sur la trace pour que l’évaluateur s’adapte à vos standards, sans projet d’étiquetage ni recours à l’ingénierie de prompt.

Une évaluation qui produit des scores fiables en phase de test peut-être promue au statut de contrôle en cours d’exécution. Elle pourra alors bloquer ou rediriger les actions néfastes avant le déclenchement de l’outil. L’avantage de cette méthode : il n’y a pas de modèle d’exactitude dédié à maintenir.
Oui. Réalisez des expérimentations et des tests A/B pour comparer les prompts, les modèles et les versions d’agent à l’aide des mêmes évaluations pour voir quels changements ont amélioré l’exactitude des résultats.

Produits connexes

Splunk Cloud Platform

Unifiez les données, le contexte et l’action, tous domaines confondus.

En savoir plus

Splunk Enterprise Security

Unifiez la détection des menaces, l’investigation et la réponse pour le SOC agentique.

En savoir plus

Splunk IT Service Intelligence

Prédisez et anticipez les problèmes informatiques avec la supervision des services pilotée par l’IA.

En savoir plus
Bien démarrer avec Splunk

Évaluez toutes les interactions des agents pour livrer en toute confiance.

Demander une démonstration
Découvrir les essais gratuits