C’est quoi Cisco Data Fabric : les fondamentaux
Tips & Tricks José N’GoranLors de notre événement annuel .conf 2025, le 8 septembre à Boston, Cisco et Splunk annonçaient Cisco Data Fabric : « une nouvelle architecture révolutionnaire qui permettra aux organisations d’exploiter toute la valeur des données machine grâce à l’IA ».
Un an après cette annonce, à l’heure de .conf26 et des nouvelles annonces, il me semble pertinent de revenir sur cette architecture, à la fois pour faire un état des lieux et proposer une lecture simplifiée de la vision.
Le parcours de vie de la donnée
Pour délivrer toute sa valeur et toute sa richesse, la donnée passe par différentes étapes que l’on peut présenter ainsi :
Collecte → Traitement et routage → Ingestion et indexation → Recherche et corrélation → Visualisation
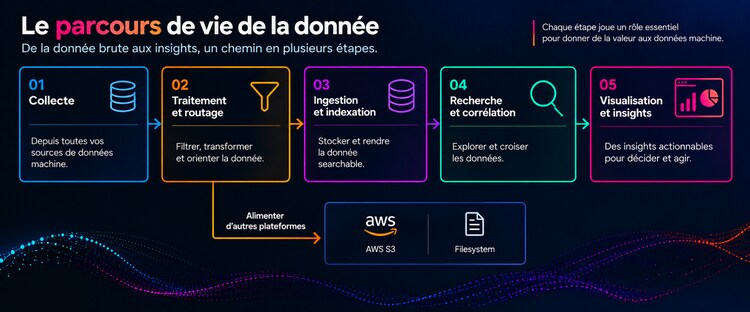
Bien que certaines de ces phases soient relativement évidentes, il convient d’en clarifier quelques-unes.
Traitement et routage
La donnée collectée est initialement une donnée brute. Elle peut contenir des informations sensibles. Il est donc nécessaire de disposer de capacités permettant de la masquer, de la filtrer ou, plus généralement, de la transformer avant de poursuivre son parcours.
Une fois cette donnée transformée, il peut être décidé, pour des raisons de coûts, de politique ou d’usage, de l’orienter vers une plateforme (ex. : AWS S3)
C’est la phase de routage.
Ingestion et indexation
Il est particulièrement important de distinguer et de dissocier ces deux termes pour la suite de cette lecture.
L’ingestion revient simplement à absorber la donnée après sa phase de traitement.
L’indexation, quant à elle, consiste à stocker la donnée en l’enrichissant de métadonnées (ajout d’un marqueur de temps, de provenance, de type, etc.) dans des buckets qui serviront ensuite à sa recherche en temps réel, tout en construisant, en parallèle, le lexique permettant de faciliter cette recherche.
Cette distinction entre ingérer et indexer est fondamentale. Nous verrons pourquoi un peu plus loin.
Visualisation
La donnée indexée peut ensuite être recherchée, corrélée et manipulée via différentes opérations (statistiques, etc.) avant d’être présentée sous forme de dashboard.
Pourquoi est-il important de disséquer certaines phases de ce cycle de vie ?
Parce que certaines d’entre elles concentrent précisément les problèmes auxquels Cisco Data Fabric tente d’apporter une réponse.
Le premier challenge : faut-il vraiment tout indexer ?
La phase d’ingestion, aujourd’hui étroitement liée à celle de l’indexation, devient particulièrement coûteuse lorsque l’on tient compte des volumes croissants de données générées par les machines, qui nécessitent des investissements importants en ressources de stockage.
Cela conduit les organisations à devoir arbitrer très en amont sur la donnée à collecter et à indexer.
Cela représente un véritable casse-tête pour les équipes opérationnelles.
Elles doivent être extrêmement fines dans leur sélection, tout en acceptant une conséquence importante : la donnée que l’on choisit de ne pas conserver aujourd’hui pourrait justement être celle dont on aura besoin demain.
Or, par définition, il est difficile de prévoir toutes les questions que nous poserons à nos données dans six mois, un an ou trois ans.
Le second challenge : la donnée est déjà partout
La plupart des organisations ont fait, parfois très tôt, des choix concernant leur stratégie de stockage de la donnée existante.
Ces choix répondent à des raisons économiques (notamment en lien avec le point précédent), mais également à des enjeux métiers, réglementaires ou d’accessibilité pour d’autres plateformes.
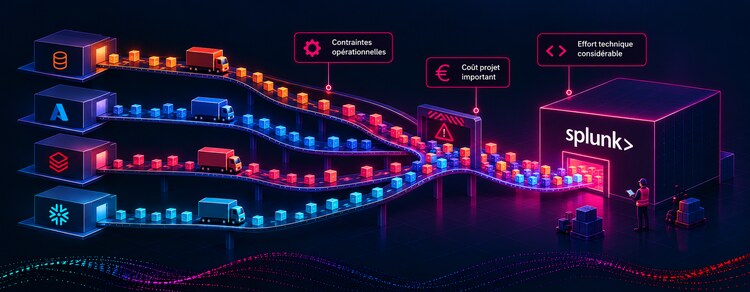
On retrouve donc naturellement différents points de stockage de données au sein des systèmes d’information : Azure Blob Storage, Amazon S3, Databricks, Snowflake, etc.
Demander à une organisation de rapatrier l’ensemble de cette donnée vers une plateforme unique (par exemple Splunk Enterprise) serait difficilement envisageable.
Cela représenterait un coût projet important, des mouvements massifs de données, des contraintes opérationnelles et un effort technique considérable.
Alors, comment répondre à ces deux problématiques majeures ?
Et si, dans un monde idéal, il était possible de consommer la donnée là où elle se trouve ?
Et si, dans un monde idéal, il était possible d’ingérer plus librement et d’arbitrer plus tard sur les données dont nous avons réellement besoin immédiatement ?
C’est précisément la promesse de Cisco Data Fabric.
Les fondamentaux de Cisco Data Fabric
Cisco Data Fabric est une architecture essentiellement construite sur la plateforme de données de Splunk, communément appelée Splunk Core.
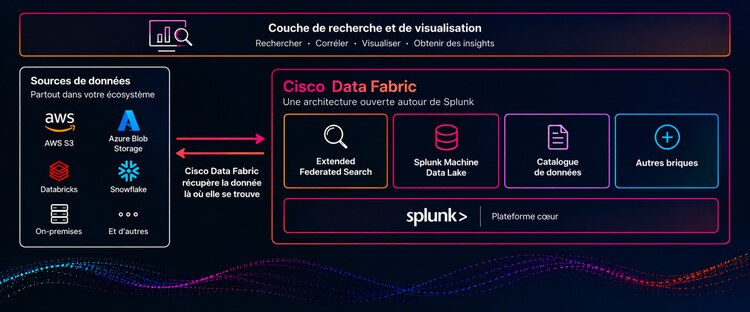
Je propose pour cet exercice, de retenir que l’idée principale consiste à étendre les capacités de cette plateforme avec trois briques fondamentales.
Limiter la réflexion à ces trois briques est un parti pris pédagogique, qui vise à honorer l’engagement pris au début de cet article : simplifier la lecture du sujet.
Cela ne signifie évidemment pas que les autres briques sont moins importantes.
En effet, Cisco Data Fabric regroupe également d’autres notions comme la gestion des données, la contextualisation, l’enrichissement pour l’IA…
La volonté ici est de mettre en évidence les nouveautés majeures qui structurent cette architecture.
Extended Federated Search : aller vers la donnée plutôt que déplacer la donnée
La première capacité est celle de réaliser des recherches fédérées vers différents points de stockage, sans avoir à rapatrier systématiquement la donnée vers Splunk.
En d’autres termes, depuis la couche de recherche et de visualisation, il devient possible d’interroger des données présentes dans différents environnements (AWS S3, Snowflake, Databricks, etc.), puis de les corréler afin d’en extraire et d’en présenter les insights pertinents.
La logique change donc sensiblement : au lieu de déplacer systématiquement la donnée vers la plateforme qui doit l’interroger, on donne à la plateforme la capacité d’aller vers la donnée.
Splunk Machine Data Lake : ingérer maintenant, décider plus tard
La deuxième brique est Splunk Machine Data Lake.
L’objectif est de pouvoir ingérer de grands volumes de données machine à moindre coût, sans avoir à décider immédiatement que chacune de ces données mérite d’être indexée.
On peut ainsi conserver davantage de données et choisir, plus tard, de promouvoir vers la phase d’indexation les blocs de données dont on a réellement besoin pour les phases de recherche, de corrélation et de visualisation.
Autrement dit, on gagne en flexibilité dans l’arbitrage et dans le choix du moment où une donnée doit être indexée.
Plutôt que de se demander : « Dois-je conserver cette donnée aujourd’hui alors que je ne sais pas encore si elle me sera utile demain ? »
Nous nous rapprochons d’un modèle dans lequel il est possible d’ingérer aujourd’hui et décider plus tard.
Un catalogue de données : savoir ce que l’on a et où cela se trouve
Enfin, la troisième brique est le catalogue de données.
Pour pouvoir réaliser une recherche dans un environnement où les données sont stockées sur de multiples plateformes, il devient plus que nécessaire de savoir quelle donnée nous avons et où elle se trouve.
Cela peut sembler simple, mais cette capacité devient essentielle dès lors que l’on accepte que la donnée n’ait plus vocation à résider dans un emplacement unique.
Cisco Data Fabric en quelques mots
Si je devais finalement résumer Cisco Data Fabric, je le ferais ainsi : la donnée n’a plus nécessairement besoin d’être déplacée et indexée immédiatement pour avoir de la valeur.
Cisco Data Fabric cherche à donner aux organisations davantage de liberté sur où conserver leurs données, quand les indexer et comment les exploiter.
La philosophie est finalement assez simple : rencontrer nos clients là où ils en sont dans leur stratégie data, plutôt que de leur demander de reconstruire cette stratégie autour d’une plateforme et leur donner ainsi la possibilité de continuer à croître sereinement.
Pour continuer la réflexion sur le sujet, je vous invite à découvrir les articles ci-dessous :
- .conf26 : Splunk se réinvente pour l’ère de l’IA agentique
https://www.itforbusiness.fr/conf26-splunk-se-reinvente-pour-lere-de-lia-agentique-107397 - Avec la fédération des données, les équipes du SOC passent à l’offensive
https://www.splunk.com/fr_fr/blog/security/la-federation-de-donnees-offre-aux-equipes-soc-une-vitesse-d-attaque.html
Pour continuer votre développement autour de Splunk, je vous propose de mettre en lumière le fabuleux travail de Romain Valentin, Expert IA au sein de l’équipe Strategic Solutions Engineering :
- Tokenomics : le token, nouvelle monnaie de l’ère des agents
https://www.splunk.com/fr_fr/blog/artificial-intelligence/token-nouvelle-monnaie.html - L’économie des agents : quand les IA se paient entre elles
https://www.splunk.com/fr_fr/blog/artificial-intelligence/economie-agents-paiement-ia-autonome.html
Articles similaires
Splunker les données… pour la sécurité routière
Le Lundi avec Landy : Splunk Synthetic Monitoring
