Les mathématiques au service de la lutte contre la criminalité financière
Industries SplunkLa criminalité financière est devenue un sujet brûlant au cours des 12 derniers mois. En effet, les fraudeurs cherchent à exploiter les angles morts de la supervision des personnes, des processus et des technologies sur une surface d’attaque de plus en plus large, en raison de l’utilisation croissante des canaux (numériques) distants. Même avant son augmentation récente, le coût de la fraude et de la criminalité financière était déjà très élevé. Refinitiv estime son coût mondial à plus de 1 000 milliards de dollars par an, ce qui en fait une priorité pour toutes les entreprises dans la mesure où ce coût affecte directement la rentabilité.
L’élargissement de la surface d’attaque de la criminalité financière a fait grandir l’éventail des sources de données nécessaires pour identifier avec précision les activités suspectes. Il ne suffit plus de se concentrer sur les interactions individuelles, il est désormais essentiel de suivre les parcours (numériques) qui aboutissent aux délits financiers. Il faut donc incorporer une gamme de sources de données non structurées (logs web, logs d’authentification et logs d’applications) dans les analyses, car ces sources contiennent des informations clés.
Il ne fait plus de doute que les données et l’analyse jouent un rôle clé dans la réduction de la criminalité financière, et notamment la possibilité de corréler toutes les données pertinentes. Mais proposer des informations pertinentes est loin d’être chose facile ! Il existe un large éventail d’indicateurs de criminalité financière, répartis dans de multiples domaines, et tous doivent être supervisés pour identifier les activités qui justifient une investigation plus approfondie.
Splunk a créé un cadre pour identifier avec précision les entités (comptes, individus ou employés) qui se livrent à des comportements suspects, et nous le présentons ci-dessous.
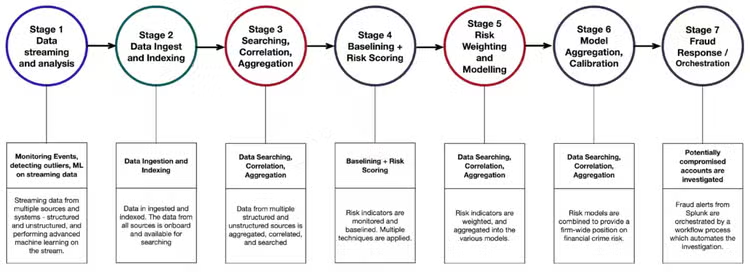
Ce cadre repose sur un impératif sous-jacent : vous devez être capable d’identifier, de capturer et d’analyser efficacement les données relatives à chaque indicateur de risque pertinent.
Mais qu’est-ce qu’un indicateur de risque ? D’après Wikipédia, c’est une « mesure du risque utilisée pour signaler de façon précoce l’augmentation de l’exposition au risque dans divers domaines de l’entreprise ». Et c’est exactement ce que notre cadre de lutte contre la criminalité financière cherche à faire : identifier les entités dont le comportement suggère un risque et qui justifient donc une investigation plus approfondie.
Voici quelques exemples d’indicateurs de risque :
- plusieurs échecs de connexion en peu de temps ;
- transactions ayant une valeur nettement supérieure ou inférieure à une transaction «typique» ; ou
- envoi de paiements à une entité figurant sur une liste de surveillance.
C’est seulement en observant tous les indicateurs de risque des entités que l’on peut prédire avec précision celles qui sont susceptibles d’avoir été compromises et donc d’être associées à un délit financier.
Chaque indicateur de risque ayant une importance variable pour l’entreprise, les analyses doivent en tenir compte. Notre cadre attribue un score de risque à chaque indicateur pour refléter son impact relatif. Par exemple, de nombreux cas de criminalité financière commencent par l’appropriation d’un compte. Vous souhaiterez donc sans doute attribuer un score de risque plus élevé aux principaux indicateurs de prise de contrôle de compte, comme une succession d’échecs de connexion sur une courte période.
Une fois les scores de risque établis, il faut ensuite réfléchir à la manière dont ils doivent augmenter lorsque les données sur lesquelles ils reposent deviennent de plus en plus préoccupantes, par exemple, s’il n’y a pas qu’un seul échec de connexion (potentiellement dû à une faute de frappe) mais deux, trois, quatre ou cinq. Dans cet exemple, un risque croissant est associé à chaque nouvelle tentative de connexion, donc le score de risque des échecs de connexion doit augmenter rapidement après le premier pour refléter la manière dont le risque se manifeste. C’est ici qu’interviennent les mathématiques car, pour cet indicateur, le risque augmente clairement de manière non linéaire.
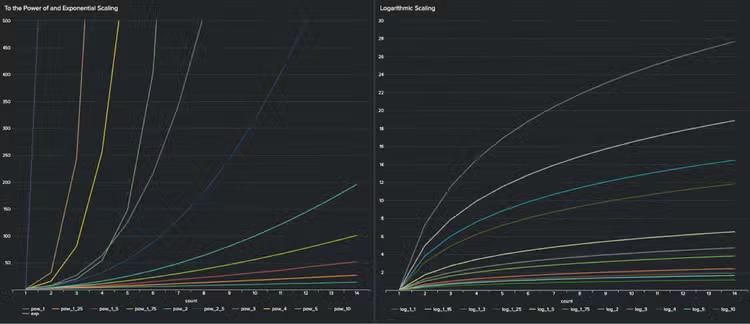
Différentes courbes mathématiques non linéaires peuvent être utilisées pour représenter l’augmentation du risque traduit par un indicateur individuel, dont certaines sont décrites dans le graphique ci-dessous. La série de courbes du côté gauche présente une accélération de l’augmentation (fonction carré, cube, exponentielle). Elles conviennent aux indicateurs dont le risque augmente rapidement avec des événements successifs, des transactions anormales par exemple. Les courbes du côté droit sont logarithmiques : le risque augmente rapidement après les premiers événements, mais le risque croissant finit par atteindre un plateau, comme dans le cas du nombre d’échecs de connexion.
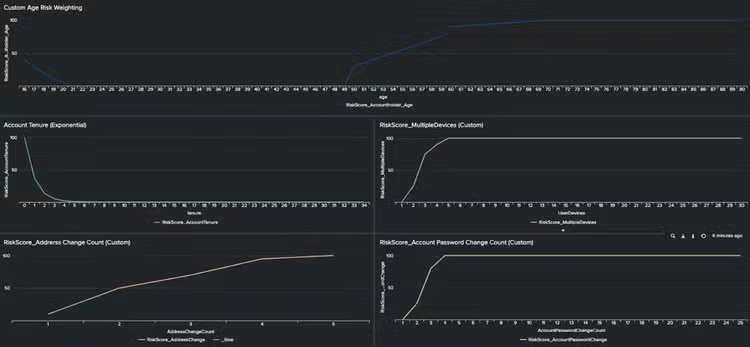
Nous présentons plus bas des exemples plus personnalisés de notation des risques que nous avons appliqués à des indicateurs individuels. Dans chacun de ces exemples, nous avons modifié la courbe pour refléter le risque associé à l’indicateur en question. Ce n’est qu’en sélectionnant la courbe la plus appropriée pour chaque indicateur de risque que nous pouvons évaluer avec précision le risque associé à une entité.
Une fois que tous les indicateurs de risque ont été définis, vous pouvez calculer un score de risque cumulé. C’est ce score cumulé qui identifie les entités les plus préoccupantes, c’est-à-dire celles qui méritent une investigation plus approfondie. Voyons un exemple de résultat.
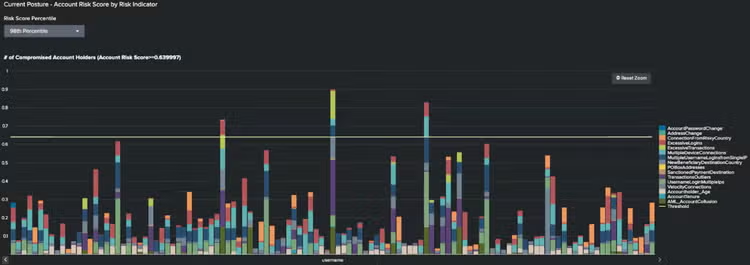
Dans cet exemple, il y a 15 indicateurs de risque. Le score de risque total de chaque entité est calculé en additionnant le score de risque de tous les indicateurs individuels. Seules les entités ayant les scores de risque les plus élevés justifieront une investigation plus approfondie. Pour identifier les entités à explorer en priorité, nous avons tracé une ligne au 99e centile dans cet exemple.
Cette approche peut être appliquée de manière systématique pour détecter la criminalité financière dans tout type d’entreprise. Elle offre une grande flexibilité dans la mesure où vous ne sélectionnez que les indicateurs de risque pertinents. Vous avez également la possibilité de modifier à la fois les indicateurs et l’approche d’évaluation des risques quand le besoin s’en fait sentir, par exemple pour refléter une évolution du marché ou de votre position.
Qu’attendez-vous pour vous lancer ? Il est temps de renouer avec votre matheux intérieur et de vous défendre !
*Cet article est une traduction de celui initialement publié sur le blog Splunk anglais.
Articles similaires

[PODCAST] Vers une data responsable : les enjeux économiques
Bâtir l’usine NextGen avec Splunk et Bosch Rexroth