エージェンティック時代に求められる新しいデータ基盤:シスコがSplunkと共に提供する方法
Platform Mangesh Pimpalkhare私たちは今、大きな転換点に立っています。2026年の時点で、テクノロジーリーダーの使命は、単にAIのポテンシャルを示すことから、信頼できるAIを使い具体的で測定可能なROIを引き出すことへと変化しています。しかし、現在の状況を見ると、壁に突き当たっています。Splunkが最近発表した調査、「マシンデータが切り拓く未来:企業におけるAIの運用化」(日本語版公開予定)では、回答者の 74% が、「AIと自動化によってデータ管理上の課題が中程度または深刻なレベルで生じている」と述べ、53%が、「AIや自動化された意思決定に必要なマシンデータが欠如した状況が頻繁にあるいは常に発生している」と述べました。
この業界はあまりにも長い間、すべての企業データをAIに読み込ませる必要があるという前提で動いてきました。つまり、断片化した膨大なデータセットを、一元化された単一のリポジトリに移動するということです。このモデルは崩壊しつつあります。この方法は、低速で桁違いのコストがかかるうえ、サイロ化したデータや不完全なデータでエージェントが動作すると、AIから信頼できない回答が出るリスクが増大する可能性があるからです。エージェントに与えられる運用コンテキストが断片化していたり不十分だったりする場合、エージェントは自信を持った回答を返しますが、それでも内容には原因、ビジネスへの影響、適切なアクションが欠けていることがあります。
企業には、データが存在する場所で分析を行い、複数ドメインにわたるシグナルを結び付け、統制されたAIの能力をデータに近いところで適用できる柔軟性が必要です。言い換えると、すべての企業データをAIに移動させる必要はありません。データがどこにあるかを問わず、AIの力をデータの近くで発揮させることが必要なのです。
このたび.conf26で、分散したマシンデータをAI向けの信頼できる運用コンテキストに変換するうえで、Splunkがどのように役立つかを発表します。私たちは、Cisco Data Fabric powered by the Splunk Platformの基盤データアーキテクチャを活用して、データが存在する場所での分析を低コストで行い、複数ドメインにわたりリアルタイムでデータを結び付け、マシンデータをモデルトレーニングと統制されたエージェンティックアクション用に変換できるようお客様を支援しています。
これは、デジタルレジリエンスをエージェンティック時代のために再定義したものです。つまり、マシンデータをエージェントによるアクションへと変換し、信頼できるAIを大規模に展開するためのデータプラットフォームを提供します。
AI向けにデータを変換する
私たちが最も強調したい最前線の分野は、統制されたAIの能力を厳しい規制要件に適合する環境に配備する能力です。ヘルスケア、金融、政府機関などの多くのお客様にとって、自組織のデータがデータセンター外に出ることは絶対ないことを承知しているからです。
Splunk Enterpriseのお客様は、Cisco AI POD for SplunkのCisco Secure AI Factory with NVIDIAの導入に伴い、Splunk AI Assistant、ホスト型モデル、Agent Launchpadを含むSplunk AIの機能をオンプレミス環境で活用できるようになりました。お客様は今後、各種の自己ホスト型モデルから選択できるようになります。そこには、数カ月後に提供予定のNVIDIA Nemotronオープンモデルも含まれます。
Splunkの新しいAIランタイムソフトウェアやリファレンスアーキテクチャでは、お客様が管理する環境でサポート対象のSplunk AI機能を自己管理型のソフトウェアレイヤーとして提供します。Cisco AI POD for Splunkを使い、そのソフトウェアと事前検証済みのCiscoインフラおよびNVIDIAアクセラレーテッドコンピューティングを組み合わせると、AIのパワーをデータセンターで直接活用できるシステムが、即座に使える形で提供されます。
各種のCisco AI PODは、エンタープライズAIに適したフルスタックのモジュール型インフラプラットフォームを提供する、Cisco Secure AI Factory with NVIDIAの基本的な構成要素です。
bitsIO、Wipro、World Wide Technologyなどのパートナー企業が、システムの稼動を目指すお客様を初日からすぐに支援いたします。
データの統合:データが存在する場所で分析する
マシンデータは爆発的に増大していますが、相変わらずクラウド、エンドポイント、ネットワーク内でサイロ化したまま活用されていません。これらペタバイト級のデータを単一のリポジトリに移動するのは、コストが桁違いで運用負担が大きくなるだけです。
私たちのアプローチは違います。
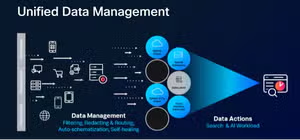
AIを活用したデータ管理は、データの取り込み前にまず信頼できるデータを準備することを支援します。Machine Data Lakeは、マシンデータを経済的に保持し、より高性能な分析に価値がある場合には、選択したデータを上位の階層へ昇格させます。統合サーチは、サポートされるサードパーティデータソースに対してSplunkによる分析を行います。分析を始める前にデータを移行する必要はありません。
現在Splunkは、統合サーチの機能を AWS CloudWatch Lake および Databricks にまで拡張しています。これによってお客様は、不必要なデータ移行時のトラブルを減らしつつ、複数ドメインにわたる質問の回答をより短時間で得られるようになります。
AIを活用したデータ管理、Machine Data Lake、統合サーチを組み合わせることで、お客様がデータの存在する場所に到達したり、そこでデータを分析したりする面で役立ちます。不要なデータ移行や複製も減らすことができます。
大規模な相関付け:複数ドメインにわたりデータをリアルタイムで結び付ける
データにアクセスし、分析し、相関付けるためには、まずそのデータを発見しなければなりません。そのためSplunkは、データディスカバリーをより容易にすることも重視しています。.confで紹介した MCP対応のCatalog Discovery により、専門知識を必要とせずにデータを発見できるようになります。
私たちは、MCP対応のCatalog Discoveryを使って、アナリストとAIエージェントの両方が適切なデータセットを発見し、そのビジネスコンテキストを自動的に理解できるように支援しています。これが、広範囲で費用のかかるサーチと標的を絞った高精度の調査との違いです。
データが発見可能になった後は、その周辺のシグナルに結び付ける必要があります。Cisco Data Fabric powered by the Splunk Platformは、お客様がそのようなコンテキストにアクセスするだけでなく、コンテキストを信頼できるエージェンティックアクションに変換できるようにします。シスコのお客様は、この同じ機能を Cisco Cloud Control から入手できるようになりました。別途Splunkのライセンスを用意する必要はありません。これは、この夏にCisco Live USに発表された単一画面での表示機能を直接拡張したもので、今回はSplunkのインサイトへ直接アクセスできる経路が組み込まれました。
シスコのお客様はSplunkを使うことで、アクセスとワークフローの合理化に加えて、今回強化された相互接続性からさらに多くの価値を実感されることでしょう。
私たちは、Cisco SD-WAN、ファイアウォール、Nexusから新しいネットワークインテリジェンスを取り入れ、それらを Cisco Cloud Control と直接統合して、お客様が、孤立し断片化したアラートに囲まれた状況から原因と影響を深く理解するレベルへと進めるようにしています。
Cisco Deep Time Series Modelは、お客様専用のGPUやデータサイエンスの作業を必要とせずに、マシンデータに特化したインテリジェンスを付加することで、運用環境全体における予測と異常検知を加速します。これは、マシンデータ本来の形を理解して推論する 今後の基盤モデル(Foundation Model) シリーズの第一弾にすぎません。
エージェンティック時代に求められるコストの適切な管理
AIの経済性についても、取り組む必要があります。これまでに伺ったフィードバックの声は大きく明確です。AI生産性ツールは莫大で不透明なコストを生み出し、それは多くの場合、実際の請求書が届くまで不明なのです。この構図は変えなければなりません。そしてそれは、私たちSplunk自身から始まります。
本日、アクティビティベース価格体系を発表します。これは、この夏に発表されたValue Insightsおよび統合された企業価値の現行価格体系を拡張するものです。
今秋リリース予定のアクティビティベース価格体系では、プラットフォームの経済面をよりお客様のアクティビティに近づけます。具体的には、サーチと取り込みの重み付けを同等にし、Splunkプラットフォームのパワーと機能性を維持しながらコストと複雑さを低減します。
この追加発表と今夏の発表内容は、お客様の事業が拡大していく際に、財務面の予測可能性とROIの明確な見通しを確保できるようにするものです。Value Insightsは、Splunkの利用状況を運用面の価値と最適化の機会に結び付けます。一方、統合された企業価値および それに伴う容量 は、AIを活用したデータ管理、Machine Data Lake、統合サーチ向けです。対象となるSplunk Cloudのお客様が、より障壁の少ない方法でデータ利用を拡大したり、より明確な経済性で価値を証明したりできるようにします。
今回の追加と今夏の一連の発表は、お客様が規模を拡大する際に、コストの予測可能性とROIへの明確な見通しを確保できるようにすることを目的としています。Value InsightsはSplunkの消費量を運用上の価値と最適化の機会に結びつけます。また、Integrated Enterprise Valueと、AI-powered Data Management、Machine Data Lake、Federated Searchに付帯する容量により、対象となる Splunk Cloud のお客様は、より明確な経済性のもとで、データ活用の拡大と価値の実証をこれまでより少ない負担で進められるようになります。
私たちは、単に技術的な資産ではなく、お客様の財務面のコストの適切な管理を共に担うパートナーであり続けるという姿勢を、さらに強めていきます。
今後の道筋
AIがもたらす変化のスピードは容赦がありません。しかしそれは、自社のシステムを信頼できる企業にとっては強力な追い風ともなります。ただし、今日それを主張できる企業は多くありません。Splunkは、分散したマシンデータを信頼できる運用コンテキストに変換することで、信頼できるAIを大規模に実現するデータプラットフォームを提供しています。こうしたコンテキストは、人間の担当者やエージェントが、何が起こったか、なぜそれが重要なのか、次に何をすべきかを理解するのに役立ちます。
AIエージェントが動く企業(The agentic enterprise)は、単なる未来の状況ではなく、現在進行形で発生していることです。その構築を安全に、レジリエンスを保ちながら、自信を持って行える基盤をお客様に提供できることは、私たちの誇りです。
Splunkの年次.confイベントで発表されるすべてのイノベーションについて詳しくは、最新の発表「シスコ、Splunkの機能強化により、信頼できるAIの大規模活用を実現」をご覧ください。また、以下のニュースブログやリソースでも、最新のイノベーションを掘り下げてご覧いただけます。
.conf26製品およびパートナーシップニュースブログ
- エージェンティック時代に求められる新しいデータ基盤:シスコがSplunkと共に提供する方法
- シスコがフルスタックのオブザーバビリティを通じて組織によるAIの大規模管理を支援
- 自律的な防御への進化:エージェンティックSOCの新しい機能
- データがある場所へAIの力を:シスコとNVIDIAによる新たなマイルストーン
- SplunkとAWS、エージェント型組織の構築に向けた提携を強化
その他のリソース:
関連記事

AWS Lambdaを使ってAmazon CloudWatch LogsからSplunkにログデータをストリーミング
カオスなデータを明快な情報へ:Splunk Data Management完全ガイド
