Splunk Observability at .conf26:AIを大規模に最適化
Observability Dave Hickman主なポイント
- インフラのレジリエンスを最大化する — Splunk Observabilityは、AI向けにテクノロジースタック全体をAIのために機能させるよう支援します。AIスタックのパフォーマンスを確認し、アプリとネットワークの問題を迅速に分離し、ビジネスへの影響に基づいて問題の優先順位を付けます。
- エージェントの挙動を監視し、トークノミクスを最適化する — Splunkなら、AIエージェントを安全に大規模展開できます。エージェントの品質を評価し、ハルシネーションやリスクのあるアクションを実行時に即座にブロックするとともに、請求書に反映される前に、すべてのトークンの利用状況とコストの帰属先を明確にできます。
- 自律的にトラブルシューティングする — Splunk Observabilityは、自動インストルメンテーション(アプリケーションに監視機能を自動で組み込む仕組み)、アラートをグループ化して根本原因を特定し修復を支援するAI、Splunk Observability Cloudの新しいエディション、低コストのオブザーバビリティログを提供します。これらにより、チームはインシデントをより迅速に検知、調査、解決できます。
以前のオブザーバビリティは、「何が壊れたか?」という問いにしか答えることができませんでした。今、オブザーバビリティは進化して、「AIエージェントの動作を信頼できるのか?」という新しい問いにも答えを出せるようになっています。あなたの顧客が気付く前に、ハルシネーションを検出できますか?AIトークンのコストを抑制できますか?これらはどれも、従来のオブザーバビリティが扱ってきた課題に取って代わるものではありません。こうした課題は、今も変わらず重要です。しかし今では状況が変わり、問題をより迅速に見つけて防ぐには、両方の問いに同時に答えなければなりません。アプリケーションからインフラ、ビジネスプロセス、そしてAIそのものまで一貫した可視性が求められるようになったのです。
Splunkは.conf26で、その変化に対応するために設計された、Splunk Observabilityの新しいイノベーションを発表します。これにより、インフラのレジリエンスを最大化し、エージェントの挙動を監視し、トークノミクスを最適化し、自律的にトラブルシューティングすることで、企業が AIを大規模に最適化 できるよう支援します。
これらのイノベーションは、全社規模の信頼できるエージェンティック運用においてインテリジェンス層を担うSplunkの役割をさらに強化するものです。これが意味するのは、「アプリケーションは稼働しているか?」という問いから「エージェントは適切に動作しているか?そのコストは適切か?」という問いへの移行です。これらの障壁を一掃できれば、エージェンティックAIの大規模な展開は「根拠のない賭け」ではなくなります。
Splunk Observabilityは、4つの互いに関連する分野にわたる以下のイノベーションによって、こうした課題を解決する支援をします。
まずは、他のすべてを支えるレイヤーから始めます。
インフラのレジリエンスを最大化する
テクノロジースタック全体をAIのために機能させる
- Observability CloudのBusiness Journeysを使用して、重要なビジネスプロセスの健全性をリアルタイムで追跡し、技術的なパフォーマンスをビジネス成果に結び付けます。
- Observability CloudのThousandEyes Network Insightsで、問題がアプリケーションのコードにあるのか、ネットワークパスにあるのかを瞬時に判定できます。
- Network Intelligenceアプリにより、ネットワークシグナルを複数ドメインにわたるインサイトに変換し、検出、トラブルシューティング、解決を迅速化します。
- Log Essentials for Observability Cloudで、コスト効率の高いログ分析を実現し、関連するコンテキストとともにログを用いてアプリケーションとインフラの問題をデバッグします。
エージェントの挙動を監視する
エージェントの挙動を評価して統制する
- Agent Observabilityでエージェントの挙動とコストを評価、監視、制御して、AIへの信頼を築きます。
トークノミクスを最適化する
トークンの消費量と使用状況を管理して、コストを抑制し、導入状況とROIを測定する
- Agent Observabilityで Tokenomics によってエージェントのコスト、導入状況、生産性をビジネス価値に結び付けます。
自律的にトラブルシューティングする
問題をより迅速に解決し、修正しやすいアプリケーションを構築する
- AI SREは、チームによる検知、アラート相関分析、トラブルシューティングの自動化を支援します。また、Anthropic社と連携し、Splunk Observability StudioおよびClaude Managed Agentsを通じて、コードレベルの修復を提供します。
- Observability Studioを使用して、AI生成コードに初日から自動でインストルメンテーションを行うことで、すべてのアプリケーションを死角やセキュリティ上の脆弱性、技術的負債のない状態で本番環境に移行できます。
- ITSI 5.0の再設計された操作体験と Event iQ のAIドリブンのアラートのグループ化と診断によって、オンボーディングと調査にかかる時間を短縮します。
- Observability Cloud Free Editionでオブザーバビリティの取り組みをすぐに始め、自社のペースで試してみましょう。
.conf26で発表されたSplunk Observabilityの最新情報を、以下でご紹介します。
インフラのレジリエンスを最大化する
Business Journeysによって、ゴールデンシグナルをビジネス成果に結び付ける
Observability CloudのBusiness Journeys — 2026年9月提供開始
企業がAIワークロードおよび複雑な分散アーキテクチャを大規模化するなか、ゴールデンシグナルの追跡だけではもはや十分ではありません。ITOpsチーム、エンジニアリングチーム、AIエージェントは、インシデントの分析精度を向上させ、解決までの時間を短縮するために、より詳しいビジネスコンテキストを必要とします。つまり、どのサービスが失敗しているかだけでなく、その障害がビジネスプロセスやサービスの健全性にどのように影響するかを理解する必要があります。従来のサービスダッシュボードでは、複数のシステムにわたるワークフローの問題を捉えられません。例えば、気付かないうちに顧客のオンボーディングが停滞する、ローン申請の審査が遅延する、リテール注文で配送SLAが満たされないなどの問題です。
Business Journeysは、フロントエンドのユーザーセッション(RUM)とバックエンドのマイクロサービス(APM)をビジネスIDで相関付けることで、このギャップを解消します。つまり、OpenTelemetryによる既存のインストルメンテーションから自動でビジネスIDを検出することで、人間の担当者とAI SREの双方にリアルタイムのコンテキストを提供します。これにより、ウォールーム(作戦司令室)での勘に頼った対応をなくし、測定可能なビジネスへの影響に基づいて対応の優先順位付けができるようになります。
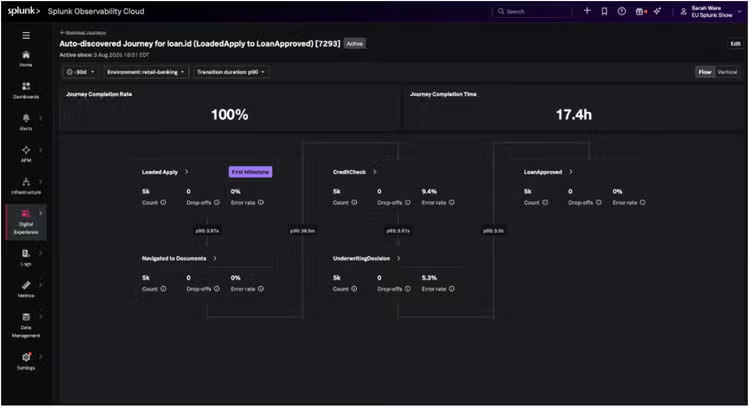
詳しくは、「何が重要なのかを推測で判断するのは止めましょう:ゴールデンシグナルを超えて、整備されたBusiness Journeysへ」をご覧ください。
アプリケーションかネットワークか?1つのテストで同時に判断する
Splunk Synthetic MonitoringによるNetwork visibility (ネットワーク可視化) — 2026年10月提供開始
障害対応のウォールームは、いつも同じような押し問答から始まります。アプリケーションチームは自分たちのサービスは正常だと主張し、ネットワークチームは自分たちの経路に問題はないと主張します。ユーザーが影響を受け続ける中、問題は解決されないまま、緊急会議はさらに40分も続きます。そのような膠着状態が続く元凶は、サイロ化したテレメトリです。その代償は、MTTRの悪化です。
Splunk Synthetic Monitoringを使えば、アプリケーションとネットワークの外形テストを1カ所で作成および管理し、世界中の1,000を超える監視ポイントからパフォーマンスを把握できます。同じテストの実行によってアプリケーションとネットワークの両方のシグナルが得られるため、障害がいずれにあるのかを、議論ではなく共通の証拠に基づいて特定できます。そこから、Observability Cloudの関連するアプリケーションテレメトリにドリルダウンするか、ThousandEyesネットワーク診断に直接移動すればよいのです。
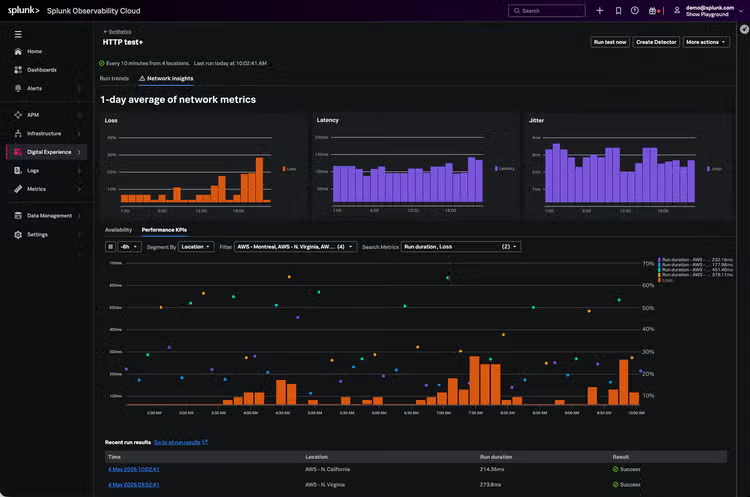
詳しくは、「Splunk Synthetic MonitoringにNetwork Intelligenceアプリと新たなネットワーク可視化機能が登場」をご覧ください。
データはすでにあります。今度はネットワークも把握できます。
Network Intelligenceアプリ — 2026年9月30日提供開始
多くの企業はすでにネットワークデータをSplunkに送信しています。それに基づき、Network Intelligenceアプリがネットワークの状況(シスコデバイスのトポロジー、健全性、イベント)をリアルタイムで描き出します。1つのイベントから、その影響を受けたデバイスや、関連するインターフェイス、リンク、サイトをすぐに確認できます。トポロジーはシスコのコントローラーからの情報なので、去年作成した図ではなく、まさに現在のネットワーク状況を表しています。新しく導入が必要なものはなく、Splunkのお客様には追加料金もかかりません。
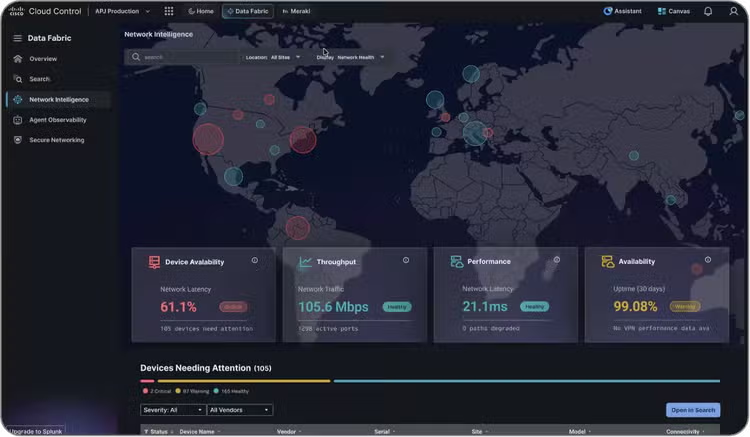
詳しくは「Splunk Synthetic MonitoringにNetwork Intelligenceアプリと新たなネットワーク可視化機能が登場」をご覧ください。
エージェントの挙動を監視する
エージェントは24時間365日動き続けますが、それでも、その仕事ぶりを確認する人は必要です。
Splunk Agent Observability (Galileo基盤) — 2026年9月よりオンプレミス、Cisco Cloud Control、Observability Cloudで提供開始
各チームではエージェントをリリースしていても、それを大規模に展開することには苦労しています。エージェントは従来のソフトウェアとは異なり、非決定論的な性質を持ち、予測が難しいからです。また、信頼を築き、エージェントが適切なコストで意図どおりに動作していることを保証するために必要なガバナンスとガードレールも欠けています。
これが私たちがGalileo社を買収した理由です。Galileoは、現在Splunk Agent Observabilityと呼ばれ、高精度の評価手法によってエージェント、出力、RAGの品質を評価します。フロンティアモデルをLLM-as-a-judgeとして利用する場合と比べて大幅に低いコストで、標準搭載の評価機能だけでなく、独自に定義したカスタム評価機能も利用できます。チームはトラフィックを、サンプリングの必要なく100%監視でき、複雑なマルチエージェントワークフロー内部にあるエラーの根本原因を可視化できます。加えて、微調整を加えたLuna小規模言語モデル(SLM)を利用すれば、低遅延かつ低コストで評価でき、ハルシネーションのような問題をブロックする実行時のガードレールを適用するのにも役立ちます。
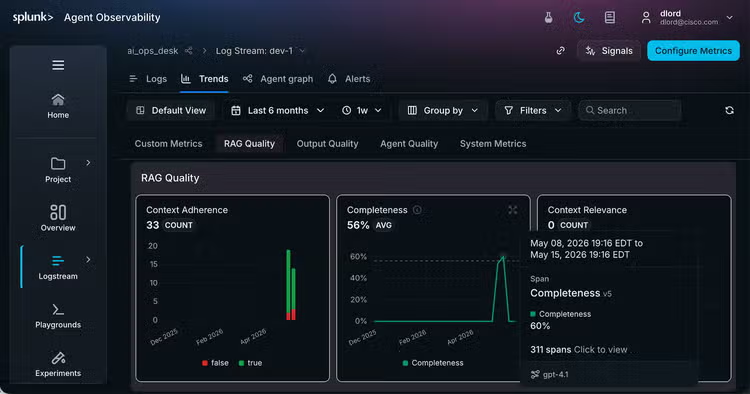
詳しくは「Agent Observabilityを使ってAIエージェントを監視、評価、ガードレールを適用する」について、こちらをご覧ください。
トークノミクスを最適化する
コストの可視性を高め、月末の予想外の請求を減らす
Tokenomics — 2026年9月よりSplunk Agent Observabilityで提供開始
毎月届く請求書に説明のつかない金額を見つけた時のあの嫌な感覚は、おそらくご存知でしょう。Claude CodeやCodexなどのAIコーディングエージェントを導入し続ける多くのエンジニアリング組織が、まさにこの点で悩んでいます。
Tokenomicsは、コーディングエージェントのコスト、導入状況、生産性を1つのビューで可視化します。財務やエンジニアリングのリーダーは、ユーザー、チーム、モデル、ツールプロバイダーごとにコストの急増を調査して原因を特定し、使用状況と支出を最適化できます。さらに、間もなく、こうしたインサイトをビジネス価値に結び付けられるようにもなります。Cisco Deep Time Series Model (CDTSM)を使えば、消費パターンを予測し、請求の対象期間が終わる前に今後の支出の動向を推定できるようになります。各チームは、予算を設定したり、異常に関するインサイトを得て説明責任を明確にしたり、ツールの効率化を促進したりできます。
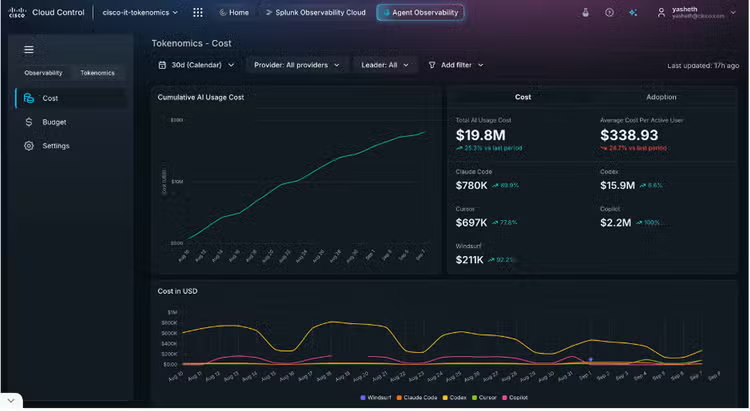
詳しくは「Tokenomicsによるコーディングエージェントの使用状況、支出、活用状況の把握」をご覧ください。
自律的にトラブルシューティングする
アラートを減らし、デバッグ時間を短縮し、より迅速に回答を得る
Observability CloudのAI SRE — 提供中
エンジニアリングチームはいまだに、増え続けるダッシュボード、大量のアラート、コンテキストの絶え間ない切り替えに膨大な時間を費やしています。しかも、これらによって、どのシグナルが同じ根本原因から発生しているのかが見分けにくくなっています。その結果、ダウンタイムが長引き、人々は疲れ果てます。
新しいエージェンティックチームメイトとして動作するAI SREは、複雑さと手間を減らすのに役立ちます。Intelligent alerting機能が、アラートを分類し、統一されたアクションにつながるインシデントに集約します。このAIトラブルシューティングエージェントは、MELTデータを分析して、複雑な問題が最初に発生した可能性のある場所を特定します。次いでチームは、ガイド付きの修復計画を実行するか、Anthropic社のClaude Managed Agents (CMA)を活用して、安全なサンドボックス内でコードレベルの修正を実行できます。エンジニアは完全な制御権を維持しつつ、信頼を構築できます。
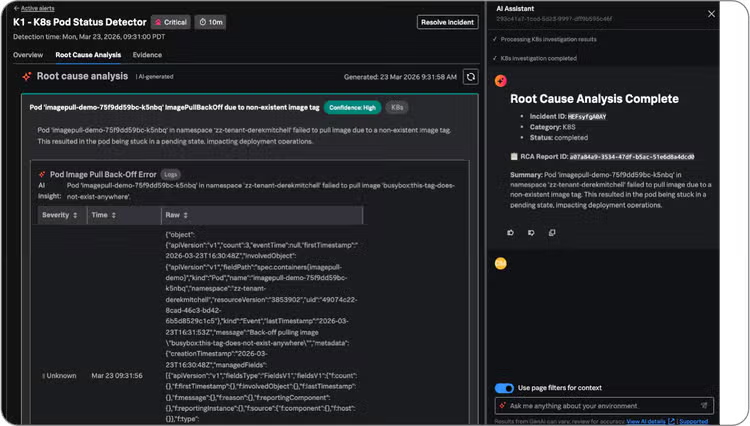
詳しくは、「根本原因からプルリクエストまで:Splunk Observability CloudのAI SREがClaude Managed Agentsを通じてインシデントの修復も実行」をご覧ください。
最初のコードのデプロイ前からオブザーバビリティを組み込む
Observability Studio — 提供中
AIが生成したコードはすぐに本番環境に導入されるため、それを運用する担当者が把握できない問題や可視性の不足が生じるおそれがあります。監視、デバッグ、運用する方法を確立する前にアプリケーションが構築され、その技術的負債が積み重なっていきます。
Observability Studioは、最初からOpenTelemetryを使ってアプリケーションをインストルメンテーションできる、開発者ファーストの操作環境です。Claude CodeやCodexなどのAIコーディングエージェントが構築したアプリケーションも対象で、それらのインターフェイス内から直接インストルメンテーションできます。ガイド付きワークフローのおかげで勘頼りの構成が減り、何時間もかかっていたインストルメンテーションが分単位で完了します。OpenTelemetryのエキスパートになる必要もありません。これは、「構築済みの仕組みを監視する」から「初めからオブザーバビリティを組み込んだソフトウェアを構築する」への移行と言えます。
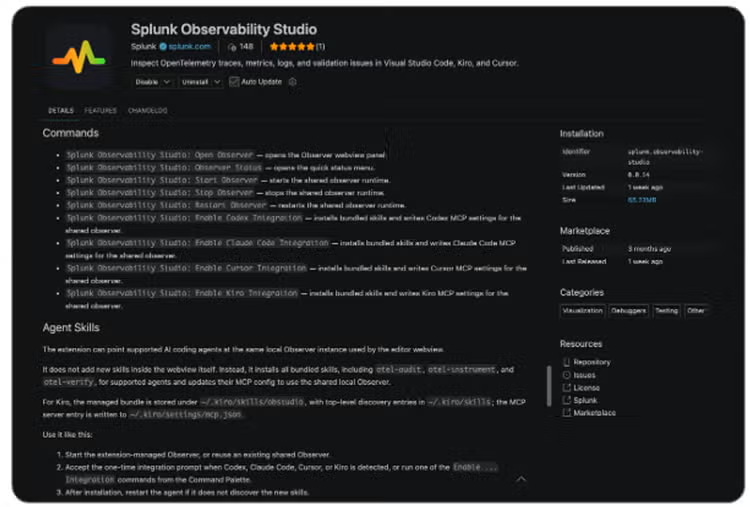
アラートノイズを、アナリストから学習するモデルで削減
ITSI 5.0 + Event iQ — 一般提供中
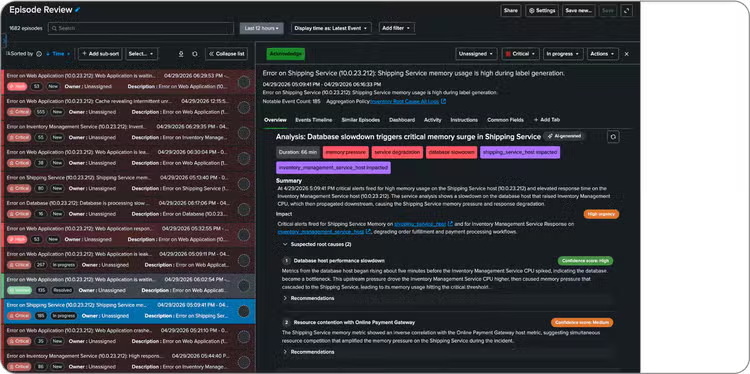
Splunk IT Service IntelligenceのEvent iQ Detectでは、相関付けに使う適切なフィールドを選択するためにすでに機械学習を利用していました。今回、さらにチームから学習できるようになりました。対応者が、無関係のアラートまで巻き込んでいたエピソードを分割したり、実は最初から1つのインシデントだった2つのエピソードを統合したりすると、モデルの再トレーニング時にそのフィードバックが反映されます。使うにつれてグループ化の精度が高まります。長時間にわたる手動の調整作業は不要です。
Event iQ Diagnoseが、その状況を自動で要約します。アクティブまたは解決済みのエピソードについて平易な言葉でサマリーを作成し、考えられる根本原因と推奨される次のステップを提示します。これは深夜に働くレベル1アナリストにとっても、率直な回答を求める経営幹部にとっても便利です。
トライアルの期間に縛られず、気軽に試す
Splunk Observability Cloud Free Edition — 2026年6月1日提供開始
エンタープライズグレードのオブザーバビリティを、最大15ホストまで無料で、しかも有効期限なしで利用できます。クレジットカードも、調達サイクルも、営業担当者とのやり取りも必要ありません。独自のテレメトリを用意することも、あらかじめデータが用意されたPlaygroundを試し、ダッシュボード、APMトレース、インフラ、アラート、AIを活用したインサイトをすぐに確認することもできます。Agent Observabilityも含まれているため、エージェント間のやり取り、モデルの呼び出し、ツールの使用状況、レイテンシー、エラーをトレースして、エージェントがなぜそのように動作したのかを実際に理解することができます。これは機能限定版ではなく、ここで構築したものはそのまま本番環境に移行できます。
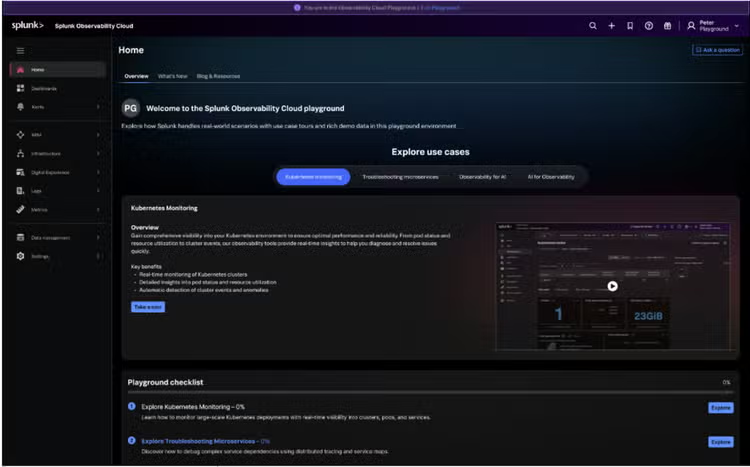
詳しくは、「無料でオブザーバビリティを試す:Splunk Observability Cloud Free Edition」をご覧ください。
スタックの変化に合わせて進化するオブザーバビリティ
Observability EssentialsおよびObservability Premier — 2026年11月提供開始
Observability CloudのシンプルなエディションであるEssentialsとPremierは、企業全体でのオブザーバビリティの導入・拡張を容易にします。コスト効率に優れたログ分析により、アプリケーションやインフラストラクチャの問題をデバッグできます。
オブザーバビリティを取り巻く環境は変化しており、Agent Observabilityは急速に重要な機能となっています。チームによる新しいアプリケーションの構築やコード開発が急速に進む中、オブザーバビリティをより簡単かつコスト効率よく導入できるようにすることが重要です。
Observability CloudのEssentials Editionは、Agent Observability、APM、Infrastructure Monitoringの導入を始めるチーム向けに設計された、コアとなるオブザーバビリティのユースケースに重点を置いています。
Premier Editionは、大規模にエージェントを構築するチーム向けであり、Digital Experience Monitoring、ランタイムアプリケーションセキュリティ、データベース監視などの追加機能を必要とする場合に適しています。これらはすべてSplunkプラットフォーム上に構築されています。また、ログはアプリケーションやインフラストラクチャのデバッグにおいて基盤となる重要な役割を果たすため、コスト効率に優れたオブザーバビリティログを、これらのエディションに直接組み込んでいます。
低コストの Observability Logs は一般提供を開始しています。EssentialsおよびPremier エディションは11月に提供開始予定です。
詳しくは、「オブザーバビリティの導入と大規模化をもっと簡単に:Splunk Observability Cloud EssentialsおよびPremierパッケージのご紹介」をご覧ください。
まとめ
オブザーバビリティは進化し続けます。Splunk Observabilityの最新のイノベーションによって、その未来がさらに近づきます。すなわち、Agent ObservabilityとTokenomicsによってエージェントの挙動を評価してトークンの消費量と使用状況を管理し、Network IntelligenceとThousandEyesネットワークインサイトを使ってアプリケーションとネットワークのどちらに問題があるのかを明らかにできるようになります。さらに、Business Journeysで技術的なシグナルをビジネスへの影響に結び付けるとともに、AIによってインストルメンテーション、検出、調査、要約、推奨を支援し、ビジネスへの影響を未然に防ぎ、顕在化させ、解消します。それは、ノイズの減少、回答の迅速化、より優れたデジタルエクスペリエンスが実現する未来です。
Observability Cloudを無料で利用するか、デモをご予約ください。業務を迅速化し、トラブルシューティングをスマート化し、信頼できるエージェンティック運用への移行を加速するためにSplunkがどのように役立つかをご確認いただけます。
ここで説明した製品および機能の多くは、現在、さまざまな開発段階にあり、利用可能になった時点で提供されます。これらの製品および機能の提供スケジュールは、シスコの独自の裁量で変更される場合があります。シスコは、この文書に記載されている製品または機能の提供の遅延および中止について一切の責任を負いません。
関連記事
OpenTelemetry、自動インストルメンテーション、Splunk Observability Cloudの活用促進
AIが変えるオブザーバビリティ体験