Agent Observabilityを使ってAIエージェントを監視、評価、ガードレールを適用する
Observability Dayna Lord今年すでにシスコが買収を完了しているGalileoという会社は、エージェント開発ライフサイクル全体にわたる、マルチエージェントシステムの評価、オブザーバビリティ、リアルタイムガードレール機能に特化しています。Galileoの技術は、企業がAIエージェントを本番環境に導入する際に直面する最大の課題の1つ、つまりAIへの信頼に対するギャップの解消を支援するために開発されました。
Splunkは今や、Agent Observabilityによってさらに次のステップに進んでいます。エージェントの挙動を評価し、パフォーマンスを監視し、コストを最適化し、有害なアクションをブロックする機能が、オンプレミスに加えて、現在はSplunk Observability Cloud、Cisco Cloud Controlからも利用できるようになりました。この統合されたアプローチと可視性により、エージェント、モデル、基盤インフラに対する信頼、コントロール、確信を高めることができ、それらが適切なコストで意図通りに稼動していることを保証できます。
AIへの信頼のギャップを解消する
エージェントに伴い、従来型のオブザーバビリティでは解決を想定していなかった課題が生じました。エージェントは、エンタープライズデータに基づいて推論し、計画し、ツールを呼び出し、やり取りを行って、私たちの代わりにマルチステップのアクションを実行します。エージェントは非決定論的な特質を持つため、同じ入力から同じ出力が得られるとは限りません。同じ推論経路を辿らないことさえあります。
エージェントは、ハルシネーションを起こしたり、意図から逸れていったり、正しいコンテキストなしでアクションを起こしたりする可能性があります。1回のやり取りで何千ものトークンが消費されることもあります。有害な出力は、顧客の信頼やビジネス成果が損なわれるおそれもあります。
このような自律性、予測不可能性、コスト、リスクが積み重なって、AIへの信頼に関するギャップが発生しました。このギャップが原因で、エージェントを本番環境に導入する企業では、次のようなまったく新しい問いが生まれています。エージェントの回答は正しかったのか?エージェントは正しい答えを出したのか?エージェントはなぜそのアクションを実行したのか?ハルシネーションが発生しているのでは?エージェントが機密情報を漏えいしていないか?そのやりとりで、どれくらいのコストがかかったのか?結局、エージェントは信頼できるのか?
従来型のオブザーバビリティだけでは、こうした質問に答えられるようには設計されていません。Agent Observabilityは、この新しい現実に対処できるように設計されたものです。
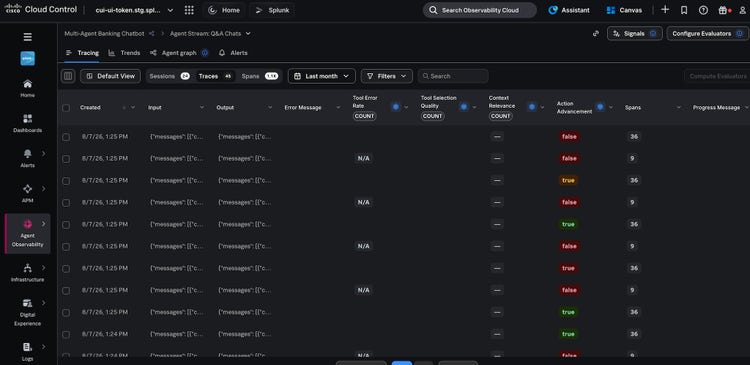
フロンティアモデルのコストや遅延はなしで、エージェントの品質と可用性を評価する
モデル、プロンプト、ツール、データ、ユーザーの行動の変化に伴い、エージェントの挙動も変化します。そのため、エージェントの品質を判定するには、微調整や測定などを含めた堅牢な評価手法が必要です。LLM-as-a-judgeアプローチは、エージェントの品質をスケーラブルに測定する手段となります。ただし、本番環境の大量のトラフィック全体に大規模なフロンティアモデルを適用すると、コストと遅延が生じる可能性があります。その結果、多くの場合、問題を検出するのに十分な数のやり取りを評価することと、評価コストを手頃な範囲に抑えることとの間でトレードオフが生じます。
Agent Observabilityを使えば、このトレードオフに縛られて「品質」の基準を決める必要はなくなります。近いうちに、Luna小規模言語モデル(SLM)を使い、高精度かつ低遅延で費用対効果の高い評価タスクを大規模かつ継続的に実行できるようになります。その結果、フロンティアモデルの判定だけに依存する場合の高いコストと遅延なしで、トラフィックを100%評価できるようになります。加えて、業務分野の専門家がフィードバックを提供することで、評価の品質を継続的に高めることができます。人間の専門的な知識が自動評価手法を改善し、自動評価手法がその専門知識や未知の問題の発見を大規模に適用するというループが構築されるのです。
さらに、RAG、エージェントのパフォーマンス、応答およびマルチモーダルの品質、その他の品質基準に対して、すぐに使える強力な評価機能も利用できます。LLM-as-a-judgeの評価手法をカスタムで作成して、応答の品質を判定することもできます。
プロンプトから本番環境までエージェントを監視する
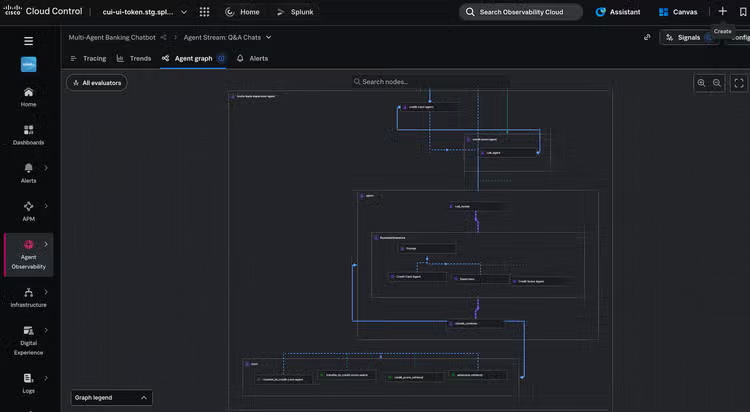
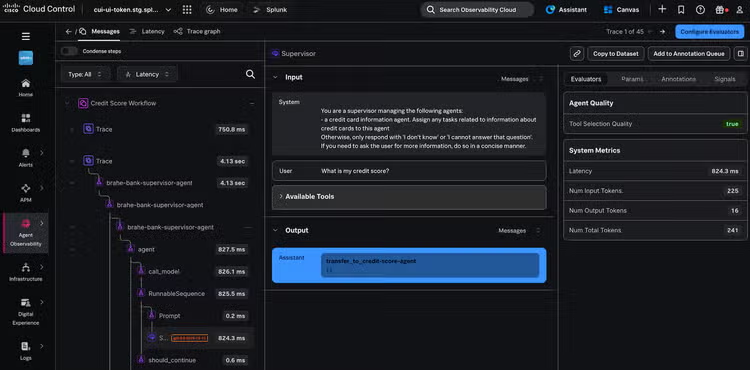
エージェントに不具合が生じた場合、根本原因の特定が簡単にできるとは限りません。1つのリクエストから、オーケストレーションロジック、モデル呼び出し、ベクトルデータベースからの取得、ツール呼び出し、複数エージェント間のやり取りがトリガーされる場合があるからです。このチェーン内のどこで障害が発生しても、最終結果に影響を与える可能性があります。
Agent Observabilityは、エージェントの動作を可視化する機能を備えています。これによってチームは、エージェント、ツールの呼び出し、エージェント間のハンドオフ(処理の引き継ぎ)を、品質、コスト、パフォーマンスのメトリクスと併せて確認できます。
分散トレーシングおよびOpenTelemetryがビルトインでサポートされるAgent Observability SDKやAPIを使用して、一般的なLLMプロバイダーとエージェントフレームワークを対象にアプリケーションのインストルメンテーションを行うこともできます。このような柔軟性によって各チームは、ますます複雑化するエージェントアーキテクチャ全体にわたり、問題を具体的に特定し、依存関係を把握し、障害と個々のやり取りを調査するのに必要な詳しいトレースを取得できます。
その結果、AIアプリケーションをより包括的に把握でき、エージェント、モデル、サポートサービスをそれぞれ単独ではなく、つなげて表示できるようになります。
AIの背後にあるTokenomicsを理解する
AIは高価なものですが、その理由は、エージェントの評価、新しいインフラコンポーネント、複雑なマルチエージェントワークフローだけではありません。コーディングエージェントの急速な導入も、理由となっています。残念ながら、消費量や支出を増やしても、有意義なビジネス価値につながるとは限りません。驚くような請求が来た場合の説明責任も、チームにとって難題です。
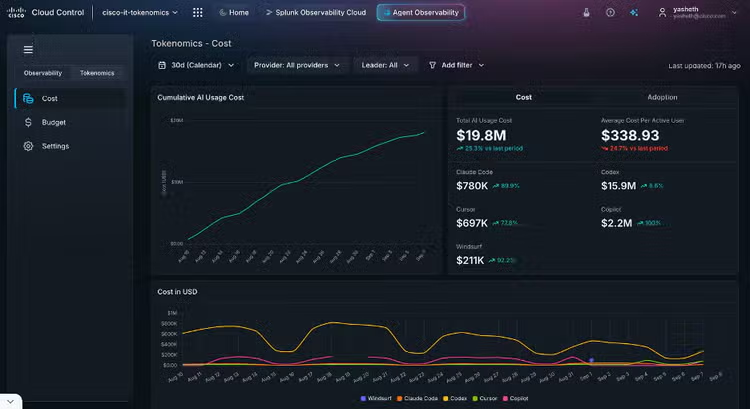
Tokenomicsによって、財務部門やエンジニアリング部門のリーダーは、コストの急増を引き起こしているユーザー、コーディングエージェント、モデルを1つのビューで把握できるようになります。トークンの消費がより良い成果を生み出しているかどうかも分かります。
今やチームは、単に「現在、支出はいくらなのか?」と問うのではなく、次のようなもっと有意義な問いが出せるようになりました。どのエージェントが消費量の増大をもたらしているのか?どこでリソースが浪費されているか?高価なモデルは、実際に品質も費用対効果も高い結果を生み出しているのか?
今月後半には、この機能がオンプレミス、Observability Cloud、Cisco Cloud Controlで提供されます。主要な統合対象には、Claude Code、Codex、Cursor、Windsurf、GitHub Copilotが含まれます。
詳しくは、TokenomicsのブログまたはWebページをご覧ください。
ガードレールを確実に適用するには、すべてのメンバーが責任を負う
エージェントが自律性を強め、さらに機密性の高いデータにアクセスし、やり取りするツールが増えるにつれて、攻撃対象領域は広がり、障害による潜在的な影響は増大します。プロンプトインジェクション、ツールの悪用、その他の有害なアクションなどの新たな脅威も登場しています。その結果、信頼と安全は単独のチームが責任を担えるものではなくなりました。
障害のトラブルシューティングを行うエンジニア、モデルとエージェントの改良を担当するAIチーム、優れたAIとは何かを明確にする特定分野の専門家、リスクの軽減を担当するセキュリティチーム、ROIとビジネス価値を定量化するビジネスリーダー。こうしたメンバーすべてが、安全で正確、かつコンプライアンスに準拠したエージェントの挙動とは何かを定義するうえでそれぞれの役割を果たします。
Agent Observabilityは、こうした共通の基準を実践に移すことを支援します。チームは評価(eval)をランタイムガードレールに変換し、有害または不正確なアクションがユーザーに影響を及ぼす前にブロックできます。一元化されたコントロールも、安全およびコンプライアンス関連のポリシーを一貫して全エージェントに適用するのに役立ちます。個々のアプリケーションにロジックをハードコーディングする必要はありません。
1つのアプローチでオンプレミス、Splunk Observability Cloud、Cisco Cloud Controlに対応する
企業はAIを、1つの場所で構築しているのではありません。関係するエージェント、モデル、データ、アプリケーション、インフラは、クラウド、オンプレミスなどますます分散化する環境に広がっています。そのためAgent Observabilityは、AIワークロードがどこにあっても対応できるように設計されています。
Agent Observabilityが、一度ログインすればシスコの全製品にアクセスできるエージェント型運用環境向けの統合プラットフォーム、Cisco Cloud Controlから利用できるようになっているのも、同じ理由です。これは垂直統合・協調設計されたフルスタックのエクスペリエンスであり、シリコンと光学製品、ネットワーキング、コンピューティング、データ、モデル、AIアプリケーションとエージェント、さらにあらゆるレイヤーにわたるセキュリティとオブザーバビリティまでを網羅します。この可視性は、チームが、AIインフラの健全性をエージェントとモデルの挙動、セキュリティ、信頼性、コスト効率と関連付けて理解する助けになります。
Agent Observabilityを使い始める
AIへの信頼のギャップを乗り越え、AIエージェントが強力なだけでなく信頼できて安全なものとなる未来へと進むうえでAgent Observabilityがどのように役立つかについて、詳しくは、SplunkのWebサイトをご覧になるか、関連するドキュメントをお読みください。Splunk Observability Cloud Free Editionですぐにお試しになることもできます。
関連記事

オブザーバビリティ:その真の意味

Splunkの新機能でコストを抑えながらクラウド監視を拡張