Splunk Synthetic MonitoringにNetwork Intelligenceアプリと新たなネットワーク可視化機能が登場
Observability Courtney Dragoonどのダッシュボードも「グリーン」なのに、なぜアプリケーションは遅いのでしょうか?
シドニーのユーザーから、決済処理が遅いとの報告がありました。APMもインフラも正常で、アプリケーションも応答しています。どのダッシュボードも「グリーン」を示しており、どれも状態を正しく表示しています。
問題は、これらのダッシュボードがそもそも監視対象としていなかった領域にあります。
トランザクションを構成するシステムのうち、自社で管理するものは年々少なくなっています。認証にはOkta、決済にはStripeといった具合です。呼び出しが送信され、結果が返ってくるのは確認できますが、その間で何が起きているのかはわかりません。さらに、そのすべてを支える基盤には、これまでまったく計測できなかったレイヤーがあります。名前解決は自社で運用していないリゾルバーで実行され、その呼び出しはすべて、自社では管理できないISPのネットワーク経路を通過します。障害がこうした外部領域で発生すると、これまでの計測方法ではその原因を把握できません。それは設定に問題があるからではなく、原因を特定できる範囲が、自社でコントロールできる領域の境界で途切れてしまうからです。
一方、自社で管理しているネットワークは、通常、まったく別の場所で管理されています。ネットワークチームは独自のツールを使い、デバイス、インターフェイス、リンクを中心に業務を行っています。アプリケーションチームは、別のツールでサービスやトレースを扱っています。2つのチームがそれぞれ異なる視点で状況を把握しているため、対応に着手する前に両者の情報を突き合わせる必要があります。どちらのチームも、それぞれのデータは持っています。しかし、どちらのチームにも、もう一方の視点が欠けています。自社で運用するデバイスと、自社では管理できない通信経路の情報を、普段使用しているトラブルシューティング環境で確認できていないのです。
自社で管理するネットワークも、管理外のネットワークも可視化
今回Splunkでは、このギャップの両面に対応する2つの機能により、ネットワークオブザーバビリティをさらに拡張します。
- Splunk Synthetic Monitoringのネットワーク可視化機能 - アプリケーションの外形監視にネットワークとインターネットに関するエビデンスを追加し、自社で所有および管理していない配信経路や依存関係まで調査範囲を拡大します。
- Network Intelligenceアプリ - 自社で運用するエンタープライズネットワークのデバイス、インターフェイス、トポロジー、イベント、およびそれらの関係性をSplunkに取り込みます。
1つのテストで、アプリケーションとネットワークのエビデンスを把握
外形監視はこれまでも、「アプリケーションの利用体験は正常だったか」という重要な点を的確に捉えてきました。Splunk Observability CloudのSynthetic Monitoringでは、その利用体験に問題があった場合、その原因を説明するネットワークのエビデンスも確認できるようになりました。
これまでと同じ方法でHTTPテストを作成できます。テストは、1,000を超える観測地点からなるグローバルなエージェントネットワークで実行されます。同じ都市内でも複数のISPを利用するため、問題が特定のプロバイダーだけで発生しているのか、すべてのプロバイダーに影響しているのかを判断できます。また、自社環境内にエージェントを追加すれば、ファイアウォールの内側からも監視できます。これにより、アプリケーションのテスト結果とネットワークの測定結果の両方を、同じテスト実行から取得できるようになりました。
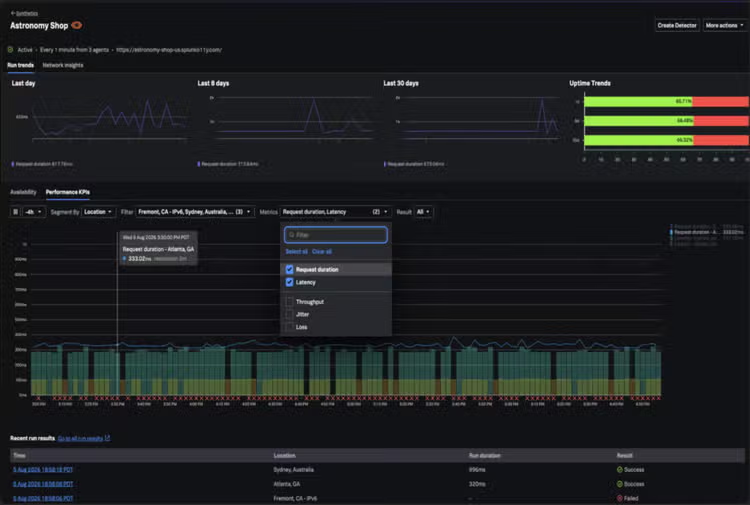
同じテスト実行について、応答時間に加え、レイテンシー、パケットロス、ジッターも確認できます。OpenTelemetryパイプラインを構築して別のネットワークストリームを取り込み、後からデータを突き合わせる必要はありません。同じテストで得られたアプリケーションとネットワークのエビデンスを、最初からまとめて確認できます。
レイテンシーやパケットロスの増加とともに応答時間も長くなっている場合は、どこを調べるべきかがわかります。一方、ネットワークが正常な状態のままトランザクションが遅くなっている場合、アプリケーションチームはネットワークを調査対象から外し、次の原因候補の調査に進むことができます。
そして、ネットワークに問題があることをエビデンスが示している場合でも、自社環境の境界で調査を止める必要はありません。外形監視の結果から、そのテストが実行されたまさにその時間帯のネットワーク経路を直接可視化し、ホップごとに、どのISP、どのリゾルバー、どのクラウド経路を通ったのかを確認できます。これにより、アプリケーションの計測だけでは把握できない依存関係、つまりインターネット経路、ISPインフラ、DNS、そしてサービスとユーザーをつなぐクラウドネットワークまで調査範囲を広げることができます。自社では管理できないものの、サービスが依存しているインフラについてのエビデンスを得られます。
ネットワークチームもThousandEyesで同じテストを開き、同じ結果を確認できます。これにより、両チームはそれぞれ異なる見方でインシデントに対応するのではなく、共通のエビデンスに基づいて連携できます。また、これまで他のディテクターで使用してきたのと同じワークフローから、稼働時間、実行時間、DNS名前解決など、サポート対象のネットワークテストシグナルに対するディテクターを作成することもできます。
ネットワークメトリクスは、追加料金が発生しないSplunkのメトリクスカテゴリに取り込まれるため、すでに保有しているデータに対して二重に課金されることはありません。
10月21日より提供を開始します。まずはHTTPテストに対応し、今後、対応するテストタイプを順次追加する予定です。
自社で運用するネットワークを把握
もう一方の課題は、エンタープライズネットワークそのものの内部にあります。アプリケーションチームがサービスの依存関係を見る一方で、ネットワークチームはデバイス、インターフェイス、リンク、サイト、トポロジーを見ています。新しいNetwork Intelligenceアプリは、ネットワークチームに自社環境をアプリケーション中心のモデルへ変換するよう求めるのではなく、ネットワークの運用モデルをそのままSplunkに取り込みます。
図ではなく、コントローラーからトポロジーを取得。このアプリは、すでに利用しているCiscoコントローラー(Meraki、Catalyst Center、SD-WAN Manager)からトポロジーを直接取得します。そのため、数カ月前のまま更新されていない図ではなく、現在の環境における物理的および論理的な関係をそのまま可視化できます。さらに、ネットワークを単一の階層構造としてではなく、実際のネットワークの動作に即して、関係性をグラフ構造でモデル化します。
イベントからデバイス、トポロジーまでを1つのワークフローで把握。イベントが発生すると、影響を受けているデバイスに移動し、その周辺のインターフェイス、リンク、サイトをすぐに確認できます。ポーリングツール、コントローラーのコンソール、マップを行き来して、状況を手作業でつなぎ合わせる必要はありません。
ゼロから設定する手間は不要。このアプリはデフォルトでデバイスを検出、分類、監視し、サポート対象のCiscoプラットフォームファミリー向けにすぐに使えるプロファイルを提供します。そのため、通常はデバイスの監視を開始する前に必要となる設定作業を省くことができます。
新たな購入も、新たな導入も不要。Network IntelligenceアプリはSplunkのお客様に無料で提供され、多くのお客様がすでにSplunkに送信しているCiscoネットワークデータを活用します。新たな収集基盤や、利用開始までに数カ月を要する導入作業は必要ありません。
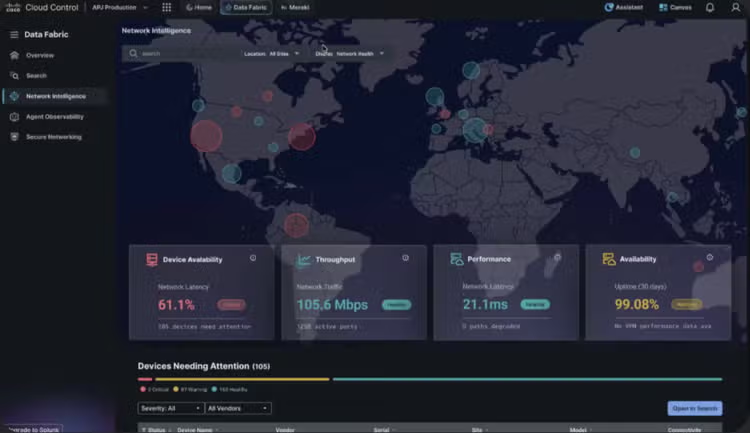
Cisco Cloud ControlのNetwork Intelligenceアプリ
トポロジーとイベントのコンテキストはSplunk内にあるため、別のツールを確認する必要はありません。ネットワークデータは、別のツールに分断されることなく、より広範な相関分析やフルスタックのトラブルシューティングに統合されます。これこそが、今回発表した2つの機能に共通する、より大きな変化です。オブザーバビリティはこれまで、チームが直接計測できるシステム内で最も大きな力を発揮してきました。しかし、デジタルエクスペリエンスはその範囲だけで完結するものではありません。エンタープライズネットワーク、クラウドプロバイダー、DNS、ISP、インターネット経路にも依存しており、これらもパフォーマンスを左右する重要な要素です。
これにより、症状からエビデンスまでを一貫した流れでたどれるようになります。ユーザー体験や外形監視の結果を起点に、アプリケーションとネットワークのどちらの状態が問題に影響しているのかを判断します。問題が自社環境の外部にある場合はネットワーク経路をたどり、障害の発生領域が自社環境内にある場合はエンタープライズネットワークを調査できます。デジタルエクスペリエンスに問題が発生したとき、何かがおかしいとわかるだけでは十分ではありません。どこを調べるべきか、どのエビデンスから原因を把握できるのか、そして誰が対応できるのかまで把握する必要があります。
9月30日より提供を開始します。まずはCiscoデバイスのトポロジーに対応し、今後、サードパーティ製デバイスにも順次対応する予定です。
利用を開始する
- Splunk Synthetic Monitoringのネットワーク可視化機能 — Splunk Observability CloudとThousandEyesをご利用のお客様を対象に、10月21日より提供を開始します。セットアップは、2つの製品間でOAuth連携を一度設定するだけです。両製品で既存のRBAC (ロールベースのアクセス制御)の設定がそのまま適用されます。
- Network Intelligenceアプリ — 9月30日より提供開始。
*シスコ社内における導入事例です。これらの機能を単体で取り上げたものではなく、シスコITのより広範なオブザーバビリティ戦略を紹介したものです。
シスコITは、この方法で自社のIT運用を行うことで、平均検出時間と平均解決時間を前年比45%短縮しました。
*シスコITは、この方法で自社のIT運用を行うことで、平均検出時間と平均解決時間を前年比45%短縮しました。また、シスコが委託したForresterのTotal Economic Impact™調査では、モデル組織がThousandEyesを活用することで、業務に支障を及ぼすインシデントを60%迅速に特定できたことが示されています。
関連記事

ディテクターをカスタマイズしてアラートの実用性をさらに高める方法

クラウドネイティブ/ハイブリッドアプリケーションとビジネストランザクションをObservability Cloud APMで監視