Splunk Observability auf der .conf26: Optimierte KI, in jeder Größenordnung.
Observability SplunkDas Wichtigste im Überblick
-
Maximale Infrastrukturresilienz
Splunk Observability hilft euch, euren gesamten Tech-Stack für KI einzusetzen: Ihr könnt dann die Leistung eures KI-Stacks über GPUs, Vektordatenbanken, Speicher und Orchestrierungs-Frameworks hinweg beobachten, sofort erkennen, ob ein Problem im Anwendungscode oder in den Netzwerkpfaden liegt, und die Probleme priorisieren, die umsatzkritische Prozesse wie Kreditgenehmigungen und Auftragsabwicklung tatsächlich gefährden. Vorgestellt werden Splunk Agent Observability für KI-Infrastruktur, Business Journeys, ThousandEyes Network Insights, die Network Intelligence App sowie Log Essentials für Observability Cloud. Ergebnis: Schnellere Triage innerhalb einer zentralen Ansicht, breitere Log-Abdeckung zu erschwinglichen Kosten und Einordnung von Problemen nach Auswirkungen für das Unternehmen statt nach Warnmeldungsvolumen.
-
Agentenverhalten überwachen und Tokenverbrauch optimieren
Splunk ermöglicht das sichere Skalieren von KI-Agenten: Ihr könnt Agent, Ausgabe und RAG-Qualität bewerten, Halluzinationen, Prompt Injections und Sicherheits-verstöße zur Laufzeit blockieren und jedes Token einem Benutzer, Team, Modell oder Tool zuordnen, bevor es auf der Rechnung landet. Vorgestellt werden Splunk Agent Observability und Tokenomics. Ergebnis: Vertrauen in die Handlungen eurer Agenten, erklärbare Ausgaben mit Budgets und Planung sowie ein darstellbarer Zusammenhang zwischen KI-Investitionen und messbarem ROI.
-
Autonomes Troubleshooting
Splunk Observability hilft Teams, Incidents schneller zu erkennen, zu untersuchen, zusammenzufassen und zu beheben, indem es verwandte Warnmeldungen gruppiert, die wahrscheinliche Kernursache ermittelt, die Behebung unter ständiger menschlicher Beteiligung steuert und Observability bereits in neue Anwendungen integriert, bevor diese überhaupt Produktionsstatus erreichen.
Früher ging es bei Observability lediglich um die Beantwortung der Frage „Was funktioniert nicht?“. Bedingt durch die Technologieentwicklung muss mittlerweile zudem die neue Frage beantwortet werden: „Kann ich dem Verhalten meiner KI-Agenten vertrauen?“. Erkennt ihr eine Halluzination, bevor der Kunde sie bemerkt? Und könnt ihr die Kosten für KI-Token kontrollieren? Diese Fragestellungen ersetzen keineswegs die klassischen Fragen und Antworten, die mit Observability abgedeckt werden. Diese sind genauso wichtig wie eh und je. Was sich geändert hat, ist, dass jetzt beide Fragen gleichzeitig beantwortet werden müssen, um Probleme schneller zu erkennen oder ganz zu verhindern – mit Transparenz, die von der Anwendung über die Infrastruktur und die Geschäftsprozesse bis hin zur eigentlichen KI reicht.
Auf der .conf26 stellen wir neue Innovationen bei Splunk Observability vor, die speziell für diesen Wandel entwickelt wurden: Sie helfen euch beim Optimieren von KI in jeder Größenordnung, indem sie die Infrastrukturresilienz maximieren, das Agentenverhalten überwachen, Tokenomics optimieren und autonom Troubleshooting durchführen.
Die vorgestellten Funktionen und Innovationen basieren auf Splunks Rolle als „Intelligence Layer“ – also als Informationsschicht – für einen vertrauenswürdigen agentenbasierten Betrieb im gesamten Unternehmen. In diesem Zug ist ein Wechsel von der Frage „Läuft meine Anwendung?” zu Fragen wie „Verhalten sich meine Agenten richtig? Und sind die Kosten vertretbar?“ notwendig. Wenn ihr diese Hürden aus dem Weg räumt, ist bei der Skalierung agentenbasierter KI keine Vertrauensvorschuss mehr nötig.
Splunk Observability trägt mit folgenden Innovationen in vier zusammenhängenden Bereichen dazu bei:
Den Anfang macht die Ebene, auf der alles andere aufbaut.
Infrastrukturresilienz maximieren
Einsatz des gesamten Tech-Stack für KI
- Verfolgt den Echtzeitzustand kritischer Geschäftsprozesse und setzt technische Leistung und Geschäftsergebnisse mithilfe von Business Journeys in Observability Cloud in Zusammenhang.
- Erkennt mithilfe von ThousandEyes Network Insights in Observability Cloud sofort, ob Probleme im App-Code oder in den Netzwerkpfaden vorliegen.
- Nutzt die Network Intelligence-App, um Netzwerksignale in domänenübergreifende Erkenntnisse umzuwandeln und so die Erkennung, Fehlerbehebung und Lösung von Problemen zu beschleunigen. network signals into cross-domain insight with the Network Intelligence app, accelerating detection, troubleshooting, and resolution.
- Erstellt mithilfe von Log Essentials für Observability Cloud kosteneffiziente Log-Analysen, um App- und Infrastrukturprobleme anhand von Logs im Kontext zu beheben.
Agentenverhalten überwachen
Bewerten und Lenken des Agentenverhaltens
- Schafft Vertrauen in KI, indem ihr Agentenverhalten und -kosten mit Agent Observability bewertet, beobachtet und kontrolliert.
Tokenverbrauch optimieren
Management von Token-Verbrauch und -Nutzung, um Kosten zu kontrollieren sowie Akzeptanz und ROI zu messen
- Verwendet Tokenomics in Agent Observability, um Agentenkosten, -akzeptanz und -produktivität mit unternehmerischem Nutzen zu verknüpfen.
Autonomes Troubleshooting
Probleme schneller beheben – und Apps erstellen, die sich leichter „reparieren“ lassen
- Automatisiert die Erkennung und Fehlerbehebung mithilfe von AI SRE mit Warnmeldungskorrelation für eine schnellere Problembehebung.
- Verwendet Observability Studio, um von Tag 1 an KI-generierten Code automatisch zu instrumentieren, damit jede App ohne blinde Flecken, Sicherheitslücken oder Technologieaufwand in die Produktion gelangt.
- Beschleunigt Onboarding und Vorfallsuntersuchung mit der neu gestalteten Erfahrung von ITSI 5.0 und der KI-gestützten Warnmeldungsgruppierung und -diagnose von Event iQ.
- Bringt eure Observability-Reise mit der Free Edition für Observability Cloud auf den Weg und erkundet die Lösung in eurem eigenen Tempo.
Auf der .conf26 werden folgende Neuerungen rund um Splunk Observability vorgestellt.
Infrastrukturresilienz maximieren
Mithilfe Business Journeys goldene Signale mit Geschäftsergebnissen verknüpfen
Business Journeys in Observability Cloud – verfügbar ab September 2026.
Da Unternehmen KI-Workloads und komplexe verteilte Architekturen skalieren, genügt das Nachverfolgen goldener Signale nicht mehr. Um Vorfälle schneller und präziser zu beheben, benötigen ITOps, Engineering-Teams und KI-Agenten tiefer greifenden Geschäftskontext: Sie müssen nicht nur verstehen, welcher Service ausfällt, sondern auch wie sich dieser Ausfall auf Geschäftsprozesse und den Servicezustand auswirkt. Ob das Kunden-Onboarding unbemerkt ins Stocken gerät, Kreditanträge bei der Risikoprüfung verzögert werden oder Bestellungen im Einzelhandel die Liefer-SLAs verfehlen – herkömmliche Service-Dashboards bilden diese systemübergreifenden Workflows nicht ab.
Business Journeys schließt diese Lücke, indem es Frontend-Benutzersitzungen (RUM) und Backend-Mikroservices (APM) mit Unternehmenskennungen verknüpft. Durch die automatische Erkennung in eurer bestehenden OpenTelemetry-Instrumentierung liefert Business Journeys Menschen und AI SREs den erforderlichen Echtzeitkontext, um Spekulationen im Krisenstab zu vermeiden und Maßnahmen zur Behebung von Störungen anhand messbarer geschäftlicher Auswirkungen zu priorisieren.
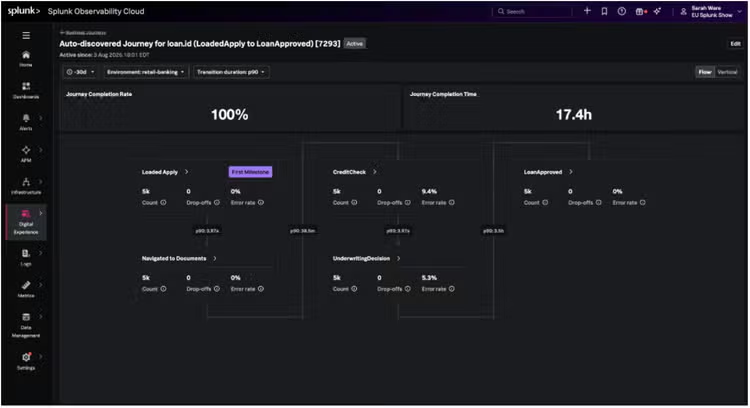
Weitere Informationen dazu findet ihr im Blog Stop Guessing What Matters: Move Beyond Golden Signals to Curated Business Journeys
App oder Netzwerk? Ein einziger Test liefert die Antwort
Netzwerktransparenz in Splunk Synthetic Monitoring – verfügbar ab Oktober 2026.
Jede Krisensitzung beginnt auf die gleiche Weise: Das App-Team gibt an, dass seine Dienste in bestem Zustand sind, das Netzwerkteam versichert, dass die Pfade sauber sind, und die Telefonkonferenz dauert weitere vierzig Minuten, während die Benutzer weiter unter dem Problem leiden. Der Grund für diese Pattsituation sind isolierte Telemetriedaten – auf Kosten der MTTR.
Jetzt könnt ihr synthetische Anwendungs- und Netzwerktests zentral erstellen und verwalten – mit Transparenz von über 1.000 Punkten weltweit. Anwendungs- und Netzwerksignale stammen aus demselben Testlauf, sodass anhand gemeinsamer Beweise statt durch Diskussionen geklärt werden kann, wo der Fehler liegt. An diesem Punkt könnt ihr Details zur zugehörigen Anwendungstelemetrie in Observability Cloud anzeigen oder direkt zur ThousandEyes-Netzwerkdiagnose wechseln.
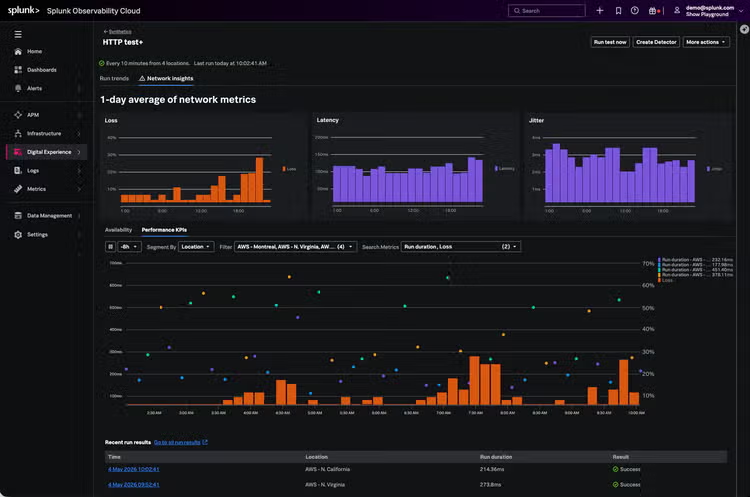
Weitere Informationen dazu findet ihr im Blog Announcing the Network Intelligence App and New Network Visibility in Splunk Synthetic Monitoring.
Ihr habt die Daten. Jetzt habt ihr das Netzwerk.
Network Intelligence-App – verfügbar ab 30. September 2026.
Die meisten Unternehmen senden bereits Netzwerkdaten an Splunk. Network Intelligence macht daraus ein Live-Bild des Netzwerks: Topologie, Zustand und Ereignisse der Cisco-Geräte. Über ein Ereignis gelangt man direkt zum betroffenen Gerät sowie den dazugehörigen Schnittstellen, Links und Sites. Die Topologiedaten stammen von euren Cisco-Controllern und spiegeln somit den aktuellen Zustand des Netzwerks wider – und nicht etwa ein Diagramm aus dem Vorjahr. Ohne dass etwas Neues bereitgestellt werden muss oder zusätzliche Kosten für Splunk-Kunden entstehen.
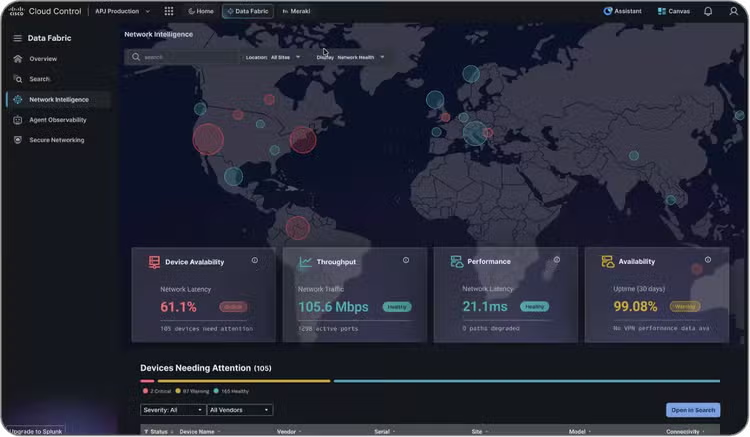
Mehr dazu erfahrt ihr hier: Announcing the Network Intelligence App and New Network Visibility in Splunk Synthetic Monitoring
Beobachten des Agentenverhaltens
Agenten laufen rund um die Uhr. Ihre Arbeit muss trotzdem jemand überprüfen.
Splunk Agent Observability – verfügbar ab September 2026 On-Premises sowie in Cisco Cloud Control und Observability Cloud, auf Basis von Galileo.
Teams stellen Agenten bereit. Sie haben jedoch Schwierigkeiten, sie in großem Maßstab einzuführen. Im Gegensatz zu herkömmlicher Software sind Agenten von Natur aus unberechenbar und nicht deterministisch. Außerdem fehlen ihnen die nötige Governance und Leitplanken, um Vertrauen aufzubauen und sicherzustellen, dass sie wie geplant und zu vertretbaren Kosten arbeiten.
Aus diesem Grund haben wir Galileo akquiriert. Galileo, das jetzt „Splunk Agent Observability“ heißt, bewertet Agent, Ausgabe und RAG-Qualität mithilfe hochpräziser Bewertungen. Dafür nutzt es vorkonfigurierte sowie benutzerdefinierte Evaluatoren zu einem Bruchteil der Kosten, die beim Konzept LLM-as-Judge mit Frontier-Modellen anfallen würden. Stattdessen können Teams 100 % des Datenverkehrs beobachten, was die Stichprobennahme hinfällig macht und ihnen Einblick in die Kernursachen von Fehlern innerhalb komplexer Multi-Agent-Workflows verschafft. Darüber hinaus sorgen optimierte kleine Sprachmodelle (Small Language Model, SLM) der Luna-Familie für geringe Latenz und Kosteneinsparungen bei der Bewertung und helfen, Leitplanken zur Laufzeit durchzusetzen, um Probleme wie Halluzinationen zu verhindern.
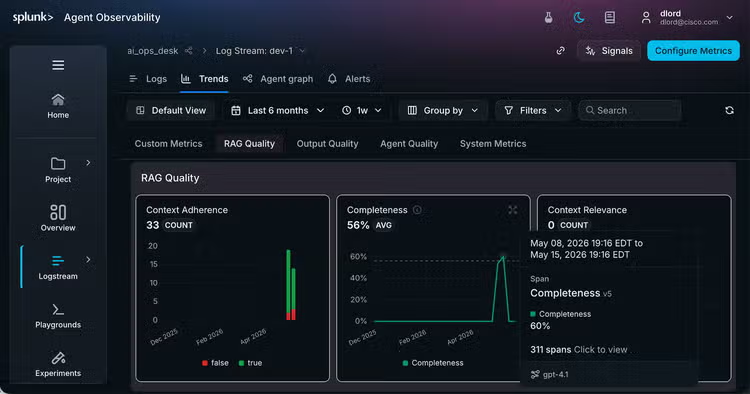
Weitere Informationen dazu enthält der Blog Observe, Evaluate, and Guardrail Your AI Agents With Agent Observability
Optimieren von Tokenomics
Mehr Kostentransparenz, weniger Überraschungsrechnungen am Monatsende
Tokenomics – verfügbar ab September 2026 in Splunk Agent Observability.
Kennt ihr dieses unangenehme Gefühl, wenn eine Monatsabrechnung eine Summe zeigt, die ihr euch nicht erklären könnt? So geht es vielen Engineering-Unternehmen, die weiterhin KI-Programmieragenten wie Claude Code und Codex nutzen.
Tokenomics macht Kosten, Nutzung und Produktivität von Programmieragenten in einer Ansicht transparent. Finanz- und Engineering-Verantwortliche können Kostensprünge nach Benutzern, Teams, Modellen oder Tool-Anbietern untersuchen und zuordnen, um die Nutzung und Ausgaben zu optimieren und diese Erkenntnisse bald mit dem geschäftlichen Nutzen zu verknüpfen. Mithilfe des Cisco Deep Time Series Model (CDTSM) können sie Verbrauchsmuster prognostizieren, um bereits vor Ende eines Abrechnungszeitraums abzuschätzen, in welche Richtung sich die Kosten entwickeln werden. Teams können Budgets festlegen, Einblicke in Anomalien gewinnen, um die Zuordnung der Verantwortung zu verbessern, und die Effizienz der Tools steigern.
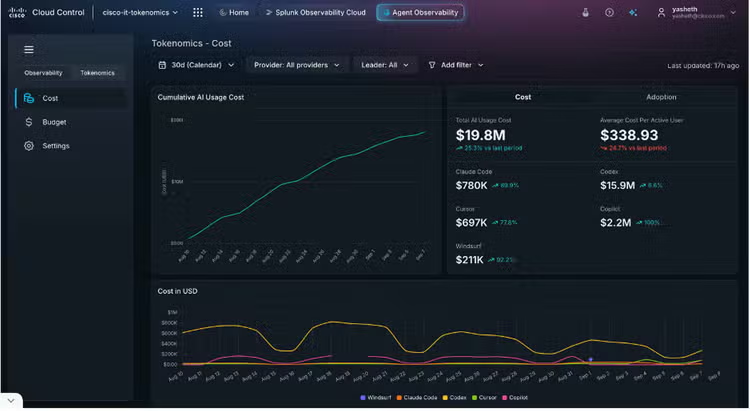
Weitere Informationen dazu findet ihr unter Tokenomics: Volle Transparenz über Nutzung, Ausgaben und Einführung von Coding-Agenten
Autonomes Troubleshooting
Weniger Warnmeldungen, kürzeres Debugging, schnellere Antworten
AI SRE in Observability Cloud – verfügbar ab jetzt.
Engineering-Teams verbringen immer noch zu viel Zeit damit, sich durch unzählige Dashboards und eine Flut von Warnmeldung zu kämpfen, und der ständige Kontextwechsel macht es schwierig zu erkennen, welche Signale eine gemeinsame Kernursache haben. Die Folge sind längere Ausfallzeiten und überlastete Mitarbeiter.
AI SRE fungiert als euer neuer agentenbasierter Teamkollege, der hilft, Komplexität und Arbeitsaufwand zu reduzieren. Die Funktion für intelligente Warnmeldungen gruppiert und konsolidiert Warnmeldungen zu einheitlichen, verwertbaren Vorfällen. Der KI-basierte Troubleshooting-Agent analysiert MELT-Daten, um genau zu ermitteln, wo ein komplexes Problem wahrscheinlich seinen Ursprung hat. Anschließend können Teams geführte Behebungspläne ausführen oder die Claude Managed Agents (CMA) von Anthropic nutzen, um Korrekturen auf Code-Ebene in sicheren Sandboxes durchzuführen, wobei das Engineering-Team die volle Kontrolle behält und Vertrauen aufbaut.
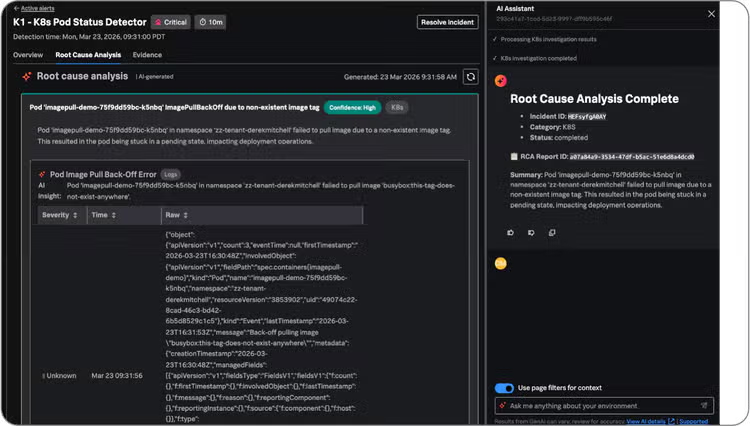
Weitere Informationen findet ihr unter From Root Cause To Pull Request: AI SRE in Splunk Observability Cloud Can Now Remediate Incidents With Claude Managed Agents
Observability, die vor der ersten Codebereitstellung beginnt
Observability Studio – verfügbar ab jetzt.
KI-generierter Code gelangt schnell in die Produktion. Dies bedeutet für die Verantwortlichen möglicherweise unbekannte Probleme und mangelnde Transparenz. Apps werden entwickelt, bevor überhaupt klar ist, wie Monitoring, Debugging oder Betrieb ablaufen sollen, und diese Last wächst immer weiter.
Observability Studio ist eine entwicklerorientierte Lösung, mit der Apps von Anfang an mit OpenTelemetry instrumentiert werden können. Dies schließt Apps ein, die mit KI-Programmieragenten wie Claude Code und Codex erstellt und direkt innerhalb dieser Schnittstellen instrumentiert wurden. Geführte Workflows, weniger Rätselraten beim Konfigurieren, Instrumentierung in Minutenschnelle statt in Stunden – ganz ohne zuerst OTel-Expertise aufbauen zu müssen. Die Entwicklung geht von „Überwache, was du bereits entwickelt hast“ hin zu „Entwickle Software, die von Anfang Observability bietet“.
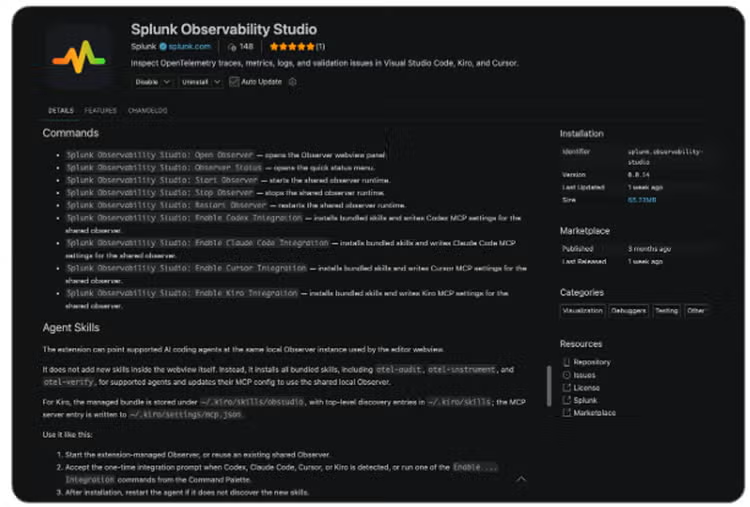
Weitere Informationen findet ihr unter Born Observable: Why AI-Generated Apps and Agents Need Visibility from Day One
Gegen die Warnmeldungsflut – ein Modell, das von euren Analysten lernt
ITSI 5.0 + Event iQ – allgemein verfügbar ab jetzt.
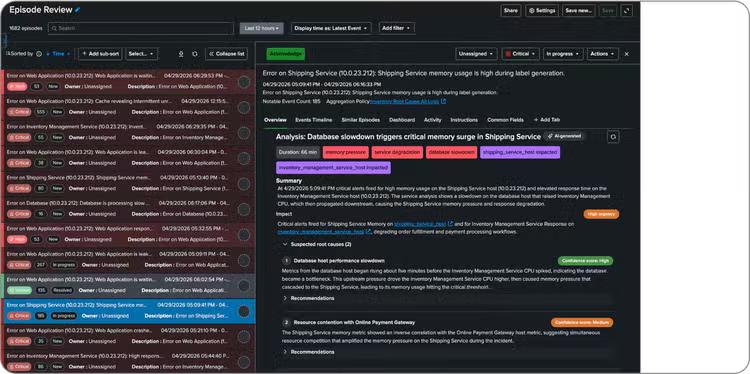
Event iQ Detect in Splunk IT Service Intelligence nutzte bereits Machine Learning, um die richtigen Felder für die Korrelation zu identifizieren. Jetzt lernt es von eurem Team. Wenn ein Responder eine Episode aufteilt, da darin nicht zusammenhängende Warnmeldungen gruppiert waren, oder zwei Episoden zusammenführt, die eigentlich einen Incident darstellten, dann wird dieses Feedback beim Neutrainieren in das Modell übernommen. Die Gruppierungsgenauigkeit verbessert sich mit der Nutzung – ganz ohne Optimierungsmarathon.
Event iQ Diagnose schreibt alles für euch auf: Es verfasst eine Zusammenfassung von einer aktiven oder gelösten Episode in natürlicher Sprache, einschließlich der wahrscheinlichen Kernursache und empfohlener nächster Schritte. Sehr praktisch für einen Level-1-Analysten um Mitternacht. Und auch praktisch für die Führungskraft, die eine klare Antwort möchte.
Weitere Informationen findet ihr unter Das ist Splunk IT Service Intelligence 5.0
Vergesst zeitlich begrenzte Testversionen – legt einfach los
Free Edition für Observability Cloud – verfügbar seit 1. Juni 2026.
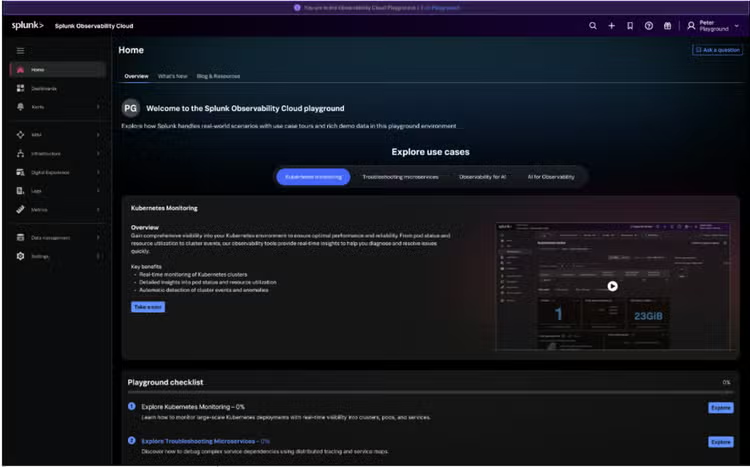
Kostenlose Observability auf Unternehmensniveau für bis zu 15 Hosts, ohne Ablaufdatum. Ohne Kreditkarte, ohne Beschaffungsprozess, ohne Verkaufsgespräch. Nutzt eure eigene Telemetrie oder stöbert im bereits mit Daten bestückten Playground: Dashboards, APM-Traces, Infrastruktur, Warnmeldungen und KI-gestützte Erkenntnisse warten auf euch. Da Agenten-Observability integriert ist, könnt ihr Agenteninteraktionen, Modellaufrufe, Tool-Nutzung, Latenz und Fehler nachverfolgen, um wirklich zu verstehen, warum sich ein Agent für die ausgeführten Schritte entschieden hat. Da der volle Funktionsumfang zur Verfügung steht, kann das, was ihr hier erstellt, direkt in die Produktion übernommen werden.
Weitere Informationen findet ihr unter Tiefgreifende Erkenntnisse ohne Hürden: Splunk Observability Cloud Free Edition
Observability, die sich an Änderungen in eurem Stack anpasst
Observability Essentials und Observability Premier – verfügbar ab November 2026.
Die Fragen, die Teams mit Observability beantworten möchten, haben sich verändert. Vor einem Jahr waren die Themen noch Services, Latenz und Fehlerbudgets. Heute kommen noch Agentenverhalten, Bewertungsqualität und Token-Verbrauch dazu – und oftmals stammen die Fragen vom gleichen Engineering-Mitarbeiter innerhalb derselben Woche. Der agentenbasierte Betrieb hat die alte Arbeit nicht ersetzt, sondern kommt noch zusätzlich oben drauf.
Observability Cloud sollte sich entsprechend weiterentwickeln. Deshalb vereinfachen wir das Kaufmodell und bieten nun zwei Editionen an, die genau auf den aktuellen Entwicklungsstand der Teams zugeschnitten sind.
Observability Essentials bildet den Kern: Infrastruktur-Monitoring und APM plus ein erstes Hineinschnuppern in Agenten-Observability für Teams, die gerade damit beginnen, agentenbasierte Apps zu entwickeln und vor einer Skalierung sehen möchten, wie sich ihre Agenten verhalten.
Observability Premier richtet sich an Teams, die Agenten bereits in großem Maßstab einsetzen und ernsthaft in agentenbasierte Anwendungen investieren. Diese Edition bietet umfangreichere Berechtigungen für Kernfunktionen, besonders für Logs, eine tiefgreifendere Agenten-Observability mit Zugang zur kostengünstigen Luna-Bewertung sowie erweiterte Funktionen wie Datenbank-Monitoring und Anwendungssicherheit.
Es gibt noch eine weitere erwähnenswerte Änderung: Logs sind jetzt ein grundlegender Bestandteil des Observability-Pakets und müssen nicht zusätzlich gekauft werden. Metriken, Traces und Logs sind in beiden Editionen im Lieferumfang enthalten.
Zwei Türen statt eines ganzen Flurs voller Abbiegemöglichkeiten. Die genauen Berechtigungsstufen und Preise werden bei der Markteinführung Anfang November bekannt gegeben.
Fazit
Observability entwickelt sich weiter. Die neuesten Innovationen von Splunk Observability bringen die Zukunft näher: Agenten-Observability und Tokenomics für die Bewertung des Agentenverhaltens und das Management von Token-Verbrauch und Token-Nutzung; Network Intelligence und ThousandEyes Network Insights klären die Frage „App oder Netzwerk“; Business Journeys für die Verknüpfung technischer Signale mit geschäftlichen Auswirkungen;, und KI, die bei Instrumentierung, Erkennung, Untersuchung, Zusammenfassung und Empfehlungen hilft, um geschäftliche Auswirkungen zu verhindern, aufzuzeigen und zu beheben. Weniger Rauschen. Schnellere Antworten. Bessere digitale Erlebnisse.
Holt euch Observability Cloud kostenlos – oder bucht eine Vorführung - um euch ein Bild davon zu machen, wie ihr mit Splunk schneller agieren, Fehler smarter beheben und eure Entwicklung zu einem vertrauenswürdigen agentenbasierten Betrieb beschleunigen könnt.
Dieser Text wurde aus dem Englischen übersetzt. Viele der hier beschriebenen Produkte und Funktionen befinden sich noch in unterschiedlichen Entwicklungsstadien und werden nur angeboten, sofern und sobald sie verfügbar sind. Der Zeitplan für die Bereitstellung dieser Produkte und Funktionen kann nach alleinigem Ermessen von Cisco geändert werden, und Cisco übernimmt keine Haftung für Verzögerungen bei der Bereitstellung oder die Nichtbereitstellung der in diesem Dokument genannten Produkte oder Funktionen.
Erfahren Sie mehr
Monitoring von LLM- und Agent-Performance – mit AI Agent Monitoring in Splunk Observability Cloud

Resilienz by Design: Was KI und Security für die Observability der Fertigung leisten