evalエンジニアリングのライフサイクルとその実装方法
Learn Pratik Bhavsar主なポイント
- 信頼こそが最大のボトルネック:多くのAIプロジェクトが失敗するのは、技術的な制約のためではなく、システムが大規模な環境でも確実に機能することをチームが証明できないためです。
- ライフサイクルはフライホイール型の継続的取り組み:evalエンジニアリングは一度設定して終わりではありません。データドリフトやモデルのアップデートに適応し、長期的な信頼性を確保するための5段階のシステムです。
- 測定からガバナンスへ:測定(出力が不良であると把握すること)からガバナンス(インラインのガードレールを通じて不良な出力をブロックすること)への移行こそが、デバッグツールと本番環境向けシステムを分けるものです。
多くのチームは、AIの構築に失敗しているわけではありません。失敗しているのは、構築したAIの信頼性を担保することです。プロトタイプはデモではうまく機能しても、本番環境でも問題なく稼働するかどうかは誰にも判断できないため、いつまでもパイロット段階にとどまってしまいます。断念されたAIプロジェクトに関する研究では、常に同じ課題に行き着きますが、それは人材やモデル、フレームワークの問題ではありません。課題は、こうしたチームが「何を作るか」ではなく、「何を証明できるか」という点にあります。
ここで登場するのがevalエンジニアリングです。
AIプロジェクトの導入で陥りやすい落とし穴
evalエンジニアリングのライフサイクルについて詳しく説明する前に、チームがAIの導入やスケーリングで失敗する原因となる、陥りやすい落とし穴を理解することが重要です。
- 最初からevalを増やしすぎる:15種類もの異なるメトリクスを抱えるあまり、明確な進むべき道を見失ってしまい、分析麻痺に陥ります。
- 汎用的なLLM評価手法だけに頼ってしまう:人間による調整がなければ、精度は70%で頭打ちとなり、その原因をドメイン固有の基準が欠如していることではなく、モデル自体の問題と見誤ることになります。
- 精巧な評価ダッシュボードを構築したものの、導入パイプラインに統合できていない:evalがガードレールの役目を果たさないとしたら、それは、単に高いコストをかけて「どのような問題があるか」を記録しているにすぎません。
- 評価を「一度限りのプロジェクト」として扱ってしまう:本番データにはドリフトが発生し、プロバイダーはモデルをアップデートします。評価システムも継続的に運用しなければ、数か月のうちにほとんど形骸化してしまいます。
- オーケストレーション、ツール呼び出し、検索レイヤーで発生するシステムの不具合を無視して、LLMの出力だけに焦点を当ててしまう
システムの劣化の理解:ドリフトとリグレッションの違い
信頼性を維持するには、評価システムの劣化を引き起こす2つの主な要因を区別する必要があります。
- データドリフト:ユーザーの行動や本番環境への入力データの変化に伴い、既存の評価基準が実態に合わなくなる可能性があります。「何が良い出力であるか」という定義が現実の状況と乖離しないよう、継続的なモニタリングと、SMEによる定期的な見直しが必要です。
- モデルのリグレッション:モデルプロバイダーが頻繁にアップデートを行うことで、意図せず出力の挙動が変化してしまうことがあります。そのため、エージェントの機能が低下していないことを確認するには、モデルがアップデートされるたびに、徹底したリグレッションテストスイートを実行する必要があります。
この2つの要因を理解することで、evalエンジニアリングが一度限りの設定ではなく、継続的なライフサイクルである理由がわかります。つまり、変化し続けるというデータ自体の性質と、モデルプロバイダーによる予測不可能なアップデートという、両方の要因に対する防御策を構築しているのです。
こうした要因に対処するには、開発プロセスのあらゆる段階で品質を管理する体系的なフレームワーク、すなわちevalエンジニアリングのライフサイクルが必要となります。
evalエンジニアリングの実装方法:5段階のライフサイクル
このライフサイクルの各段階は、前の段階を基盤としています。始める前に覚えておいていただきたいのは、評価の単位となるのは、プロンプト、ツール呼び出しのロジック、RAGによる情報取得、そして最終的な応答を含む、エージェントのワークフロー全体であるということです。モデル単体だけをテストすると、オーケストレーション層で発生するシステム上の不具合を見逃してしまいます。
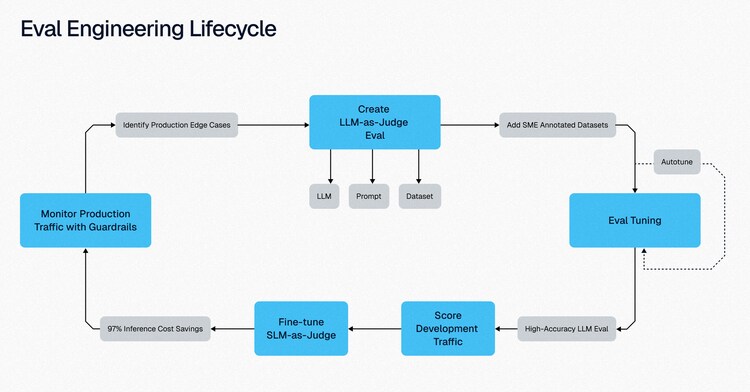
フェーズ1. LLM-as-judge:精度60~70%
まずはAIの出力を評価する評価者としてLLMを利用することから始めましょう。自身のユースケースにおいて何をもって「良い」とするかを定義したプロンプトを作成し、テストデータセットに対して実行したうえで、人間の判断との一致度を測定します。
この方法はすぐに設定できますが、通常は60~70%の精度しか得られません。最終目標ではなく、あくまで出発点です。このフェーズを成功させるには、まず上位3つの失敗パターンに焦点を当て、精度を95%まで高めてから、範囲を広げてください。こうした初期段階では、範囲の広さよりも、レベルが重要になります。
フェーズ2. SMEによる精緻化:精度90~95%
汎用的なLLM-as-judgeは簡便さの点では魅力的ですが、大きな影響を伴う本番環境で求められるドメイン固有のニュアンスを捉えきれません。そこで、そのドメインにおいて「良い」とはどのようなものかを実際に理解している専門家(SME)を招き、LLM-as-judgeが見逃している不具合を精査してもらいましょう。
1万件のチケット対応経験を持つベテランのカスタマーサービス担当者。規制上の問題を引き起こす表現を熟知しているコンプライアンス担当者。医学的に問題のあるアドバイスを見抜くことができる臨床の専門家。
こうした専門家は、前のフェーズではモデルが見落としていた基準を明確に言語化する手助けをしてくれます。この段階において精度は90~95%まで引き上げられます。ここに至る近道はありません。この70%と95%の間にこそ、専門知識の存在価値があります。
フェーズ3. SLMのファインチューニング:コストを100分の1に削減
高精度なベースラインを確立したら、次の課題は運用規模の拡大です。本番環境でのすべてのやり取りに対して大規模なLLMを実行するとなれば、コストがかかりすぎ、多くの場合、カバレッジをトラフィックの10%のみのサンプリングに限定せざるを得なくなります。
代わりに、SMEによって検証済みのラベルや失敗パターンに基づいて小規模言語モデル(SLM)をファインチューニングします。これにより、評価コストが100分の1に、実行速度が10倍になるため、100%のカバレッジも経済的に実現可能になります。もはやサンプリングに頼る必要はなく、すべてのデータを把握できるようになります。
代わりに、SMEによって検証済みのラベルや失敗パターンに基づいて小規模言語モデル(SLM)をファインチューニングします。これにより、評価コストが100分の1に、実行速度が10倍になるため、100%のカバレッジも経済的に実現可能になります。もはやサンプリングに頼る必要はなく、すべてのデータを把握できるようになります。
フェーズ4. 本番環境向けガードレール:100%インラインでの適用
この段階において、evalエンジニアリングと従来の評価が明確に分かれます。そもそも、問題のある挙動を許容してしまうのであれば、何のために測定したのでしょうか。
evalを、推論時にインラインで実行されるガードレールへと転換しましょう。スコアがしきい値を下回った場合、回答をブロックする、フォールバックをトリガーする、あるいは人間へのエスカレーションを行うといった処理が必要です。これにより、評価システムは単なる測定ツールからガバナンスシステムへと進化します。
精巧なパイプラインを構築したにもかかわらず、不適切な出力を通過させてしまうというミスをしないように気をつけてください。ガードレールの役目を果たさないevalは、「問題点をまとめるだけの高価な記録機能」にすぎません。測定は、自己満足ではなく、実際の行動につなげるために行うのです。
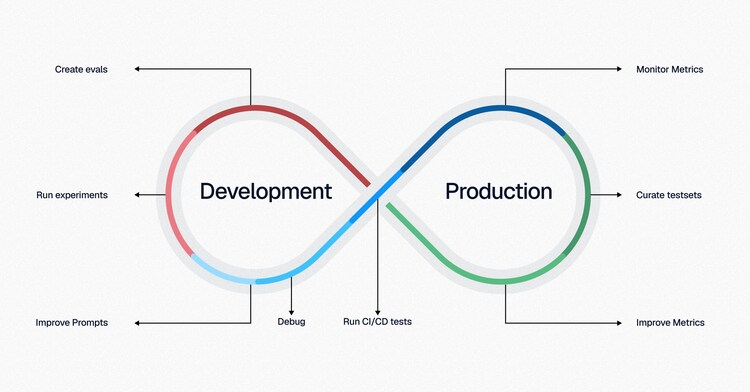
フェーズ5. 継続的な適応:自己改善を行う無限ループ(∞)
本番環境データは常に変化します。ユーザーの行動も進化し、モデルプロバイダーもアップデートを重ねます。evalもアップデートを怠れば、数週間で使い物にならなくなります。
ガードレールのトリガー発生率を監視し、本番環境での不具合情報を常設のSMEレビューサイクルへとフィードバックすることで、ループを完結させましょう。新しいパターンを特定したら、SLMの再トレーニングを行い、ガードレールのしきい値を更新します。こうすることで、評価システムは、時間の経過とともに自らを改善していくフライホイール型のシステムとなり、ユーザーとともに進化する人間参加型(Human-in-the-Loop)の生きた機能であり続けます。
戦略的な実装:自社開発か外部委託か
evalエンジニアリングのロードマップを計画する際、自社開発すべきか外部委託すべきかの判断に直面します。コンポーネントを自社で開発することは可能です。たとえば、LLM-as-judgeならばAPI呼び出し、SMEのワークフローはスプレッドシートによる管理、ガードレールは推論時のチェックで対応できます。
しかし、自問してみてください。エンジニアに任せたいのは、評価のための仕組み作りでしょうか、それとも実際の製品開発でしょうか。評価インフラは、コモディティとして外部サービスを購入または活用するようにし、エンジニアには、AIの本当の差別化要因につながるドメイン固有のカスタマイズ作業に完全に集中してもらえるようにすることが成功への近道です。
evalエンジニアリングに投資するタイミング
すべてのAIプロジェクトが、当初から本格的なライフサイクルを必要とするわけではありません。以下のとおり、リスクに見合った投資を行いましょう。
- リスクが低く、処理量も少ない:基本的なevalだけで十分です。
- リスクが高い(処理量は問わず):顧客向けエージェント、規制の厳しい業界、法的または財務的影響を伴う意思決定など。この場合、できるだけ早くevalエンジニアリングのライフサイクルを始めましょう。
- 処理量が多い(リスクは問わず):大規模運用では、たとえ「わずかな」不具合であっても積み重なれば大きな問題になります。求められるのは費用対効果の高い評価システムであり、SLMの導入が不可欠です。また、重要なのはカバレッジであり、ガードレールの実装が不可欠です。
evalエンジニアリングの導入
パイロット段階から本番環境への移行には、より優れたモデルを使うだけでは不十分であり、品質に対する体系的なアプローチが求められます。evalエンジニアリングのライフサイクルを取り入れることで、「運任せ」の開発サイクルから脱却し、動作を確実に保証できるAIをリリースしましょう。
よくある質問
関連記事
APIテスト:概要
evalエンジニアリングとは?
