Splunk Observability à .conf26 : optimiser l’IA à grande échelle
Observability Dave HickmanPoints clés
-
Maximiser la résilience des infrastructures
Splunk Observability vous aide à mettre l’ensemble de votre pile technologique au service de l’IA. Elle vous permet de visualiser les performances des GPU et des bases de données vectorielles, la consommation de la mémoire et les frameworks d’orchestration. Avec cette solution, vous savez instantanément si un problème se situe au niveau du code de l’application ou sur les chemins réseau, et vous pouvez traiter en priorité les problèmes qui menacent réellement les processus critiques pour les revenus de l’entreprise, comme les approbations de prêts ou l’exécution des commandes. Les annonces concernent Splunk Agent Observability pour l’infrastructure d’IA, Business Journeys, ThousandEyes Network Insights, la Network Intelligence App et Log Essentials for Observability Cloud. Résultat : un tri plus rapide dans une vue centralisée, une couverture plus large des logs sans frais excessifs et des problèmes classés en fonction de leur impact sur l’activité plutôt que du volume d’alertes.
-
Superviser le comportement des agents et optimiser la tokenomics
Splunk vous permet de déployer vos agents d’IA en toute sécurité : évaluez les agents, la sortie et la qualité de la RAG, bloquez les hallucinations, les injections de prompts et les failles de sécurité en cours d’exécution, et attribuez chaque token consommé à un utilisateur, à une équipe, à un modèle ou à un outil avant qu’il ne soit facturé. Les annonces concernent Splunk Agent Observability et Tokenomics. Résultat : ayez confiance dans le travail de vos agents, étayez les dépenses avec des budgets et des prévisions robustes, et établissez un lien clair entre l’investissement dans l’IA et une rentabilité mesurable.
-
Dépanner en toute autonomie
Splunk Observability aide vos équipes à détecter, analyser, synthétiser et résoudre plus rapidement les incidents : la solution regroupe les alertes connexes, localise la cause profonde possible, guide la remédiation en maintenant une intervention humaine constante et intègre l’observabilité aux nouvelles applications avant même leur passage en production. Les annonces concernent AI SRE in Splunk Observability Cloud, Observability Studio, ITSI 5.0 avec le regroupement et le diagnostic des alertes Event iQ, et l’édition gratuite d’Observability Cloud. Résultat : moins de tâches manuelles et de changements de contexte, une meilleure visibilité en production avec une dette technique réduite et un moyen simple de tester la valeur de la solution avant d’acheter.
Pendant longtemps, l’observabilité n’a pu répondre qu’à une question : « Qu’est-ce qui vient de subir une défaillance ? » Depuis, elle a évolué et répond désormais à une nouvelle question : « Puis-je faire confiance au comportement de mes agents IA ? » Pouvez-vous déceler une hallucination avant qu’un client n’y soit confronté ? Et pouvez-vous maîtriser le coût de la consommation de tokens d’IA ? Ces nouvelles questions ne remplacent pas les fonctions historiques de l’observabilité, qui restent plus cruciales que jamais. Mais il faut aujourd’hui traiter simultanément ces deux aspects pour identifier et prévenir les problèmes plus rapidement, et maintenir une visibilité allant de l’application à l’infrastructure, en passant par les processus métiers et l’IA elle-même.
Nous profitons de .conf26 pour présenter les dernières innovations Splunk Observability conçues pour accompagner cette évolution. Elles vous aideront à optimiser l’IA à grande échelle en maximisant la résilience de l’infrastructure, en supervisant le comportement des agents, en optimisant la tokenomics et en facilitant le dépannage autonome.
Ces annonces s’appuient sur la plateforme Splunk qui joue le rôle de couche d’intelligence pour la fiabilité des opérations agentiques à l’échelle de l’entreprise. La question n’est plus de savoir si une application fonctionne, mais si les agents se comportent correctement, sans dépasser les budgets. Levez ces obstacles et la généralisation de l’IA agentique ne sera plus un saut dans l’inconnu.
Pour vous donner cette visibilité, Splunk Observability innove dans quatre domaines interconnectés :
Commencez par la couche sur laquelle repose tout le reste.
Maximiser la résilience des infrastructures
Mettez l’ensemble de la pile technologique au service de l’IA
- Suivez en temps réel l’état de santé des processus métiers stratégiques et faites le lien entre les performances techniques et les résultats métiers grâce à Business Journeys in Observability Cloud.
- Avec ThousandEyes Network Insights, toujours dans Observability Cloud, déterminez instantanément si les problèmes se situent dans le code de l’application ou dans les chemins réseau.
- Transformez les signaux réseau en informations interdomaines avec l’application Network Intelligence, pour accélérer la détection, la correction et la résolution des problèmes.
- Bénéficiez d’un moyen économique d’analyser les logs avec Log Essentials for Observability Cloud, et déboguez les problèmes d’applications et d’infrastructure à l’aide de logs contextualisés.
Superviser le comportement des agents
Évaluez et encadrez le comportement des agents
- Renforcez la confiance dans l’IA en évaluant, en observant et en contrôlant le comportement et le coût des agents grâce à Agent Observability.
Optimiser la tokenomics
Gérez la consommation et l’utilisation de tokens pour garder le contrôle sur les coûts et mesurer l’adoption et le ROI de vos systèmes agentiques.
- Comparez le coût, l’adoption et la productivité des agents à la valeur métier qu’ils délivrent grâce à Tokenomics dans Agent Observability
Dépannage autonome
Résolvez les problèmes plus rapidement et créez des applications plus faciles à corriger.
- Automatisez la détection et la résolution des problèmes avec AI SRE et la corrélation des alertes afin d'accélérer la correction.
- Avec Observability Studio, instrumentez automatiquement le code généré par l’IA dès le premier jour pour éliminer les angles morts, les failles de sécurité et la dette technique de chaque application déployée.
- Accélérez l’intégration des nouveaux membres de l’équipe et les investigations grâce à la nouvelle expérience utilisateur d’ITSI 5.0 et à Event iQ, un outil de regroupement d’alertes et de diagnostic piloté par l’IA.
- Lancez-vous dans l’aventure de l’observabilité avec Observability Cloud Free Edition et avancez à votre rythme.
Voici les nouveautés de Splunk Observability présentées à .conf26.
Maximiser la résilience des infrastructures
Reliez les Golden Signals aux résultats métiers avec Business Journeys
Business Journeys in Observability Cloud – disponible en septembre 2026.
Face à l’amplification des workloads d’IA et à l’expansion des architectures distribuées complexes, les Golden Signals ne suffisent plus. Pour résoudre les incidents plus rapidement et cibler leur action, les équipes ITOps, les équipes d’ingénierie et les agents IA ont besoin d’un contexte métier plus étoffé pour comprendre non seulement quel service est touché, mais aussi l’impact de la défaillance sur le processus métier et l’intégrité des services. Les tableaux de bord de service traditionnels sont incapables de rendre compte des workflows multi-systèmes ; ils ne vous diront pas si l’intégration des nouveaux clients est bloquée, si le traitement des demandes de prêt est ralenti ou si des commandes ne respectent pas les SLA de livraison.
Business Journeys comble cette lacune en corrélant les sessions utilisateur (RUM) et les microservices en back-end (APM) à l’aide d’identifiants métiers. Découvert automatiquement à partir de votre instrumentation OpenTelemetry existante, Business Journeys fournit aux professionnels comme aux AI SRE le contexte nécessaire pour ramener de la certitude dans la cellule de crise et hiérarchiser la correction en fonction de l’impact commercial concret.
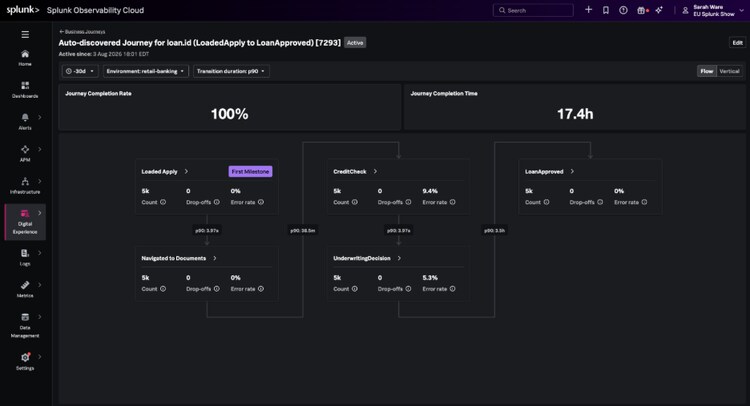
Pour en savoir plus, lisez Ne faites plus de conjectures sur les sujets cruciaux : Passez des Golden Signals aux parcours métier personnalisés.
Application ou réseau ? Répondez aux deux questions avec un même test
Visibilité du réseau dans Splunk Synthetic Monitoring – disponible en octobre 2026.
Chaque cellule de crise commence de la même manière : l’équipe de l’application affirme que ses services fonctionnent très bien, l’équipe réseau assure que ses chemins sont dégagés, et la réunion se prolonge pendant trois quarts d’heure alors que les utilisateurs subissent les conséquences de la défaillance. Cette impasse est le résultat du cloisonnement de la télémétrie et le MTTR en fait les frais.
Vous pouvez désormais créer et gérer des tests synthétiques portant sur les applications et le réseau depuis un seul et même endroit, avec plus de 1 000 points d’observation dans le monde. Les signaux de l’application et du réseau proviennent du même test afin d’identifier le point de défaillance en s’appuyant sur des preuves communes plutôt qu’en prolongeant la dispute. Vous pouvez ensuite analyser les données de télémétrie des applications associées dans Observability Cloud ou accéder directement aux diagnostics réseau de ThousandEyes.
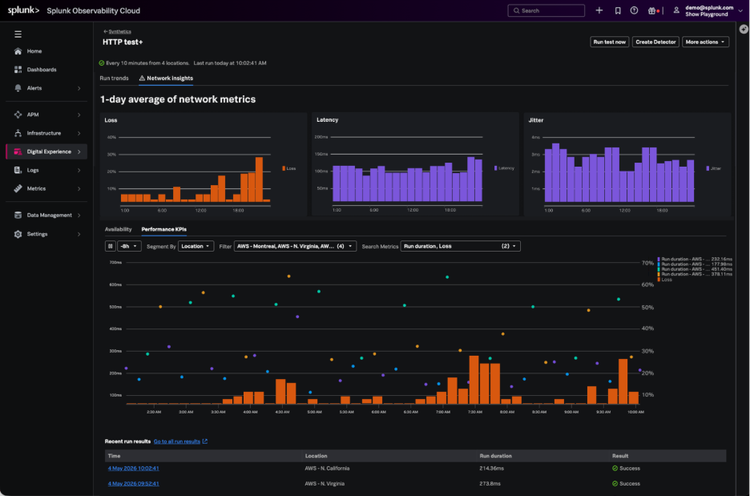
Pour en savoir plus, lisez Lancement de la Network Intelligence App et introduction de la visibilité du réseau dans Splunk Synthetic Monitoring.
Vous avez les données. Désormais, vous avez aussi le réseau.
Application Network Intelligence – disponible le 30 septembre 2026.
La plupart des entreprises envoient déjà des données réseau à Splunk. Network Intelligence en fait une image en direct du réseau : elle réunit la topologie, l’état et les événements des périphériques Cisco, et vous permet d’atteindre directement le périphérique concerné ainsi que les interfaces, liens et sites environnants. La topologie provient de vos contrôleurs Cisco ; elle offre donc un reflet fidèle de l’état actuel de votre réseau, et non le schéma de l’année dernière. Les clients Splunk n’ont aucune fonctionnalité à déployer ni rien à débourser.
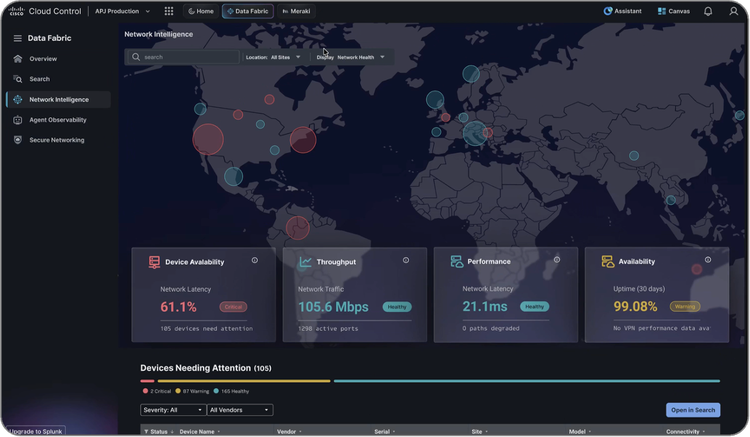
Pour en savoir plus, lisez : Lancement de la Network Intelligence App et introduction de la visibilité du réseau dans Splunk Synthetic Monitoring.
Observer le comportement des agents
Les agents fonctionnent 24 heures sur 24. Mais il faut encore que quelqu’un vérifie ce qu’ils font.
Splunk Agent Observability – disponible en septembre 2026 sur site et dans Cisco Cloud Control et Observability Cloud, optimisé par Galileo.
Les équipes créent des agents. Pourtant, leur déploiement à grande échelle reste problématique. Contrairement aux logiciels traditionnels, les agents ont une nature imprévisible et non déterministe. Ils n’ont pas non plus les contrôles de gouvernance et les garde-fous nécessaires pour mériter la confiance des utilisateurs et garantir un fonctionnement fiable, dans le respect des budgets.
C’est pourquoi nous avons fait l’acquisition de Galileo. Galileo, désormais Splunk Agent Observability, évalue les agents, les sorties et la qualité de la RAG à l’aide d’évaluations de haute précision. Ses évaluateurs prêts à l’emploi ou personnalisés se chargent de la supervision pour un coût très inférieur à celui des juges LLM reposant sur des modèles frontière. Les équipes peuvent ainsi observer 100 % du trafic sans échantillonnage, et donc visualiser la cause profonde des erreurs dans les workflows agentiques complexes. De plus, les petits modèles de langage (SLM) Luna finement ajustés, qui garantissent des évaluations à faible latence et à moindre coût, permettent d’appliquer des garde-fous au moment de l’exécution pour bloquer les hallucinations et d’autres types de problèmes.
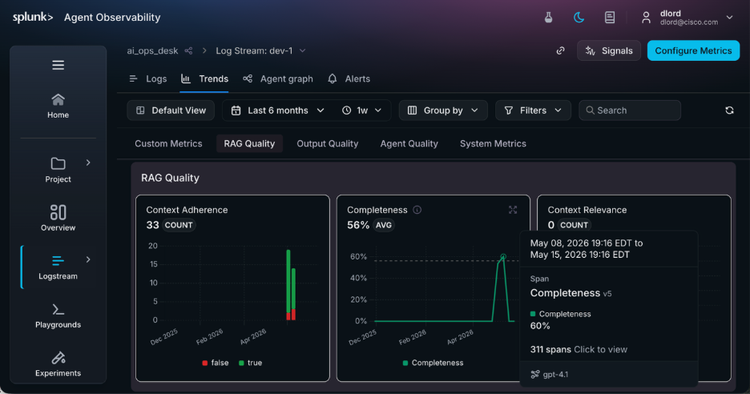
Lisez cet article pour en savoir plus sur l’observation, l’évaluation et la protection de vos agents IA avec Splunk Agent Observability.
Optimiser la tokenomics
Une meilleure visibilité sur les coûts pour éviter les mauvaises surprises en fin de mois
Tokenomics – disponible en septembre 2026 dans Splunk Agent Observability.
Vous connaissez cette angoisse qui vous saisit quand arrive une facture mensuelle au montant incompréhensible ? C’est un écueil qui touche beaucoup d’organisations d’ingénierie qui ont adopté des assistants de code IA comme Claude Code et Codex.
Tokenomics apporte une visibilité unique sur les coûts, l’adoption et la productivité des agents de codage. Les responsables financiers et techniques peuvent analyser les pics de coût et les attribuer aux utilisateurs, aux équipes, aux modèles et aux fournisseurs d’outils afin d’optimiser la consommation et les dépenses, et de faire le lien avec leur valeur métier. Ils peuvent également prévoir les tendances de consommation et anticiper les dépenses avant la facturation grâce au Cisco Deep Time Series Model (CDTSM). Quant aux équipes, elles peuvent définir des budgets, obtenir des informations sur les anomalies pour responsabiliser les différentes parties prenantes et optimiser l’efficacité des outils.
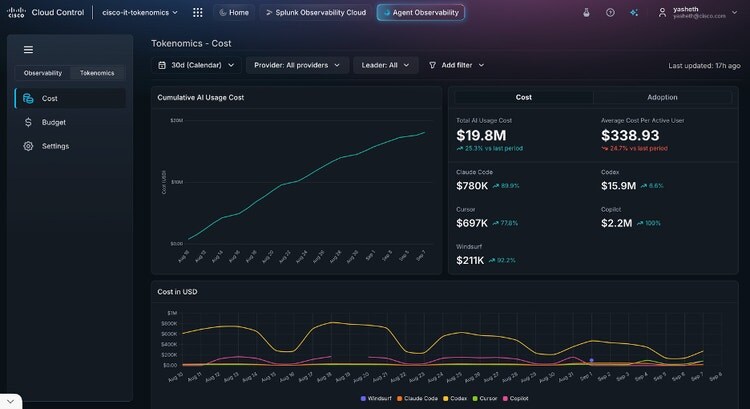
Pour en savoir plus sur l’attribution de l’utilisation, des dépenses et de l’adoption des agents de codage avec Tokenomics, lisez cet article.
Dépannage autonome
Moins d’alertes, moins d’efforts de débogage, des réponses plus rapides
AI SRE in Observability Cloud – Disponible dès maintenant.
Les équipes d’ingénierie passent encore trop de temps à parcourir une multitude de tableaux de bord. Les déluges d’alertes et les changements de contexte constants dissimulent la cause profonde qui explique des signaux épars. Les temps d’arrêt se prolongent et les employés s’épuisent.
AI SRE, véritable coéquipier agentique, est là pour alléger la complexité et la charge de travail. Le système d’alerte intelligent regroupe les alertes sous la forme d’incidents unifiés et exploitables. L’agent IA de dépannage analyse les données MELT pour localiser l’origine potentielle d’un problème complexe. Les équipes peuvent alors lancer des plans de remédiation guidés ou faire appel aux Claude Managed Agents (CMA) d’Anthropic pour corriger le code dans des environnements de test sécurisés. Les ingénieurs conservent un contrôle total pour une confiance maximale.
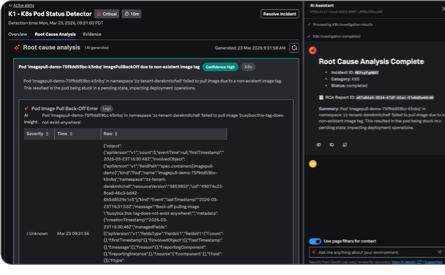
Pour en savoir plus, lisez AI SRE, votre nouveau collègue agentique .
L’observabilité qui commence avant le déploiement du code.
Observability Studio – Disponible dès maintenant.
Le code généré par IA passe rapidement en production, et cette vélocité peut avoir des conséquences imprévues et nuire à la visibilité des personnes qui l’exécutent. Les applications sont développées sans outils pour les superviser, les déboguer ou les administrer, et cette dette s’alourdit sans cesse.
Pensé pour les développeurs, Observability Studio permet d’intégrer une instrumentation OpenTelemetry aux applications dès le départ, y compris lorsqu’elles sont développées à l’aide d’agents IA comme Claude Code et Codex. Des workflows guidés, moins de conjectures dans les configurations et une instrumentation ajoutée en quelques minutes plutôt qu’en plusieurs heures, sans expertise spécifique d’OpenTelemetry. Après avoir « supervisé ce que vous avez développé », l’heure est venue de « développer des logiciels observables dès le départ ».
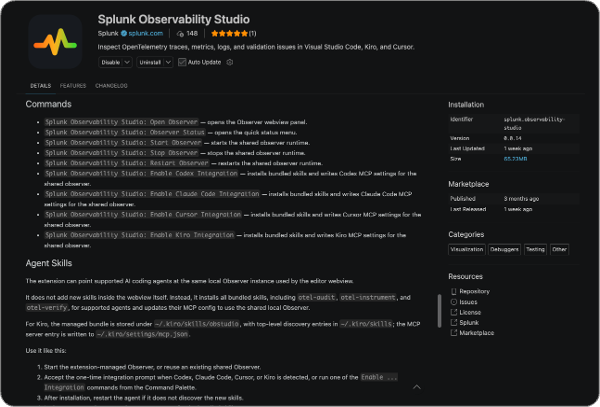
Pour en savoir plus, lisez Observable dès le départ : les applications générées par IA et les agents ont besoin de visibilité dès le premier jour.
Un modèle qui apprend de vos analystes pour réduire le bruit des alertes
ITSI 5.0 + Event iQ – Disponible dès maintenant.
Event iQ Detect, dans Splunk IT Service Intelligence, utilisait déjà le machine learning pour sélectionner les champs intéressants à corréler. Désormais, il apprend de votre équipe. Lorsqu’un intervenant divise un épisode qui regroupait des alertes sans rapport, ou en fusionne deux qui relèvent du même incident, ces informations sont réinjectées dans le modèle au moment du réentraînement. La précision du groupement s’améliore à l’usage sans longues sessions d’ajustement manuel.
Event iQ Diagnose délivre un résumé en langage clair d’un épisode actif ou résolu, accompagné de la cause profonde probable et de recommandations d’action. Très pratique pour un analyste de niveau 1 à minuit. Pratique également pour le cadre qui a besoin d’une réponse immédiate.
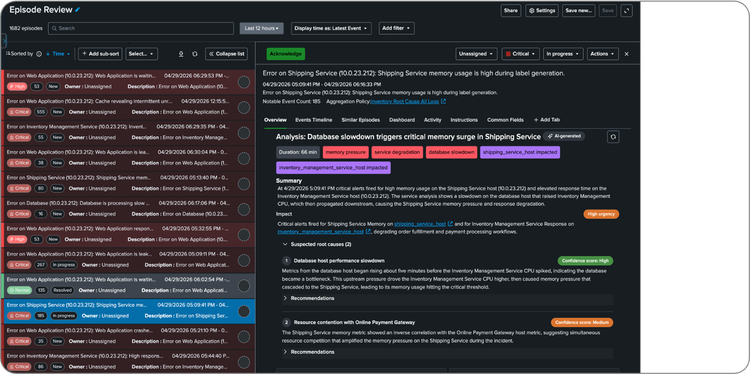
Pour en savoir plus, lisez la Présentation de Splunk IT Service Intelligence 5.0.
Oubliez les essais à durée limitée et lancez-vous
Observability Cloud Free Edition – Disponible le 1er juin 2026.
Une solution de visibilité professionnelle, gratuite pour un maximum de 15 hôtes, sans date d’expiration. Pas de carte de crédit, pas de cycle d’achat, pas de discussion commerciale. Importez votre propre télémétrie ou essayez le Playground préconfiguré : vous y trouverez des tableaux de bord, des traces APM, une infrastructure, des alertes et des informations générées par IA. L’observabilité des agents, incluse dans cette version, vous permet de suivre les interactions des agents, les appels de modèles, l’utilisation des outils, la latence et les erreurs, pour que vous sachiez précisément pourquoi un agent a agi comme il l’a fait. Cette version comprend toutes les fonctionnalités : tout ce que vous y faites est directement mis en production.
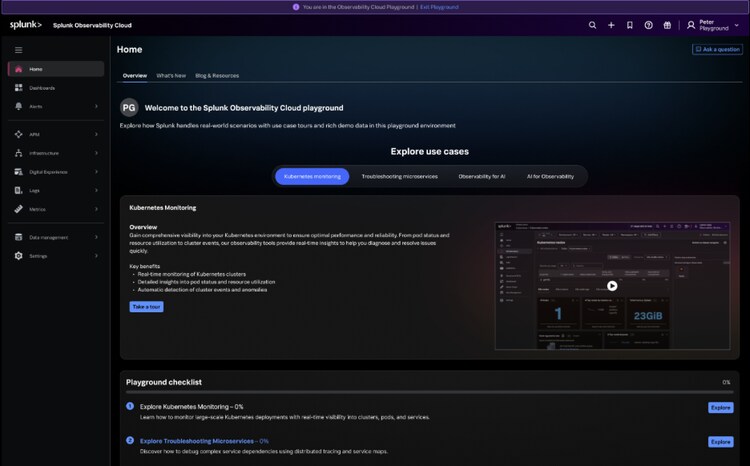
Pour en savoir plus, lisez Des informations détaillées sans obstacle : Splunk Observability Cloud Free Edition.
Deux éditions. C’est tout.
Fluidifier l’adoption avec les éditions simplifiées : Observability Essentials et Observability Premier – disponibles début novembre 2026.
Notre portefeuille de solutions d’observabilité s’est rapidement étoffé et ses modalités d’achat ont également évolué. Il offre toujours plus de fonctionnalités, d’options et de façons d’adapter votre déploiement aux besoins précis d’une équipe. Cette flexibilité a été d’une grande utilité, mais c’est aussi le bon moment pour prendre du recul et apporter un peu de clarté.
Nous avons donc décidé de simplifier. Splunk Observability se présentera désormais en deux éditions, Essentials et Premier, pour reprendre la structure que les clients de Splunk Security connaissent bien. Dans les deux éditions, les tarifs par hôte restent les mêmes ; rien ne change concernant les modalités d’achat. Les deux versions incluent également Agent Observability, AI SRE et Log Essentials, parce qu’à l’heure des agents, la visibilité full-stack n’est pas un luxe, mais un minimum vital.
Essentials couvre tout cet aspect, ainsi que la supervision de l’infrastructure et l’APM. L’édition Premier s’adresse aux équipes qui souhaitent des capacités supplémentaires pour exploiter davantage de logs, de traces et de sessions par hôte, ainsi que d’autres catégories de fonctionnalités avancées : Database Monitoring, Digital Experience Monitoring et Digital Experience Analytics, Secure Applications, et une optimisation d’Agent Observability grâce au modèle Luna et aux ingénieurs déployés sur site (FDE).
Deux voies seulement. Les niveaux de couverture et les tarifs exacts seront disponibles au lancement début novembre.
Une observabilité qui change de forme avec votre pile
Observability Essentials et Observability Premier – disponibles début novembre 2026.
Les équipes ne posent plus les mêmes questions à l’observabilité. Il y a un an, elles s’intéressaient aux services, à la latence et aux budgets d’erreur. Il faut maintenant ajouter à cela le comportement des agents, la qualité de l’évaluation et la consommation de tokens, et toutes ces interrogations proviennent souvent du même ingénieur, au cours de la même semaine. Les opérations agentiques n’ont pas remplacé les tâches traditionnelles, elles s’y sont superposées.
Observability Cloud devait accompagner cette évolution. Nous avons donc choisi de simplifier le processus d’achat en proposant deux éditions, adaptées à la position réelle des équipes sur cette courbe.
L’édition Essentials assure les fondamentaux : Infrastructure Monitoring et APM, ainsi qu’un aperçu d’Agent Observability pour les équipes qui développent leurs premières applications agentiques et souhaitent observer leur comportement avant de passer à l’échelle supérieure.
L’édition Premier s’adresse aux équipes qui exploitent l’agentique à grande échelle et investissent sérieusement dans ces applications. Une couverture plus large des fonctionnalités de base, notamment pour les logs, une version plus poussée d’Agent Observability avec Luna, le modèle d’évaluation à moindre coût, et des fonctionnalités avancées comme Database Monitoring et la sécurité des applications.
Autre changement notable : les logs font désormais partie intégrante de l’acquisition de la solution d’observabilité. Les métriques, les traces et les logs sont réunis dans les deux éditions.
Deux voies seulement. Les niveaux de couverture et les tarifs exacts seront disponibles au lancement début novembre.
Conclusion
L’observabilité évolue. Les dernières innovations de Splunk Observability rapprochent cet avenir : Agent Observability et Tokenomics pour évaluer le comportement des agents et gérer la consommation et l’utilisation de tokens, Network Intelligence et ThousandEyes Network Insights pour arbitrer entre application et réseau, Business Journeys pour relier les signaux techniques à l’impact métier, et l’aide de l’IA pour instrumenter, détecter, investiguer, résumer et recommander des actions afin de comprendre, anticiper et corriger l’impact métier. Moins de bruit. Des réponses plus rapides. De meilleures expériences numériques.
Obtenez gratuitement Observability Cloud ou réservez une démonstration pour découvrir comment Splunk peut vous aider à accélérer vos opérations, résoudre les problèmes plus intelligemment et faciliter la mise en place d’opérations agentiques de confiance.
Une grande part des produits et fonctionnalités décrits ici sont encore à différents stades de développement et seront proposés en fonction de leur disponibilité. Le calendrier de livraison de ces produits et fonctionnalités est susceptible d’être modifié à la seule discrétion de Cisco, et Cisco ne peut être tenu pour responsable des retards de livraison ni de l’annulation des produits et fonctionnalités décrits dans ce document.
Article connexes
Splunk Observability à Cisco Live : l’observabilité agentique à l’ère de l’IA
Présentation de Splunk IT Service Intelligence 5.0