Lancement de la Network Intelligence App et introduction de la visibilité du réseau dans Splunk Synthetic Monitoring
Observability Courtney DragoonTous les voyants sont au vert dans l’environnement qui est sous votre responsabilité. Mais alors, pourquoi ces ralentissements dans l’application ?
Un utilisateur de Sydney se plaint de lenteurs dans le processus de paiement. APM semble dire que tout va bien. L’infrastructure semble en bon état. L’application répond. Tous vos tableaux de bord sont au vert, et ils ont tous raison.
Le problème se situe à un niveau que ces tableaux de bord n’ont jamais supervisé.
Vous contrôlez de moins en moins des systèmes qui sont impliqués dans une transaction. L’authentification se fait via Okta. Stripe traite les paiements. Vous voyez l’appel partir et le résultat revenir, mais rien entre les deux. Tout repose sur une couche que vous n’avez jamais pu instrumenter : vous n’avez pas la main sur le mécanisme de résolution de noms, et chacun de ces appels traverse des chemins FAI que vous n’administrerez jamais. Lorsque c’est là que se situe le problème, votre instrumentation ne peut pas vous le dire. Ce n’est pas un problème de configuration : c’est simplement que l’attribution s’arrête aux frontières de ce que vous contrôlez.
Le plus souvent, le réseau dont vous êtes propriétaire se trouve ailleurs. Les équipes réseau utilisent leurs propres outils pour gérer les périphériques, les interfaces et les liaisons. Les équipes d’application en ont d’autres pour superviser les services et les traces. Deux équipes, deux images, et un exercice de réconciliation indispensable avant de passer à l’action. Les deux équipes ont leurs données. Il leur manque simplement l’autre moitié : les appareils que vous administrez et le chemin que vous ne contrôlez pas. Et idéalement, ces données devraient apparaître dans l’interface de dépannage.
Découvrez le réseau que vous administrez, et les autres
Aujourd’hui, nous élargissons l’observabilité du réseau dans Splunk avec deux fonctionnalités qui éclairent les deux côtés de cet angle mort.
- La visibilité du réseau dans Splunk Synthetic Monitoring ajoute des données probantes issues du réseau et d’Internet aux tests d’applications synthétiques, pour étendre l’investigation aux chemins de distribution et aux dépendances sur lesquels vous n’avez pas de contrôle.
- La Network Intelligence App intègre le réseau d’entreprise que vous exploitez dans Splunk : les périphériques, les interfaces, la topologie, les événements et les relations qui les unissent.
Avec un seul test, des preuves issues de l’application et du réseau
La supervision synthétique sait toujours répondre à une question clé : est-ce que l’expérience utilisateur fonctionne ? Synthetic Monitoring dans Splunk Observability Cloud peut désormais fournir les preuves réseau qui expliquent les défaillances.
Créez un test HTTP comme vous le faites habituellement. Il s’exécute sur un réseau mondial d’agents comptant plus de 1 000 points d’observation, couvrant plusieurs FAI dans une même ville, pour déterminer si un problème affecte tous les fournisseurs ou un seul d’entre eux. Ajoutez des agents au sein de votre propre environnement pour étendre la couverture à l’intérieur du périmètre de votre pare-feu. Les résultats de l’application et les mesures du réseau proviennent désormais du même test.
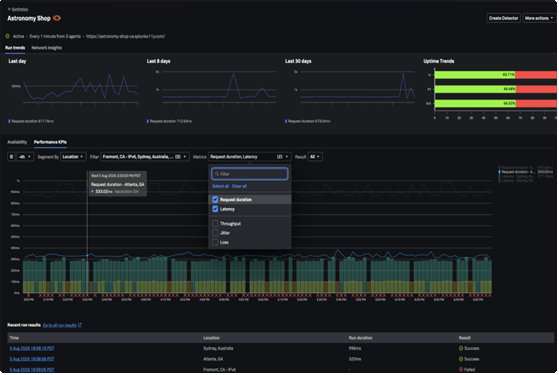
Les chiffres de temps de réponse, de latence, de perte de paquets et de jitter d’un même test s’affichent côte à côte. Plutôt que de créer un pipeline OpenTelemetry pour importer un flux réseau distinct, puis d’aligner deux datasets a posteriori, un même test délivre les preuves d’application et celles du réseau.
Si le temps de réponse augmente en même temps que la latence ou les pertes de paquet, vous savez où chercher. Si les conditions du réseau sont bonnes alors que la transaction est lente, l’équipe d’application peut cesser d’y chercher la cause du problème et passer à autre chose.
Et quand toutes les preuves désignent le réseau, vous n’êtes pas cantonné aux limites de votre propre environnement. Passez directement du résultat synthétique à la visualisation du chemin pour le test en question, à ce moment précis : saut par saut, en connaissant le FAI, le résolveur et le chemin cloud. Vous pouvez tout à coup atteindre les dépendances hors d’accès de votre instrumentation : les chemins Internet, l’infrastructure du FAI, le DNS et les réseaux cloud qui font le pont entre votre service et vos utilisateurs. Vous obtenez des données sur une infrastructure dont vous dépendez, mais que vous n’administrerez jamais.
Et si votre équipe réseau ouvre le même test dans ThousandEyes, elle verra les mêmes résultats ; les deux équipes s’appuient donc sur les mêmes preuves et une image commune de l’incident. Vous pouvez également créer des détecteurs pour les signaux de test réseau compatibles (disponibilité, durée d’exécution, résolution DNS), à l’aide du workflow qui vous sert déjà pour tous les autres détecteurs.
Les métriques réseau font partie d’une catégorie importée gratuitement dans Splunk : vous ne serez pas facturé deux fois pour des données que vous possédez déjà.
Disponible le 21 octobre, en commençant par les tests HTTP ; d’autres types de tests suivront.
Comprenez le réseau que vous exploitez.
L’autre partie du problème réside au sein même du réseau d’entreprise. Les équipes d’application voient une dépendance de service ; les équipes réseau, quant à elles, voient des périphériques, des interfaces, des liens, des sites et une topologie. La nouvelle Network Intelligence App intègre ce modèle opérationnel à Splunk au lieu d’exiger des équipes réseau qu’elles traduisent leur environnement pour adopter le point de vue des applications.
La topologie provient de vos contrôleurs, pas d’un schéma. L’application extrait directement la topologie de vos contrôleurs Cisco (Meraki, Catalyst Center, SD-WAN Manager) et affiche les relations physiques et logiques actuellement présentes au sein de votre environnement, plutôt qu’un schéma obsolète depuis des mois. Elle modélise ensuite le réseau de façon à refléter son comportement réel, sous la forme d’un graphe de relations, et non d’une hiérarchie unique.
De l’événement à la topologie en passant par les périphériques, dans un même workflow. Un événement survient, vous consultez l’appareil concerné : les interfaces, les liens et le site qui l’entourent sont à votre portée immédiate, sans que vous ayez à consulter un outil de sondage, une console de contrôle ou une carte pour reconstituer le parcours à la main.
Pas de page blanche. L’application détecte, classe et supervise vos appareils par défaut, et comprend des profils prêts à l’emploi pour les familles de plateformes Cisco compatibles pour vous libérer du projet de configuration généralement incontournable avant que quiconque puisse observer un appareil.
Rien à acheter, rien à déployer. La Network Intelligence App est gratuite pour les clients Splunk et fonctionne avec les données réseau Cisco que, tous ou presque, vous nous envoyez déjà. Il n’y a pas de pile de collecte à ajouter ni de projet de déploiement sur plusieurs mois à mener avant de cueillir les premiers fruits.
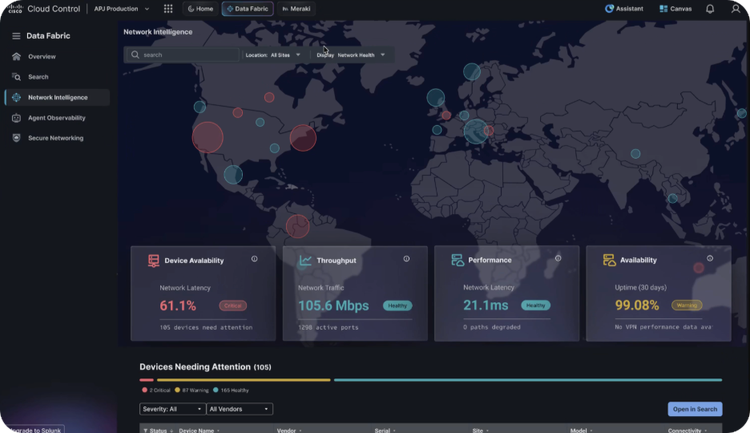
Network Intelligence App dans Cisco Cloud Control
La topologie et le contexte de l’événement résident déjà dans Splunk, donc la destination est la même. Vos données réseau ne sont plus enfermées dans un outil à part : elles rejoignent les activités de corrélation et de dépannage full-stack, et c’est ce changement majeur qui motive les deux annonces d’aujourd’hui. C’est dans les systèmes que les équipes instrumentent directement que l’observabilité est la plus performante, mais l’expérience numérique ne s’arrête pas là. Elle repose sur des réseaux d’entreprise, des fournisseurs de cloud, des DNS, des FAI et des chemins Internet qui comptent tout autant pour les performances.
Vous bénéficiez ainsi d’un parcours plus complet du symptôme à la preuve : vous commencez par l’expérience utilisateur ou synthétique, vous déterminez l’impact de l’état de l’application ou du réseau, vous suivez la trace du problème lorsqu’il se situe au-delà des frontières de votre environnement ou vous inspectez le réseau d’entreprise quand le point de défaillance s’y trouve. En effet, quand une expérience numérique se dégrade, il ne suffit pas de savoir qu’il y a un problème. Il faut aussi savoir où le chercher, quelles preuves l’expliquent et qui peut agir.
Disponible à partir du 30 septembre, en commençant par la topologie des périphériques Cisco ; la prise en charge des périphériques tiers suivra.
Pour commencer
- Visibilité du réseau dans Splunk Synthetic Monitoring – disponible le 21 octobre pour les clients de Splunk Observability Cloud et ThousandEyes. La configuration repose sur l’établissement d’une liaison OAuth unique entre les deux produits ; les règles RBAC de chacun d’eux sont appliquées.
- Network Intelligence App – disponible le 30 septembre.
Cisco IT a réduit ses temps moyens de détection et de résolution de 45 % d’une année sur l’autre en gérant ses propres opérations de cette manière.
* De plus, dans une étude Forrester Total Economic Impact™ commandée par Cisco, une organisation composite a réduit de 60 % le délai d’identification des incidents perturbateurs avec ThousandEyes.
* Étude de cas Cisco-sur-Cisco ; reflète la stratégie d’observabilité globale de Cisco IT plutôt que ces capacités prises isolément.
Article connexes

Pourquoi l’observabilité sans OpenTelemetry n’a pas de sens (présentation) ?

Splunk AppDynamics 24.10 Accelerates Deployment And MTTR
