Cisco Deep Time Series Modelによる生成AIベースの異常検出
Platform Brian Goleno主なポイント
- AIを活用したSplunkの新しい異常検知と予測機能によって、顧客に影響が及ぶ前に異常な挙動を検知し、問題を予測できます。
- Cisco Deep Time Series Modelは、トレーニングも手動でのしきい値設定も不要で、高度な監視を大規模に展開できます。
- 予測アラートによって潜在的な問題を数時間前に検知できるため、事後ではなく事前に障害を防止できます。

午前3時にアラート通知が届くとあなたは目を覚まし、トリアージを行って、問題を修正してからベッドに戻ります。
心当たりはありませんか?これはよくある事後対応の流れです。この方法は負担が大きく、コストもかかるうえ、しきい値の設定が追い付かないほどにスタックが拡大する中、ますます継続が困難になっています。
ですがSplunkは、この現状を打破するための重要な一歩を踏み出しました。現在Splunkは、Cisco Deep Time Series Model (CDTSM)を活用した、生成AIベースの時系列異常検出を提供しています。この基盤モデルはゼロショット学習型の生成AIを活用し、機械データ専用に構築されたものです。トレーニングも、データサイエンスの専門知識も不要です。AI Toolkitをインストールすれば、すぐにお使いいただけます。
AIによる予測アラートを活用したこの機能は、新たな運用モデルである 「予測と予防」 の始まりを告げるものです。
「アラート待ち」体制の問題点
オブザーバビリティに関する従来の手順(しきい値を設定して異常が発生するまで待機し、通知が届いたらトリアージを実行して修正する)は、スタックが今よりも単純だった時代には理にかなっていました。しかし状況は変わりました。
大量のマイクロサービスを駆使し、AIが生成したコードで駆動する現代の分散型アプリは、膨大な数のメトリクスの時系列データを生成します。一般的なSaaSプラットフォームでは、数千万件のメトリクス時系列が生成されることもあります。そのすべてに対し、適切なしきい値を設定・維持することは、1人の人間には不可能です。チームであっても無理でしょう。とても現実的とは言えません。そのうえ、今後のAI生成アプリの増加によって、この問題はさらに悪化するでしょう。
静的なしきい値では段階的な悪化を検出できず、ノイズの元となります。また、すでに起きたことを知らせるだけで、これから起きることを知らせるわけではありません。従来とは異なるモデルが求められています。まずは、システム全般の変化を察知できる異常検出の仕組みが必要です。異常検出と予測は新しい概念ではありませんが、複雑さ、拡張性、信頼性などの問題が重なり、こうした機能を大規模に展開するのは困難でした。
Splunkプラットフォームの生成AIによる異常検出
Splunkとシスコは、Hugging Face上でCisco Time Series Model 1.0を公開しました。これは、複雑な機械データへの対応に特化した生成AI基盤モデルです。私たちはこのモデルを、Cisco Deep Time Series Model (CDTSM)として、Splunkプラットフォームに直接統合しました。
その結果、ログ由来のメトリクスや直接収集したメトリクスを含む、あらゆる時系列データから、オンデマンドで異常を検出・予測できるようになりました。しかも、これまでは専門知識が必要だった、機械学習ベースの複雑なモニタリング作業は一切不要です。
導入も簡単で、SplunkbaseからAI Toolkitをインストールまたはアップグレードした後、監視したいKPIのクエリを作成するか、既存のクエリを開き、CDTSMを適用するための簡単なSPLコマンドを追加するだけで利用できます。これをアラートとして保存すれば、しきい値を設定しなくても検出範囲を拡大できます。
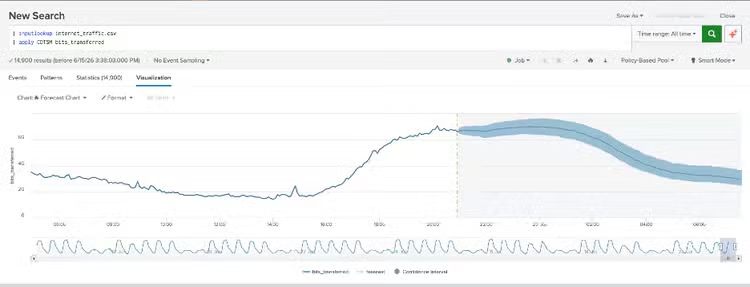
今回のリリースでは、グラフやUXの改良とともに、新しいタイプのアラートである 予測アラート を導入したことで、AIによる予測が大幅に改善されました。KPIがSLO (サービスレベル目標)に違反した後ではなく、SLO違反が予測された時点で、予想時刻とともに最大10時間前に通知を受け取ることができます。
これは端的に言えば、顧客が気づく前に十分な対応の時間を確保できるということです。
機械データのためにゼロから構築
CDTSMは、2億5000万個のパラメーターを持つ小型モデルで、実際の機械データのユースケースから得られた2兆個の独自データポイントを用いて学習しており、そのデータ量は現在も増え続けています。CDTSMは、競合する時系列モデルよりも長い、最大3カ月分のシグナル履歴を分析できます。設定は一切不要で、複雑に重なった周期的な変動パターン(時間、日、週、月ごと)にも対処できます。
Prophet、ARIMA、DensityFunctionといった従来のアプローチと異なり、メトリクスごとの調整は必要ありません。ゼロショット型学習を採用しており、メトリクス履歴のコンテキストウィンドウを入力すると、今後起こり得る挙動の幅を表す分位数バンドを最大15個出力し、予測を提示します。このモデルは、膨大な数の時系列データから、インフラやAPM、リアルユーザー、コンポーネント、ネットワークといったメトリクスのパターンを事前に学習済みであり、「正常な状態」をあらかじめ把握しています。
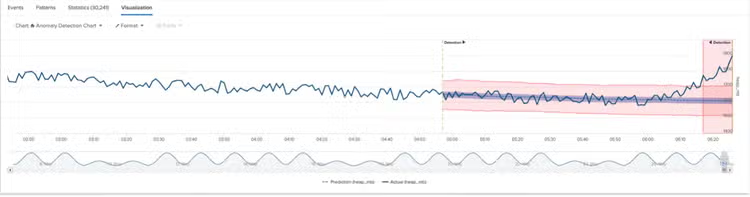
生成AIによる異常検出機能は、この基盤の上に構築されています。観測された値をモデルの予測や信頼区間と比較し、感度設定によってフィルタリングすることで、ノイズを省いた意味のある変化だけを抽出することができます。
その結果、周期的パターンによる誤検出は減少し、単純な移動平均ベースラインでは見落とされるような真の異常を検出しやすくなりました。
もう1つ重要なのは、すべての予測処理が専用のGPUサーバーで実行され、ユーザーのサーチヘッドには負荷がかからないという点です。そのため、検索やアラートの速度には影響しません。
MTTRからMTTPへ
実際の運用をご紹介しましょう。木曜日の午後2時、チェックアウトの遅延に関する異常検出アラートが発信されます。この日、この時間帯としては異例のことで、挙動に何らかの変化があったことを示しています。まだしきい値には達していませんが、シグナルに無視できない変化が見られるため、ひとまずそれを記録します。
15分後、次のような予測アラートが届きます。「チェックアウトの遅延は、20分後に警告しきい値を、45分後に重大しきい値を超えると予測されます」
あなたはエスカレーションを実行し、対応チームが動き出します。そして、顧客が誰ひとり気づかないうちに問題は解決されます。
これこそが、MTTR(平均回復時間)とMTTP(平均予防時間)の違いです。システムの稼働率スコアは「グリーン」のままで、誰も午前3時に通知を受け取ることはなく、落ち着いて業務を続けられます。
異常検出アラートは変化の発生を知らせ、予測アラートはその先の展開を知らせます。両者を組み合わせることで、「何か異常が起きている」という状態から、「すでに先手を打っている」状態へ移行できます。これが「予測と予防」に基づく運用です。ほんの少しの予測でも、事後対応を何倍も上回る価値があるのです。
オンプレミスでの使用についても、問題ありません
本番サービスを運用しているチームであれば、Splunk Cloudをご利用の場合でも、データセンターの隔離環境で独自運用している場合でも、この機能をご利用いただけます。
Splunk Cloud:設定は不要です。CDTSMは、お使いのSplunk Cloudリージョン内に配置された、専用の自動拡張型GPUサーバー上で稼働します。可用性が高く、サーチヘッドへの負担はゼロです。
オンプレミス/自己ホスト型:Cisco Time Series Modelを自社のインスタンスとして運用してください。使用するRAMはわずか2GBで運用しやすく、CPUでもGPUでも稼働します。非常に軽量なので、ノートパソコンでも簡単に運用できます。インストールするには、GitHubからリポジトリを複製して「docker compose up」というコマンドを実行するだけです。その後、設定ファイルを1つアップデートすれば、すべて完了です。詳細については、機能に関するドキュメントをご確認ください。
今すぐ始めましょう
Splunkユーザーの方:SplunkbaseからAI Toolkitをインストールしてください。機械学習のスキルは不要です。ログ由来のメトリクスや直接収集されたメトリクスを含む、あらゆる時系列データを処理できます。オンプレミスでもSplunk Cloudでも問題ありません。監視したいKPIのクエリを作成し、今すぐアラートの範囲を広げましょう。
研究者および開発者の方:このモデルはApache 2.0ライセンスで提供されているオープンウェイトモデルであり、現在以下のサイトから入手できます。
- Hugging Face: cisco-ai/cisco-time-series-model-1.0
- GitHub: splunk/cisco-time-series-model
- PyPI: pip install cisco-tsm
すぐに使えるノートブックと性能評価を再現できるベンチマークも付属しており、商業利用も可能です。
これからの運用に求められるのは、対応の速度ではなく、対応そのものを不要にすることです。
関連記事

データライフサイクル管理:完全ガイド
カオスなデータを明快な情報へ:Splunk Data Management完全ガイド
