Splunk購入の選択肢 - ワークロードベース価格体系と取り込みデータ量ベース価格体系
Platform SplunkSplunk購入の料金モデル、ワークロードとは
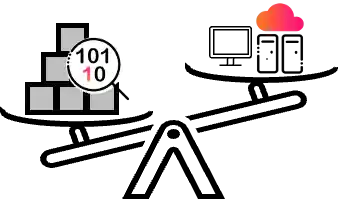
Splunk購入時の料金モデルとして「取り込みデータ量ベース価格体系(Ingest Pricingモデル)」とSplunk Cloudのワークロードとストレージに準じた「ワークロードベース価格体系(Workload Pricingモデル)」が選択できます。ワークロードとは、データに対して行う様々な活動を指します。具体的には検索、調査、監視、機械学習、データストリーミング、データインデックス、データ処理などの活動が含まれますが、代表的な例としてはコンプライアンス、データ レイク、基本的なレポート、アドホック調査、継続的な監視などが挙げられます。
Splunkの取り込みデータ量ベース価格体系は、取り込むデータ量に基づいて課金されるため、必要なデータを事前に絞り込む必要があります。しかし、セキュリティやIT運用のユースケースでは、問題が発生するまでどのデータが必要か明確でないことが多く、事前にデータを絞り込むことが困難です。その結果、必要なデータを取り込むことができず、ユースケース開発の柔軟性が制限されることがあります。
ワークロードベース価格体系を選択する理由
ワークロードベース価格体系は、データ量に起因するコストが軽減され、データの絞り込みの必要性が少なくなるため、レジリエンスが求められる状況に適しています。また、Splunk Cloudを使用すると、DDAA/DDSSやS3などのコストメリットの高いストレージとの統合サーチなどの組み合わせが可能となり、ストレージコストの最適化も可能です。
取り込むデータ量が限定的で分析内容が確定している場合は取り込みデータ量ベース価格体系が適していますが、必要なデータの絞り込みが難しい場合やレジリエンスが求められる局面では、ワークロードベース価格体系の検討をお勧めします。
ワークロードを確認して調整する
ワークロードに必要なリソースはSVC (Splunk Virtual Compute)単位で表現します。数秒毎に各マシンのSVC使用量を取得し、1日の終わりに最大使用量を算出します。SVCの使用量は、Cloud Monitoring Console (CMC)*を使用して1時間単位で常時確認できます。
* Splunk Cloud Platformの管理者向けに設計されています。CMCは、Splunk Cloud Platformのデプロイメントのステータスを監視し、データの取り込み、インデックス作成、検索、ユーザーの行動などの情報を提供します。
SVCは主にサーチの負荷に影響を受けます。特に、実行時間の長いサーチを同時に複数実行すると、SVCの消費が大きくなります。SVCは割り当てられたリソースを超えることはありませんが、通常、SVCライセンスに基づいて割り当てられるリソースは、ライセンスされたSVCよりも少し多めに設定されています。
SVCの上限を超えた場合は、サーチの実行タイミングを分散させるか、サーチを改善して実行時間を短くすることで、SVCの消費を抑えることができます。上限に達すると、リソースの空きを待つためにサーチの実行時間が通常よりも長くなります。この場合でも、スケジュールサーチやダッシュボードの表示に業務影響がなければ、次回のライセンス更新までそのまま利用できます。
一方、スケジュールサーチやダッシュボードの表示に業務影響がある場合は、SVCを追加してサーチ速度を改善する必要があります。また、SVCの消費がライセンスの上限に達していなくても、大量のデータを対象とするサーチの速度を確保するために、サーチ速度を改善する必要がある場合があります。そのような場合にもSVCの追加が必要です。
新たなスキルや知識の獲得でより効果的に使う
ワークロードベース価格体系の適用に際して、新たなスキルや知識の獲得が必要になる場合があります。
- Splunkの基本知識:Splunkプラットフォームの基本的な操作や機能についての理解(データ取り込み、検索、ダッシュボード作成など)。
- リソース管理のスキル:CMCを使用してリソースの使用状況を監視し、最適化する能力
- データ分析:データのインデックス作成や検索に関する経験
- コスト管理の知識:リソース使用量に基づく料金モデルのため、コスト管理や予算管理の知識
ワークロードベース価格体系に移行するステップ
以下のステップを通して取り込みデータ量価格体系からワークロードベース価格体系に移行できます。
- 現状評価:現在のデータ取り込み量とリソース使用量を評価し、適切な方法を判断
- リソースの監視:CMCを使用して、リソース使用状況をリアルタイムで監視
- 移行計画策定:移行に必要なステップを計画し、必要なリソースを確保
- 移行の実施:計画に基づいて移行を実施し、リソースの最適化を実施
お客様の環境や使い方によって受けられるメリットは異なりますが、拡張を計画される時には是非ワークロードベース価格体系を検討いただき、Splunk投資の最適化にご活用ください。
次のステップ:Splunkの価値評価を行う
投資の最適化後は、Splunk投資の妥当性を論理的な根拠に基づいて評価することも重要です。お客様とSplunkが協働で、資源、リスク、収益、経費など様々な視点からSplunkの価値を試算することも可能です。是非ご検討ください。
関連記事
REMA 1000のダッシュボード開発におけるベストプラクティス:アクセスしやすいデータとエンドツーエンドの可視化で問題解決までの時間を短縮
構造化データ、非構造化データ、半構造化データ