計装のオーバーヘッドはどこにあるのか:ISUCON14で測るOpenTelemetryの無効化戦略
Observability 大谷 和紀ISUCON は、お題となる Web サービスを、決められたルールの中で限界まで高速化するチューニングコンテストです。
これまでの記事では、ISUCON14 の Go 参考実装に OpenTelemetry の計装を入れ、何が見えるようになるかを紹介してきました。前回の「ISUCON を解いて考える、AI 時代のオブザーバビリティ活用」では、計装そのものにも CPU やメモリーの負荷がかかるため、最終スコアを測るときは計装を外すのがおすすめ、と書きました。
では、その負荷はどこにあるのでしょうか。「SDK を無効にすれば実質ゼロ」「サンプリング率を下げれば軽くなる」とよく言われますが、本当にそうなのでしょうか。本記事では、計装が内部でどう動いているかを分解し、計装による CPU、メモリー、ネットワークのオーバーヘッド(以下、オーバーヘッド)がどこで生まれるのかを考えます。
本記事で扱う範囲
本記事で扱う範囲は次のとおりです。
- 対象:Go の計装ライブラリ(otelhttp、otelsql)と OpenTelemetry Go SDK による、アプリ側のオーバーヘッド
- 対象外:Collector 側のオーバーヘッド、他言語での計測
本文中の数字は、ISUCON14 の Go 参考実装を、MySQL と同じ 2 vCPU のホストで動かして測ったものです。スコアは各条件 5 回の中央値です。CPU 時間とメモリー割り当ては、ベンチマーク中の 50 秒間のプロファイルから取りました。これらの数字は、環境とパフォーマンスチューニングの進み具合に強く依存します。見ていただきたいのは絶対値ではなく、どの層が減って、どの層が残るかです。また、インスタンスを起動し直すとベースラインも動くため、比較は同じ表の中だけで行ってください。
計装はどう動いているか
アプリからテレメトリーが出ていくまでには、いくつかの部品を通ります。
- 計装ライブラリ:otelhttp や otelsql のように、HTTP ハンドラーや DB ドライバーを包んで、処理の前後で API を呼びます
- API:スパンを開始する、メトリクスを記録する、といった呼び出し口です。SDK がなければ、何もしない実装(noop)が動きます
- SDK:API の実体です。サンプリングを判定し、スパンやメトリクスをデータとして持ちます
- エクスポーター:SDK が持っているデータをまとめて、Collector やバックエンドに送ります
これらの処理は、性質の違う 3 つの層に分けられます。
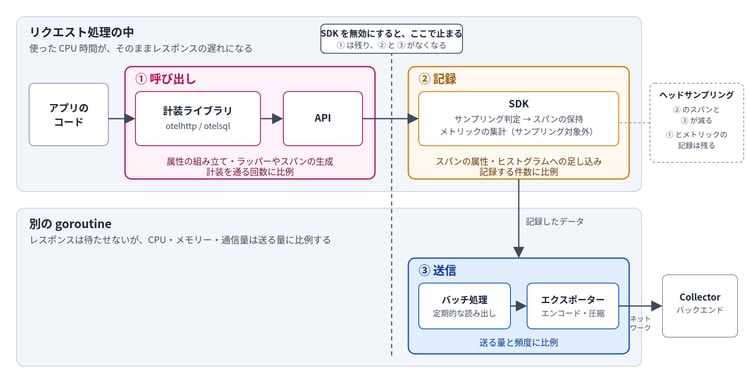
計装の 3 つの層。リクエスト処理の中で動く「呼び出し」と「記録」、別の goroutine で動く「送信」
図 1:計装の 3 つの層
- 呼び出し:計装ライブラリが API を呼ぶ前後の処理です。属性の組み立て、ラッパーやスパンの生成などで、計装を通る回数に比例します
- 記録:SDK がデータとして持つ処理です。サンプリングの判定、スパンの属性の保持、メトリクスの集計などで、記録する件数に比例します
- 送信:記録したデータをまとめて送る処理です。バッチ処理、エンコード、圧縮、ネットワークへの書き出しで、送る量と頻度に比例します
ポイントは、どこで動くかです。呼び出しと記録はリクエスト処理の中で動くので、使った CPU 時間がそのままレスポンスの遅れになります。送信は別の goroutine で動くので、レスポンスを直接は待たせません。
よく使われる手段がどの層を減らすかを並べると、次のようになります。
SDK の無効化もサンプリングも、レイテンシーに直接効く「呼び出し」の層には手を付けません。以降で、層ごとに見ていきます。
呼び出しのオーバーヘッド
何が起きているか
計装ライブラリは、API を呼ぶ前に準備をします。otelhttp は、リクエストごとにレスポンスのラッパーや属性を作ります。otelsql は、DB を呼ぶたびにスパン用とメトリクス用の属性を組み立てます。計装ライブラリに渡した属性取得の処理(今回は SQL 文の解析)も、毎回呼ばれます。
この準備は、記録先が noop でも、サンプリングで落とされるスパンでも省かれません。属性の組み立てにはメモリー割り当てが伴うので、GC も増えます。
SDK を無効にしても残る
SDK を無効にしても、CPU 時間は 8.69 秒から 11.90 秒に増え、メモリー割り当ては約 4 倍になりました。GC の CPU 時間も 0.23 秒から 1.06 秒に増えています。計装ライブラリでラップしなければ、どちらもほぼ計装なしの水準に戻ります。noop そのものは呼ばれてもすぐに返るので、オーバーヘッドはほぼありません。残っているのは、計装ライブラリの準備の分です。
前回の記事で「環境変数で送信を止めてもミドルウェアの呼び出し自体は残る」と書いたのは、この状態のことです。
サンプリング率を下げても残る
SDK を有効にして、すべてのトレースを記録した場合と、10% だけ記録した場合を比べます。インスタンスを起動し直して測ったため、計装なしの値は前の表と異なります。
10% のサンプリングで、送るスパンは 1/10 になりました。減ったのは送信処理の CPU 時間で、1.88 秒から 0.20 秒になっています。一方、リクエスト処理中の CPU 時間は 6.41 秒から 6.20 秒までしか減っていません。サンプリングが減らすのは記録と送信で、呼び出しはそのまま残るからです。スコアがほとんど変わらないのも、これが理由です。
減らし方
- 無効にするなら、計装ライブラリでラップしない:無効のときは otelhttp と otelsql で包まず、計装用のミドルウェアも登録しないようにします。上の表のとおり、計装なしとほぼ同じに戻ります
var handler http.Handler = setup()
if otelEnabled {
    handler = otelhttp.NewHandler(handler, "server")
}
- 計装する対象を絞る:ヘルスチェックやポーリングなど、高頻度で情報の少ないエンドポイントは、otelhttp の WithFilter で計装から外します。呼び出しのオーバーヘッドは計装を通る回数に比例するので、回数の多いものから外すのが効きます
- 子スパンは、親がサンプリングされているときだけ作る:親スパンの sampled フラグを見て、落とされるトレースでは子スパンの作成をスキップします。otelsql の場合には SpanFilter を使うこともできます
- 重い属性の計算はキャッシュするか、IsRecording で分岐する:スパンの開始後に span.IsRecording() を見れば、記録されないスパンでの計算を省けます
他の言語では
「記録しないスパンでは属性を組み立てない」ことは、仕様でも想定されています。Trace API の IsRecording の説明には、記録されないスパンで高価な属性計算を避けるために使う、と書かれています。実際に省くかどうかは、計装ライブラリによって異なります。
- .NET の HttpClient の計装は、activity.IsAllDataRequested を見て、サンプリングされたときだけ属性を足します
- Python の DB API の計装は、span.is_recording() で分岐します
- Java の計装基盤(Instrumenter)は、サンプラーに渡すために、スパンの開始前に属性を組み立てます。同じ属性をメトリクスでも使い回します
- 今回の Go の otelhttp と otelsql は、分岐していません
スパンの開始時に属性を渡すとサンプラーの判定に使える一方で、落とすスパンでも組み立てのオーバーヘッドを払うことになります。また、この分岐で省けるのはスパンだけです。メトリクスは、スパンのサンプリングに関係なく、記録のたびに属性を組み立てます。
記録のオーバーヘッド
スパンは、サンプリングされるものだけを作ったり、属性を計算したりするように工夫できます。しかし、メトリクスの記録は事情が異なります。メトリクスはサンプリングの対象外なので、呼び出しのたびに、属性の組み合わせごとのヒストグラムやカウンターに値を足し込みます。
メトリクスの二重記録を解消する
今回いちばん大きかったのは、otelsql のメトリクスの記録でした。DB を呼ぶたびに走るうえに、二重に記録していたためです。
これはセマンティック規約の移行の名残です。データベースのセマンティック規約は安定版が定まり、メトリクス名や属性名が変わりました。それ以前の命名規約で作られた既存のダッシュボードが壊れないように、移行期間には OTEL_SEMCONV_STABILITY_OPT_IN=database/dup で、旧形式(db.sql.latency)と新形式(db.client.operation.duration)の両方を出せるようになっています。今回の計装はこの設定になっていたため、記録のオーバーヘッドも二重にかかっていました。
他にもいくつか軽量化の設定を入れて、それぞれが減らした分をプロファイルの差から見積もると、次のようになります。
- セマンティック規約の dup をやめる:旧形式に依存したダッシュボードがなければ、OTEL_SEMCONV_STABILITY_OPT_IN=database で新形式だけを出すようにします
- メトリクスのカーディナリティーを抑える:ユーザー ID や生の URL を属性に入れると、系列の数が膨らみ、記録も集計も重くなります
- 不要なら Exemplar を止める:OTEL_METRICS_EXEMPLAR_FILTER=always_off で止められます
送信のオーバーヘッド
スパンは、SDK のバッチ処理がまとめてエクスポーターに渡します。メトリクスは、一定の間隔で集計結果を読み出して送ります。どちらもリクエストとは別の goroutine で、エンコード、圧縮、ネットワークへの書き出しを行います。それらの送信はレスポンスを待たせませんが、CPU を使わないわけではありません。
今回の計測範囲では MySQL がボトルネックだったため、この分はスコアにあまり出ませんでした。しかし、アプリ自体が CPU のボトルネックになっている場合や、コンテナに CPU の上限がある場合は話が変わります。たとえば Kubernetes の CPU limits では、送信に使った CPU も上限に含まれ、上限に当たるとリクエスト処理も止められます。送信用のメモリー割り当ても GC を通じて、リクエスト処理に間接的に効きます。
メトリクスの出力間隔も、送信のオーバーヘッドに関わります。たとえば 1 秒ごとに出すと、集計の読み出しでメモリー割り当てが増えます。仕様の既定値は 60 秒で、今回の軽量化では 15 秒にしました。
他にもネットワーク帯域を使いますが、こちらはそれほど目立った負荷にはなりません。気になった方は計測してみてください。
- 送る量はヘッドサンプリングで抑える:送信のオーバーヘッドは量に比例するので、いちばん効くのはサンプリングです
- テイルサンプリングでは、アプリ側は減らない:Collector 側のテイルサンプリングは、エラーや遅いトレースを確実に残せるのが利点です。ただし、アプリはすべてのスパンを送るので、アプリ側の記録と送信のオーバーヘッドはそのまま残ります
- 転送料金が気になるなら gzip:CPU と引き換えに、通信量を大きく減らせます
- 送信先の詰まりに備える:Collector が遅い、または止まっているときは、キューの滞留や再送で CPU とメモリーが増えます。キューの上限を決めて、溢れたら捨てる設定にしておくと安全です
3 つの層をまとめて減らすと
ここまでの設定を組み合わせると、どこまで戻るのでしょうか。
送ったスパンが 130 分の 1 になっているのは、サンプリングに加えて、ポーリング系のエンドポイントを計装から外し、Prepare のスパンを止めたためです。リクエスト処理中の CPU 時間は、計装なしに近いところまで戻りました。それでもわずかに残ります。ISUCON の競技中に、この差をどう見るかはポイントかもしれません。
ISUCON と本番のアプリケーションでは何が違うか
今回の環境は、オーバーヘッドが大きく出る条件です。
- 1 リクエストの処理が軽く、1 リクエストあたりの DB 呼び出しが多い。呼び出しの層のオーバーヘッドは回数に比例するので、比率が大きくなります
- ポーリング系のエンドポイントが、リクエストの大半を占めます
- 2 vCPU で MySQL が CPU を使い切っており、余裕がありません
本番の多くのアプリケーションでは、ネットワークの待ちや 1 リクエストあたりの処理の重さが占める割合が大きくなります。-20% のような数字にはなりにくいでしょう。今回の数字は、上限に近い値として読んでください。
一方、本番ではメトリクスのカーディナリティー、コンテナの CPU の上限、送信先の詰まり、転送料金といった、量と運用に起因する問題のほうが顕在化しがちです。このうち送信量や転送料金にはサンプリングが、メトリクスのカーディナリティーには属性の見直しが効きます。
ISUCON で最終スコアを測るときに計装を外す、という使い分けは変わりません。本番では計装を外すのではなく、層ごとに調整して減らして、常に観測できる状態を保つのがベストプラクティスです。
まとめ
本記事では、計装を「呼び出し」「記録」「送信」の 3 つの層に分け、それぞれのオーバーヘッドを ISUCON14 の Go 参考実装で確かめました。
- 呼び出しのオーバーヘッドは、SDK を無効にしても、サンプリング率を下げても残ります。リクエスト処理の中で動くので、レイテンシーに直接効きます。無効にするなら計装ライブラリでラップしないこと、有効にするなら計装する対象を絞ることが効きます
- 記録のオーバーヘッドでは、メトリクスに注意が必要です。サンプリングの対象外で、呼び出しのたびに記録されます。セマンティック規約の二重記録をやめるのが、今回いちばん効きました
- 送信のオーバーヘッドは、レスポンスを直接は待たせませんが、CPU とメモリーと通信量は送る量に比例します。量を抑えるのはヘッドサンプリング、通信量を抑えるのは gzip です
- オーバーヘッドの大きさは、計装ライブラリの実装と設定、計装を通る回数で決まります。1 リクエストあたり計装を何回通るかで当たりを付け、最後はプロファイルで確かめてください
プロファイルについては今回は詳しく解説していませんが、Go なら pprof で、計装ライブラリのパッケージに絞って CPU 時間とメモリー割り当てを見ると、どこに効いているかがわかります。Java、.NET、Node.js、Python(CPU のみのベータ版)では、Splunk Observability Cloud の AlwaysOn Profiling を使えば、本番環境でも継続的にプロファイルを取れます。
計装は、入れて終わりではなく、測って調整するものです。ぜひ手元のアプリケーションでも測ってみてください!
次のステップ
- Splunk Observability Cloud Free Edition は、15 ホストまでクレジットカードなしで登録できます。機能とユーザー数の制限はありません。
- これまでの記事:「Splunk OpenTelemetry Collector でホスト、NGINX、MySQL を可視化」、「Splunk Observability Studio で Go アプリケーションを効率よく計装する」、「ISUCON を解いて考える、AI 時代のオブザーバビリティ活用」
- 計装の実装は otelhttp と XSAM/otelsql のドキュメントで確認できます。
関連記事
信頼性とは?知っておくべき信頼性メトリクス
Universal ForwarderとOpenTelemetry Collectorの統合:Splunk Add-On for OpenTelemetry Collector