ISUCONを解いて考える、AI時代のオブザーバビリティ活用
Observability 山村 悟史昨今、AIを使ってアプリの解析や改修を進める場面が増えています。一方でAIが調べるだけで十分なのか、オブザーバビリティを用意する意味はどこにあるのか、という疑問もあるのではないでしょうか。
この記事ではISUCON14に対してAIで調査、改修を行い、Splunk Observability Cloudで何が見えたかを解説します。あわせて実際に計装して試した結果とその計装をAIに任せるポイントをご紹介します。
ISUCONとは?
ISUCON(Iikanjini Speed Up CONtest)は、お題として与えられたWebアプリを決められた時間内に高速化してスコアを競うコンテストです。
高速化の対象はアプリのコードだけではありません。データベース、Webサーバー、ミドルウェア、OSの構成まであらゆる箇所が対象になります。そのため、どこが遅いのかを素早く正確に特定できることがスコアに直結します。
過去のISUCONでのボトルネック傾向
過去の出題を振り返ると、ボトルネックになる箇所はいくつかのパターンに分かれます。
-
データベース関係
- インデックス不足:検索に使うインデックスがほとんど無い状態から始まる
- N+1:1つの処理の中で同じSELECTが件数分繰り返される
- 全件集計:一部取得でよいようなテーブルを毎回全件集計している
- 採番のロック待ち:IDの採番がDBのロックで詰まる
-
アプリケーション関係
- 呼ばれすぎ:1回は短い処理がポーリングで大量に呼ばれる
- 外部APIの遅さ:決済や配送のAPIの待ちがトランザクションの中で発生する
-
インフラ関係
- アプリ以外のプロセスがCPUを使う:DNSサーバーなどアプリの外にあるプロセスが負荷の原因になる
- OSやミドルウェアの設定:コネクション追跡の溢れ、静的ファイルの配信など
注目したいのは、これらが「アプリのコードだけを見ていても分からない」ものを多く含むことです。プロセスの外側、DBの内側、ネットワーク、外部APIなど複数の層にまたがっています。
オブザーバビリティで何が見えるか
Splunk Observability Cloudはフロントエンドからバックエンド、インフラまでをトレース、メトリクス、ログでつなげて可視化します。ISUCONの詰まりどころに当てはめると、次のように見えます。
ポイントは、これらが別々の画面ではなくつながっていることです。例えば「アプリが遅い」ときにトレースで遅い処理を特定し、同じ時間帯のホストやDBのメトリクスを重ねて原因が絞れます。過去のISUCONで言えば、アプリ外のプロセスがCPUを使っていたケースはアプリのトレースだけでは見えません。プロセスのCPUと並べてはじめて分かります。
ISUCON14で試してみた
ISUCON14で使用されたアプリ及び問題はこちらから利用できます。
ISUCON14の構成はこのようなものでした。
- OS:Ubuntu 24.04
- Webサーバー:nginx(HTTPSを受けてアプリへ転送)
- アプリ:初期状態はGoの実装がsystemdで動作(リファレンス実装は7言語)
- DB:MySQL 8.0
- 外部サービス:決済ゲートウェイ(ベンチマーカーが模擬)
椅子のライドシェアを模擬したアプリケーションで、いかに処理を高速化しユーザー満足度を維持するか、を競うものとなっています。
公式の本戦とは条件が異なりますがサーバーはアプリ1台で立ち上げ、実際にGoの実装を計装してSplunk Observability Cloudで見てみました。
なお、計装およびコード改修はコーディングエージェント(Cursor)を使用しています。
計装をAIに任せる
今回、AIと一緒に次の作業を進めています。
AIにプロンプトで対象ホストの情報やSplunk Observability Cloudの接続先情報などを与え、計装は全てお任せしました(アクセストークンの管理については環境変数にして渡すなどしてご注意ください)。
- OpenTelemetry Collectorの設定:ホスト、MySQL、nginxのメトリクスの取得
- Goの手動計装:HTTPのルート別トレース、SQLのスパン、DB接続プールの指標。計装の書き方はObservability StudioのGo向けガイド・Skillを使用しました
Goについて補足すると、アプリケーションレイヤーのオブザーバビリティを始めるにはデータを取る準備(計装)が必要です。計装は大きく自動計装と手動計装に分かれます。
- 自動計装:コードを変更せず、起動オプションなどでエージェントを指定して標準的なトレースを取得
- 手動計装:SDKやAPIを使い、コードに直接トレースを取得する処理を追加
- 自動と手動の併用:自動計装をしつつ必要な箇所に追加
一般的にはJava、Python、Node.jsのように起動時にエージェントをアタッチできる言語であれば、まず自動計装を試し、必要に応じてコードに手を入れるのが手軽です。一方でGoは単一の静的バイナリーにコンパイルされるためアタッチする先がありません。選択肢は次の3つです。
- 計装ライブラリ:使っているライブラリに対応する計装ライブラリを組み込み、足りない部分は手動計装で補う
- コンパイル時計装(otelc):ビルド時にコードを注入する
- eBPF:アプリのコードを変更せずに取得する
今回は計装ライブラリと手動計装を使いました。ISUCONのような詳細な調査が必要な場面では取りたい粒度に合わせて手動で補える点も利点です。
インフラ、ミドルウェアのメトリクスについては、ブログ「Splunk OpenTelemetry Collectorでホスト、NGINX、MySQLを可視化」で詳しく解説しています。
Goへの計装、Observability Studioについては、ブログ「Splunk Observability StudioでGoアプリケーションを効率よく計装する」で詳しく解説しています。
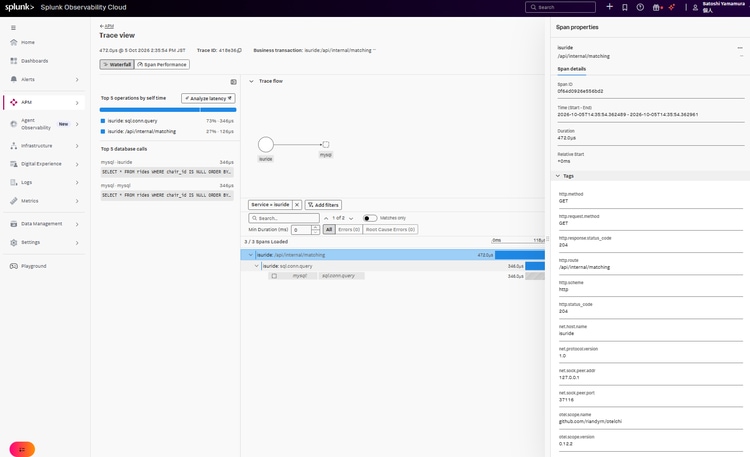
無事計装完了
計装の結果見えたもの
以下は筆者の環境での検証です。
データベースのIndexがされていない、N+1問題の対処といった基本的なボトルネックの他に、トレースを見ると次の3か所で原因が確認できました。
1. 評価の処理が決済APIの待ちの間、接続を持っていた
評価のトレースの大半は、外部の決済APIの待ち時間でした。最も遅いSQLでも約9msで、SQLを速くしても効果がありません。読み取りのトランザクションが決済APIを待つ間ずっと接続を持っていることがトレースから読み取れます。
トランザクションを決済の前に閉じるように直したところ、53192点が56925点になりました。この改修は公式の解説には書かれていなかったポイントです。
2. 座標の応答がDBの書き込みを待っていた
ライドシェア対象の椅子の座標を送るAPIのトレースは約297msで、時間の大半はINSERTと状態の更新でした。座標の応答が遅れると、椅子が次の移動を始めることができません。
3. 通知のトレースは長いがSQLは速かった
通知のトレースは約487msでMySQLのスパンが約18本並列に並んでいました。中心となるCOUNTのSQL自体は0.27msで、これ自体がボトルネックではありません。時間を使っていたのはDBの接続プールの待ちでした。SQLの文だけを見ているとCOUNTを疑ってしまいます。トレースとDB接続プールの指標を合わせて見ることで、原因が接続の待ちだと確認できます。
その他にもインフラのメトリクスなども参照しつつコード改修を行っていきました。
なお、Splunk Observability Cloud向けのMCPサーバーを使うと、AIがオブザーバビリティのデータを直接参照できます。例えば「前回の走行と今回の走行で、エラー率が増えたAPIはどれか」とAIに尋ねて、オブザーバビリティのデータから答えてもらう、といった使い方ができるようになります。
参考:Splunk MCP Server for Splunk Observability Tools の設定
結果として、初回は903点で最終的に59657点まで進みました(これはほとんどAIの成果です)。
なぜオブザーバビリティか
AIによる直接取得との違い
AIに「いま何が遅い?」と聞いて、サーバー上のログやプロセス、スロークエリ、実行計画をその場で取ってもらうのはとても速い方法です。思いついたらすぐ聞けるため個人で進めるときには非常に便利です。
もしかすると、AIが直接取得できるならオブザーバビリティは要らないのではと思われるかもしれません。確かに1人で取りに行ける範囲の情報であればそれで足ります。
一方でオブザーバビリティには別の価値があります。
ISUCONはチーム戦です。誰かが「DBが重い」と言い、別の人が「アプリのCPUが高い」と言うといったすれ違いが起こりがちです。同じ画面で同じデータを見ていれば次に何を直すかの議論が速くなります。
また、変更の前後のデータがそのまま残るのもオブザーバビリティの良いところです。「この改修で何がどう変わったのか」をトレースやメトリクスというエビデンスで示せます。AIの速さとオブザーバビリティの共有性はどちらかを選ぶものではなく組み合わせて使うものだと思います。
今後のISUCONでは全体像と依存関係が必要になるかもしれない
ここからは筆者の推測です。
これまでのISUCONのアプリはnginx、アプリ、MySQLといった、どちらかというとモノリシックな構成が中心でした。一部の回ではアプリ外のDNSサーバーや内部のマッチング処理、外部APIが登場しましたが、アプリ本体は1つのプロセスでコードを読めば全体を把握できる規模でした。
昨今のアプリケーションのアーキテクチャを考えると、今後はもう少し複雑な構成のアプリが出題されるかもしれません。例えば複数のサービスに分かれたアプリ、サービス間の非同期のやりとり、キューやキャッシュ、複数の外部サービスの組み合わせなどです。
そうなるとコードを読むだけでは次のようなことを把握するのが難しくなります。
- どのサービスがどのサービスを呼んでいるか(依存関係)
- 1つのリクエストがどこを通りどこで時間を使っているか(全体像)
- 負荷をかけたときどのサービスが先に詰まるか
こういったものについて、実際に動かしたときのトレースとそこから自動生成されるサービスマップで一目で見られるようになります。AIにコードを読ませることも有効ですが、実行時の呼び出し関係と待ち時間はオブザーバビリティのデータで確認する方が確実です。さらに、チーム全員が同じサービスマップを見ながらどこを直すかを相談できます。
アプリが複雑になったとき、全体像と依存関係を見るための手段が必要になります。オブザーバビリティはそのための手段として有効です。
補足:計装にもコストがかかる
一点、注意が必要なことがあります。それは、計装そのものにもCPUやメモリの負荷がかかるということです。
ISUCON14ではSQL、ランタイム、決済APIのスパンを常時入れた状態でスコアを測ったところ56925点が50412点に下がりました。筆者の環境ではギリギリのスペックで動かしていたせいか、CPUが高騰していました。
ISUCONのようにスコアを最優先する場面では次のように使い分けるのがおすすめです。
- 調査のとき:計装を入れ、Collectorも起動して原因を調べる
- 最終スコアを測るとき:計装なしでビルドし直し、Collectorも停止する
環境変数で送信を止めてもミドルウェアの呼び出し自体は残ります。Database Monitoringのクエリサンプルの取得もDBへの問い合わせとPerformance Schemaの有効化を伴うため、同じように外すのが安心です。最後の最後にスコアを測る際は計装を全部外すと良いでしょう。
ただしこれはISUCONのような特殊な状況でのみに言えることで、本番環境では常に観測できるようにしましょう!
まとめ
本記事では過去のISUCONで詰まりやすかった箇所を整理し、Splunk Observability Cloudで何が見えるか、ISUCON14で実際に試した結果とあわせて解説しました。
まとめとして、オブザーバビリティにより次のようなメリットが得られます。
- 層をまたいだ原因の特定:アプリのトレース、DBの接続や実行計画、ホストのCPUを同じ時間軸で見られるため、アプリだけでは見えない原因も調査できる
- チームでの状況把握と変更の前後のエビデンス:AIの直接取得は速く、オブザーバビリティは全員が同じ画面を見られ、変更の前後のデータも残る。両方を組み合わせて使うべき
- 全体像と依存関係の把握:アプリが複雑になっても、トレースとサービスマップで、呼び出し関係と待ち時間を確認できる
- 計装の立ち上げ:Goのように手動計装が必要な場合でも、AIと進めることで負担を下げられる
AIによる計装とオブザーバビリティの活用をぜひお試しください!
次のステップ
- Splunk Observability Cloud Free Editionは、15ホストまでクレジットカードなしで登録できます。機能とユーザー数の制限はありません。
- 10/22開催予定のウェビナー「計装して、測って、外す。ISUCONの過去問で学ぶOpenTelemetryの実践」では、Goアプリの計装からボトルネックの特定までをライブで実演します。ぜひご参加ください。
関連記事
NoOpsの基本:NoOpsとDevOpsとの比較
外形監視とは?