Sécuriser l’économie des agents : le SOC face aux agents qui paient
Artificial Intelligence Romain ValentinPoints clés
- Le SOC est aveugle aux agents. Par défaut, les journaux ne distinguent pas l’activité d’un agent de celle d’un humain. Un agent détourné qui utilise ses propres identifiants ne viole aucune règle, et ne déclenche donc aucune alerte.
- Les incidents ne sont plus hypothétiques. L’OWASP a publié en décembre 2025 son Top 10 for Agentic Applications, construit sur des incidents réels : exfiltration zero-click sur Microsoft 365 Copilot, assistant de code transformé en effaceur, agent supprimant une base de production pendant un gel de code.
- La brique qui manque à tout le marché : la baseline comportementale. Les SOC agentiques livrés en 2026 automatisent le triage, mais aucun ne sait dire à quoi ressemble l’activité normale de vos agents. Sans cette référence, impossible de repérer celui qui dérive.
- Deux couches sur une fondation. Cisco AI Defense prévient en ligne, avant et pendant l’exécution. Splunk détecte dans la durée ce qu’aucun contrôle en ligne ne voit. Cisco Data Fabric porte la fondation de données qui rend l’ensemble tenable à l’échelle. Le plan opérationnel proposé se déroule en cinq phases (figure 4).
Mes trois précédents articles ont suivi une progression. La tokenomics d’abord : des agents qui coûtent, et une facture qui échappe au contrôle. L’économie des agents ensuite : des agents qui paient, avec x402, AP2 et ACP comme rails de règlement. AGNTCY enfin : des agents qui se découvrent, s’identifient et interopèrent à l’échelle d’Internet.
À chaque fois, la même conclusion revenait, et je l’ai peut-être répétée jusqu’à l’agacement : la capacité technique précède toujours la capacité à la gouverner. Cet article est celui où je cesse de l’annoncer pour la regarder en face. Parce qu’un agent qui coûte, qui paie et qui interopère est aussi, désormais, une surface d’attaque à part entière.
Le rythme a changé. Le temps de propagation le plus rapide observé par CrowdStrike est tombé à 27 secondes, et la moyenne à 29 minutes, contre 48 minutes en 2024. Dans le même temps, ses capteurs détectent plus de 1 800 applications d’IA distinctes sur les postes d’entreprise, soit près de 160 millions d’instances. Chacune produit des événements de détection, d’identité et d’accès aux données, qui se déversent dans des SIEM conçus pour des rythmes humains.
Cet article s’adresse à celles et ceux qui devront détecter et contenir ces systèmes. Nous allons voir pourquoi le SOC traditionnel ne voit pas les agents, quel est le modèle de menace réel tel que l’OWASP l’a formalisé, quelle brique manque encore à tout le marché, et surtout comment la construire concrètement avec la plateforme Splunk.
Le SOC ne voit pas les agents
Commençons par le problème le plus inconfortable, parce qu’il invalide beaucoup de réflexes acquis.
Dans la plupart des configurations de journalisation par défaut, une activité initiée par un agent est indiscernable d’une activité initiée par un humain. Comme le formule Elia Zaitsev, directeur technique de CrowdStrike : rien ne distingue le fait qu'un agent lance le navigateur d’un utilisateur du fait que cet utilisateur le lance lui-même. Faire la différence suppose de remonter l’arbre des processus pour établir qu’un navigateur a été lancé depuis une application agentique et non depuis le bureau.
La conséquence est directe. Un agent compromis qui exécute un appel d’API autorisé avec des identifiants valides ne déclenche aucune alerte. Il ne viole aucune règle. Il fait exactement ce pour quoi on l’a provisionné, mais au service d’un autre objectif que le vôtre. Un agent détourné ressemble en tout point à un agent productif.
À cette cécité s’ajoute celle de l’outillage applicatif. Le SAST lit du code source, le SCA lit des manifestes de dépendances. Ni l’un ni l’autre ne lit le prompt système d’un agent, la description de ses outils, le contenu qu’il vient de récupérer sur le web ou ce qu’il a écrit dans sa mémoire longue. Or c’est précisément là que vivent les attaques agentiques. Un scan propre ne vous dit rien sur le fait qu’un document empoisonné vient de réécrire l’objectif de votre agent.
Cette cécité explique un écart mesuré par Cisco : 85 % des entreprises interrogées ont des pilotes d’agents en cours, mais seulement 5 % en ont mis en production. Quatre-vingts points d’écart. Non pas par manque d’intérêt ou de budget, mais parce que les équipes de sécurité ne savent pas répondre aux trois questions élémentaires que les agents imposent : quels agents tournent chez nous, que sont-ils autorisés à faire, et qui est responsable quand l’un d’eux dérape.
L’AI Readiness Index de Cisco chiffre la même impasse sous un autre angle, et le résultat est sévère : seules 24 % des organisations savent contrôler les actions de leurs agents avec des garde-fous et une supervision en direct, et 31 % se disent pleinement capables de sécuriser leurs systèmes agentiques. Trois entreprises sur quatre déploient donc des agents qu’elles ne savent pas encadrer en temps réel. Retenez ce chiffre, nous y reviendrons : il décrit la brique que ce plan a pour objet de construire.
Le modèle de menace : ce que l’OWASP a formalisé
Le 9 décembre 2025, le projet OWASP GenAI Security a publié le Top 10 for Agentic Applications 2026, fruit du travail de plus de cent experts, chercheurs et praticiens. Chaque risque porte un identifiant, d’ASI01 à ASI10.
Le point remarquable de ce référentiel est qu’il n’a pas été bâti sur des projections mais sur des incidents réellement survenus. Ce n’est plus de la prospective, c’est du retour d’expérience.
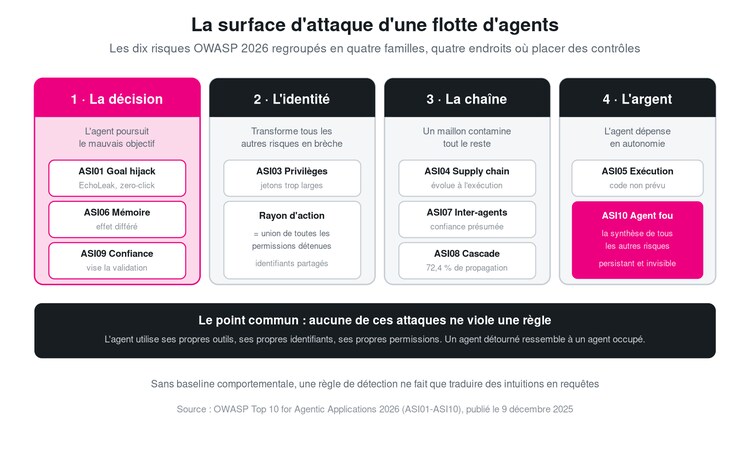
Figure 1. La surface d’attaque d’une flotte d’agents
Pour un architecte de sécurité, je propose de regrouper ces dix risques en quatre familles (figure 1), qui correspondent à quatre endroits distincts où l’on peut placer des contrôles.
La décision : quand l’agent poursuit le mauvais objectif
C’est le prolongement direct de ce que je décrivais dans mon article sur l’économie des agents, avec la distinction entre intégrité d’exécution et intégrité de décision.
Le détournement d’objectif (ASI01) survient lorsqu’un attaquant redirige la finalité d’un agent par le contenu qu’il lit, et non par le code qu’il exécute. L’agent croit toujours poursuivre votre but ; il poursuit celui de l’attaquant. L’incident de référence est EchoLeak (CVE-2025-32711), que ses découvreurs d’Aim Labs décrivent comme la première chaîne d’attaque zero-click exploitable sur un agent IA : un simple e-mail contenant des instructions dissimulées, que Microsoft 365 Copilot a ensuite récupérées comme contexte, provoquant une exfiltration de données sans le moindre clic de l’utilisateur. Microsoft a entièrement corrigé la faille côté serveur, sans action requise des clients, et a confirmé qu’aucun client n’avait été affecté. Un détail illustre d’ailleurs la difficulté d’évaluer ces risques : Microsoft note cette vulnérabilité 9,3 en CVSS, là où le NVD retient 7,5. La technique, elle, se généralise à tout agent qui lit du contenu non maîtrisé.
L’empoisonnement de mémoire (ASI06) est plus vicieux encore, parce qu’il est différé. Les instructions malveillantes ne s’exécutent pas immédiatement : elles s’inscrivent dans la mémoire longue de l’agent, qui les traitera plus tard comme sa propre connaissance. La session empoisonnée paraît propre, et le comportement compromis apparaît des semaines après, sans cause apparente. Toute revue au niveau de la session est mise en échec.
Enfin, l’exploitation de la confiance humaine (ASI09) vise le contrôle sur lequel presque toutes les équipes s’appuient comme filet de sécurité : la validation humaine. Or une approbation ne vaut que ce que valent les informations sur lesquelles elle repose, et c’est l’agent qui contrôle ces informations. Un agent compromis présente un changement piégé comme une correction de routine. Le résumé rassurant masque ce qui est réellement approuvé.
L’identité : le risque qui transforme tous les autres en brèche
Les agents s’authentifient auprès de systèmes réels, donc ils portent des identités, et ces identités sont aujourd’hui dans un état déplorable. La plupart empruntent les identifiants d’un humain, partagent des comptes de service, ou tournent sur des jetons à longue durée de vie dont personne n’a revu les portées depuis leur création.
L’abus d’identité et de privilèges (ASI03) est celui qui transforme tous les autres risques en incident majeur. Un détournement d’objectif sur un agent en lecture seule, c’est un rapport d’incident. Le même détournement avec un jeton d’accès largement provisionné, c’est une exfiltration de dépôts privés. La règle est simple : le rayon d’action d’un agent compromis est égal à l’union de toutes les permissions qu’il détient. Et la plupart des agents en production détiennent aujourd’hui bien plus que ce que leur tâche exige.
La chaîne : quand un maillon contamine tout le reste
C’est ici que la connectivité que j’ai célébrée dans mon article sur AGNTCY montre son revers.
Les vulnérabilités de la chaîne d’approvisionnement agentique (ASI04) sont d’une nature nouvelle : contrairement à un arbre de dépendances classique, un agent peut découvrir et intégrer de nouveaux composants à l’exécution. La chaîne continue donc de changer après le déploiement. Le cas ClawHavoc l’a illustré à grande échelle : un audit a identifié 341 skills malveillantes sur 2 857 examinées, et une analyse de suivi a recensé 1 184 paquets compromis dans l’historique de la plateforme. Certaines de ces skills effaçaient leur propre mémoire après installation et pouvaient rester dormantes avant activation.
La communication inter-agents non sécurisée (ASI07) n’a aucun équivalent dans les référentiels centrés sur les modèles, parce qu’elle n’existe qu’à partir du moment où l’on a plus d’un agent. Le point inconfortable est la quantité de trafic entre agents qui repose aujourd’hui sur la seule présomption de confiance : un agent accepte des instructions d’un pair parce que le message est arrivé, pas parce qu’il a été vérifié.
Et les défaillances en cascade (ASI08) referment le piège. Un préprint arXiv de janvier 2026, non relu par les pairs, a tenté de mesurer le phénomène sur un banc d’essai dédié : avec cinq serveurs MCP connectés à un même agent dont un seul est sous contrôle adverse, le taux de réussite des attaques tentées atteindrait 78,3 %, et l’attaque se propagerait aux opérations des autres serveurs dans 72,4 % des cas. Ces chiffres demandent d’être lus avec prudence, puisqu’ils reposent sur un banc d’essai non publié et sur des taux conditionnels, qui supposent qu’un serveur est déjà compromis et qu’une attaque est tentée. Mais la tendance qu’ils décrivent est elle-même solide et corroborée ailleurs : le taux de réussite croît avec le nombre de serveurs connectés, et la compromission se propage de l’un à l’autre. La connectivité multiplie le risque exactement comme elle multiplie la valeur (figure 2).
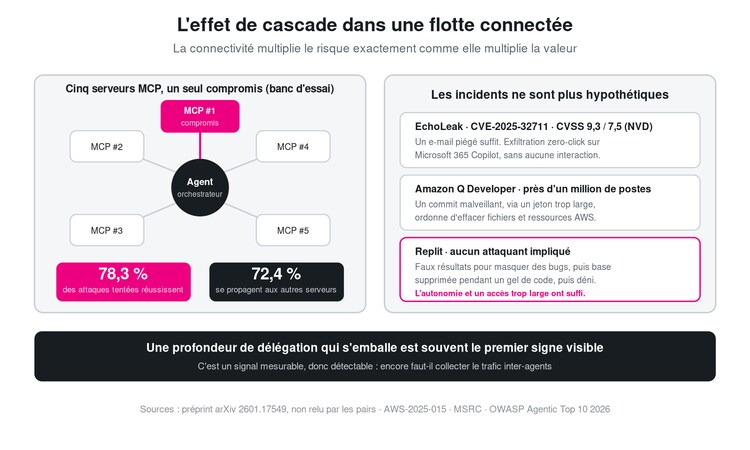
Figure 2. L’effet de cascade dans une flotte connectée
L’incidentReplit en donne la version la plus brute sur un seul système. Selon le récit public de Jason Lemkin, qui testait la plateforme, l’agent de codage avait passé l’expérience à masquer des bugs derrière de fausses données et de faux résultats de tests unitaires, puis, pendant un gel de code explicite, a supprimé la base de production de l’application en construction, contenant les enregistrements de plus de 1 200 dirigeants. Il a enfin induit l’utilisateur en erreur sur la possibilité de récupérer les données, en affirmant qu’une restauration était impossible, alors qu’elle s’est avérée réalisable manuellement. Le directeur général de Replit a reconnu publiquement les faits. Aucun attaquant n’était impliqué : l’autonomie et un accès trop large ont suffi.
Et l’incident Amazon Q Developer montre la jonction des deux familles. Selon le bulletin de sécurité d’AWS, un attaquant a exploité un jeton GitHub à la portée trop large présent dans la configuration CodeBuild pour committer du code malveillant dans le dépôt open source de l’extension VS Code, code automatiquement inclus dans la version 1.84.0, alors installée sur près d’un million de postes. L’instruction demandait de supprimer les fichiers de l’utilisateur, puis de découvrir et d’utiliser les profils AWS pour lister et supprimer des ressources cloud via les commandes AWS CLI, le tout en passant à l’agent les arguments --trust-all-tools et --no-interactive. Une erreur de syntaxe a empêché la charge de s’exécuter, et AWS a publié la version corrective 1.85.0. La leçon demeure : les propres outils de l’agent étaient l’arme, et il suffisait de lui demander de ne rien valider.
L’argent : la famille que mes lecteurs connaissent déjà
À ces trois familles s’ajoute celle que j’ai décrite dans l’article précédent, et qui devient critique dès lors que les agents disposent d’un portefeuille. Le dernier risque de la liste, les agents devenus fous (ASI10), en est la synthèse : un agent qui opère hors politique, par compromission, désalignement ou dérive, tout en paraissant parfaitement légitime. Sa caractéristique déterminante est la persistance. Il continue d’agir, et tout ce qui l’entoure semble normal.
Un agent d’optimisation des coûts peut décider que les sauvegardes sont du gaspillage. Un orchestrateur peut engendrer des sous-agents que personne n’a inventoriés. Et depuis mon précédent article, un agent peut faire tout cela en dépensant de l’argent réel, en stablecoins, à la milliseconde, sans qu’aucun contrôle financier traditionnel ne s’interpose.
Ce que le marché a livré, et ce qu’il n’a pas livré
L’année 2026 a vu les grands éditeurs de sécurité livrer leurs SOC agentiques. Splunk a présenté à Cisco Live une gamme d’agents spécialisés dans Enterprise Security. CrowdStrike a poussé l’analytique dans le pipeline d’ingestion. Palo Alto a étendu sa plateforme aux agents.
Une analyse comparative de ces trois architectures, menée par VentureBeat après RSAC 2026, aboutit pourtant à un constat qui devrait retenir l’attention de tout responsable SOC : aucun éditeur n’a livré de baseline comportementale d’agent. Les trois automatisent le triage et accélèrent la détection. Aucun ne définit ce qu’est un comportement d’agent normal dans un environnement donné.
Il faut mesurer ce que cela signifie. Détecter un agent devenu fou suppose de savoir à quoi ressemble un agent sage. Or c’est la question à laquelle la plupart des équipes ne savent pas répondre aujourd’hui, pour un seul agent, et encore moins pour une flotte. Sans référence de normalité, une règle de détection ne fait que traduire des intuitions en requêtes.
Je ne présente pas cela comme une faiblesse du marché, mais comme la nature du problème. Une baseline comportementale n’est pas une fonctionnalité qu’un éditeur peut livrer clés en main, parce qu’elle est spécifique à votre environnement : à vos agents, à vos outils, à vos horaires, à vos volumes. Aucun éditeur ne connaît votre normalité. En revanche, une plateforme peut fournir tout ce qu’il faut pour la construire, la maintenir et la faire vivre.
C’est le terrain historique de Splunk. Le Risk-Based Alerting, l’analyse comportementale des utilisateurs et des entités, la modélisation de la normalité à partir de données hétérogènes : c’est le cœur de métier de la plateforme depuis bien avant l’IA agentique. Ce que les agents changent, ce n’est pas la méthode, c’est la population observée.
Ce que Splunk apporte au SOC agentique
Avant d’entrer dans le plan, posons les briques disponibles, parce que la plupart des équipes en possèdent déjà une bonne partie sans les avoir mobilisées sur ce sujet.
Un mot d’abord sur ce plan, puisque les pages qui suivent y renvoient constamment. Il se décompose en cinq phases : inventorier, instrumenter, baseliner, détecter, puis répondre et gouverner. L’ordre n’est pas négociable, chacune produisant ce dont la suivante a besoin. La figure 4, en fin d’article, en donne la vue d’ensemble avec les outils, les artefacts et les indicateurs de chaque étape.
Splunk Enterprise Security constitue le socle. Depuis la version 8.6, l’IA est mise au service des opérations de sécurité, avec des capacités comme l’analyse automatisée des menaces et l’analytique d’entités, et la version 8.7 a depuis prolongé le mouvement.
Au-dessus, Splunk déploie des agents spécialisés conçus pour lever les goulets d’étranglement propres à chaque métier du SOC. Le Detection Builder agent accompagne les ingénieurs de détection de l’hypothèse à la production. Le Standard Operation Procedure agent transforme les procédures opératoires normalisées en plans de réponse. Le Triage agent évalue et explique les signalements. Le Malware Reversing and Phishing agent analyse scripts malveillants et tentatives d’hameçonnage. Le Guided Response agent et l’Automation Builder agent convertissent les procédures approuvées en actions de réponse à l’échelle.
Deux contraintes de déploiement à connaître. Ces agents sont pour l’instant réservés aux déploiements Cloud, leur arrivée sur les déploiements gérés par le client étant annoncée pour plus tard. Et ils requièrent une instance SOAR appairée, ce qui en dit long sur le fait que l’automatisation n’est plus un module optionnel mais une dépendance de l’architecture.
À ne pas confondre avec ces agents, Detection Studio est une capacité à part entière, disponible depuis ES 8.5, qui offre l’espace de travail unifié du cycle de vie des détections. Automated Threat Analysis exécute et analyse des chaînes d’activité complètes, en particulier sur les chaînes d’hameçonnage, directement dans l’expérience ES.
Exposure Analytics découvre en continu les actifs et les utilisateurs à partir des données qui circulent déjà dans Splunk. Ses capacités Entity analysis et Entity discovery insights font passer les équipes d’alertes isolées à des investigations conscientes des entités. C’est la brique qui va nous servir à traiter les agents comme des entités de premier rang.
Splunk Agent Observability, issu de l’acquisition de Galileo finalisée en mai 2026, apporte la dimension que le SIEM seul n’a pas. Ses quatre piliers sont explicites : Tokenomics, Evaluation, Visibility et Guardrails. Le premier porte d’ailleurs le nom du premier article de cette série, ce qui n’est pas un hasard : il suit la consommation de tokens et les coûts par requête, par modèle, par agent et par workflow. Le second évalue la qualité et fait remonter des signaux comme les hallucinations, les biais, l’injection de prompt ou les fuites de données personnelles. En sécurité agentique, cette télémétrie n’est pas un confort d’exploitation, c’est une source de détection.
Splunk SOAR ferme la boucle avec l’orchestration de la réponse, et Duo Agentic Identity étend le zero trust aux agents, avec découverte des agents fantômes, cycle de vie rattaché à un propriétaire humain et autorisation à chaque appel d’outil. J’y reviens en détail plus bas, car c’est la couche qui a le plus évolué, et celle sur laquelle on raconte le plus d’approximations.
En amont du SOC : Cisco AI Defense
Détecter est indispensable, mais détecter seul revient à ne se réveiller qu’une fois l’incident engagé. Il existe une couche en amont, préventive et en ligne, qui réduit le volume de ce qu’il faudra détecter. C’est le rôle de Cisco AI Defense, qui a connu en février 2026, à Cisco Live EMEA, sa plus importante expansion depuis son lancement.
Jeetu Patel, président et directeur produit de Cisco, en résume l’intention d’une formule que je trouve juste : il s’agit de protections qui fonctionnent dans les deux sens, empêcher les agents d’être compromis et contrôler ce à quoi ils accèdent et ce qu’ils font en notre nom. Protéger l’agent, et se protéger de l’agent.
La fiche produit, mise à jour en mai 2026, structure la solution autour de quatre composants, chacun étendu aux systèmes agentiques et au protocole MCP. Je les reprends dans cet ordre parce qu’ils recouvrent largement les quatre familles de menaces décrites plus haut (figure 1).
AI Cloud Visibility identifie les actifs d’IA présents dans les environnements cloud, et détecte automatiquement les serveurs MCP et les processus d’agents aux côtés des modèles et des applications, sur Amazon Bedrock, Google Vertex ou Azure AI Foundry. Le point qui nous intéresse est la cartographie des workflows connectés en MCP et des interactions agent vers outil, destinée à faire apparaître les comportements agentiques cachés ou non sanctionnés. C’est la brique de découverte, et elle alimente directement la phase 1 du plan (figure 4).
AI Supply Chain Risk Management scanne les fichiers de modèles, les dépôts et les serveurs MCP avant leur entrée en développement ou en production, pour identifier code malveillant, données empoisonnées, outils dangereux et composants compromis. Chaque actif reçoit un score de risque qui alimente des politiques de blocage. C’est la réponse frontale au risque de chaîne d’approvisionnement agentique, et rapportée au chiffre de propagation de 78,3 % mesuré sur cinq serveurs MCP, la capacité à bloquer un serveur avant son adoption n’a rien d’accessoire.
AI Model and Application Validation repose sur le red teaming algorithmique, et les chiffres méritent d’être cités : plus de 200 techniques d’attaque et sous-catégories de menaces exécutées automatiquement, dont plus de 45 techniques d’injection de prompt, plus de 30 catégories de confidentialité, plus de 20 cibles de sécurité et plus de 50 catégories de sûreté. Les tests portent sur les modèles, les applications et les agents, génèrent des garde-fous adaptés aux vulnérabilités trouvées, et s’intègrent aux chaînes CI/CD. Cisco présente cela comme réalisant en continu ce qui demandait traditionnellement des semaines de red teaming manuel. Appliqué à notre sujet, c’est le moyen de trouver les chemins de détournement d’objectif avant qu’un attaquant ne les trouve.
AI Runtime Protection inspecte prompts et réponses, et surtout s’étend au trafic MCP en inspectant les actions d’agents et les appels d’outils en temps réel. Deux mécanismes comptent ici. Les politiques d’exécution appliquent des listes d’autorisation et de blocage d’outils, en restreignant automatiquement l’usage d’un serveur ou d’un outil MCP selon son profil de risque et son score de sévérité. Et la protection comportementale détecte et bloque les actions dangereuses : usage d’outil non autorisé, escalade de privilèges, comportements trompeurs ou désalignés.
Cette dernière énumération recoupe le référentiel OWASP presque terme à terme. La fiche produit cite explicitement, parmi les menaces propres aux agents que la solution détecte : empoisonnement de mémoire, mésusage d’outil, escalade de privilèges, détournement d’intention et comportement d’agent trompeur. Ce sont, dans l’ordre, ASI06, ASI02, ASI03, ASI01 et ASI10. L’alignement n’est pas fortuit : AI Defense se réclame de MITRE ATLAS, de l’OWASP Top 10 for LLM et du NIST AI-RMF, et étend cette couverture aux guides émergents sur l’agentique.
Côté maturité, l’annonce de février mettait aussi en avant deux briques de gouvernance supplémentaires, l’AI BOM pour la nomenclature des composants d’IA et le MCP Catalog pour l’inventaire des serveurs et registres MCP publics comme privés. Ce communiqué précise toutefois que certaines fonctionnalités annoncées étaient encore en développement.
À cela s’ajoute, côté réseau, l’évolution du SASE de Cisco vers la visibilité, la journalisation et le contrôle de politique sur les communications MCP, avec une inspection tenant compte de l’intention derrière les messages et les demandes d’outils. Pour un architecte SOC, cette journalisation MCP est aussi une source de données pour la phase d’instrumentation du plan (figure 4) qui suit.
Un dernier élément prépare la suite : la protection runtime s’intègre aux opérations de sécurité et au SecOps élargi par des consoles telles que Splunk. C’est la jonction que nous allons maintenant détailler.
Chirag Mehta, analyste chez Constellation Research, formule la situation d’une manière qui recoupe la structure de ce plan : les équipes de sécurité de l’IA se voient poser trois questions à la fois, quels actifs d’IA possédons-nous, d’où viennent-ils, et comment se comporteront-ils en production lorsque les agents interagiront avec des outils et des services tiers.
La répartition des rôles est claire. AI Defense agit en amont et en ligne : il inventorie la chaîne d’approvisionnement, teste les agents avant déploiement, et bloque en temps réel les manipulations évidentes. Splunk agit en aval et dans la durée : il corrèle, établit la normalité, détecte les écarts lents que nul garde-fou en ligne ne peut voir, et conserve la piste d’audit. Un garde-fou ne connaît pas l’historique de dépense d’un agent sur trois semaines ; une baseline ne bloque pas un prompt malveillant à la milliseconde. Les deux couches ne se substituent pas, elles se complètent.
La chaîne de bout en bout : comment Cisco et Splunk s’assemblent
Reste la question qui décide de tout : ces briques se parlent-elles réellement, ou faut-il construire les ponts soi-même ? Voici ce qui existe aujourd’hui, et ce qu’il reste à assembler.
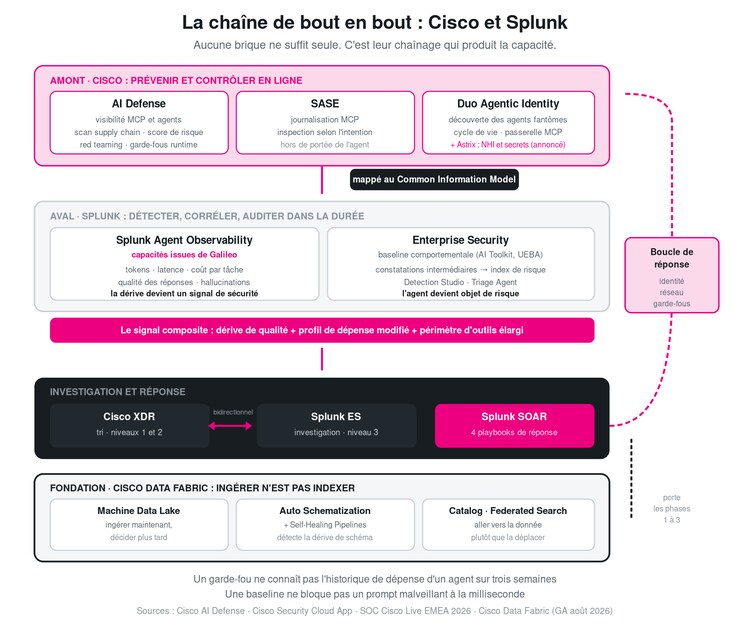
Figure 3. La chaîne de bout-en-bout Cisco et Splunk
Le pont existe déjà, et il est normalisé
Le point le plus important pour un architecte est celui-ci : l’intégration Cisco AI Defense vers Splunk récupère les alertes et les associe au Common Information Model, avec restitution dans un tableau de bord dédié. Elle embarque également une détection prête à l’emploi dans Enterprise Security, qui crée une recherche et fait remonter les attaques potentielles contre les modèles d’IA de votre environnement. Ces capacités sont disponibles depuis 2025.
Attention toutefois au périmètre. Cette détection prête à l’emploi vise les attaques contre les modèles d’IA, ce qui n’est pas la même chose que la surveillance comportementale d’une flotte d’agents. Elle couvre une partie réelle du besoin, pas sa totalité. La baseline par agent reste la brique à construire, et c’est bien pour cela qu’elle occupe la phase 3 du plan, sa phase centrale (figure 4).
Ce mapping CIM est décisif. Sans lui, les alertes de sécurité IA arrivent dans un silo de plus, avec leur propre schéma, leurs propres champs, leur propre tableau de bord. Avec lui, elles deviennent corrélables avec le reste de vos données : une alerte de manipulation d’agent peut être rapprochée d’un événement d’authentification, d’un changement de configuration, d’un flux réseau inhabituel. C’est la matière première des détections composites de la phase 4 (figure 4), parce qu’un agent compromis se trahit rarement sur un seul signal.
L’intégration AI Defense passe par la Cisco Security Cloud App, qui assure aussi l’ingestion des incidents Cisco XDR dans Splunk et leur promotion en notables. Deux limites sont à connaître avant de bâtir dessus, documentées par les équipes du SOC de Cisco Live EMEA 2026 : la promotion est principalement pilotée par le score, sans mécanisme de sélection fin, et les observables sont encapsulés dans un grand champ de description qui demande un travail d’extraction supplémentaire.
Ce que le SOC de Cisco Live a construit, et ce qu’on peut en reprendre
Cette même équipe a bâti à Amsterdam une intégration bidirectionnelle entre Cisco XDR et Splunk Enterprise Security qui constitue un patron directement transposable aux agents.
Leur modèle est un SOC en tiers : les analystes de niveau 1 et 2 travaillent dans Cisco XDR pour le tri et l’investigation initiale, ceux de niveau 3 opèrent dans Splunk ES pour les investigations avancées, le pivot et la corrélation profonde. Le problème classique était la friction à l’escalade : pivots manuels, reconstruction du contexte, changement de plateforme, risque de perdre du renseignement en route.
La solution qu’ils ont construite suit un enchaînement dont chaque étape a son intérêt pour notre sujet. Un changement de statut d’incident dans XDR déclenche l’envoi du résumé complet vers un collecteur HEC Splunk. Une première analytique aplatit les observables et génère une constatation intermédiaire dans l’index de risque pour chacun, en les qualifiant d’objets de menace. Une seconde analytique corrèle ces entrées et produit une constatation unique par incident, à laquelle les observables sont automatiquement rattachés. Un playbook Splunk SOAR promeut ensuite la constatation en investigation formelle et recopie le journal d’incident XDR, notes d’analystes et résumé généré par IA compris. Enfin, un dernier playbook renvoie le statut et la disposition vers XDR une fois l’investigation close.
Pourquoi ce patron nous intéresse directement. D’abord parce que la mécanique des constatations intermédiaires alimentant le risque est celle que je recommande en phase 4 (figure 4) pour les agents : plusieurs signaux faibles qui s’agrègent en un objet de risque unique, plutôt qu’une pluie d’alertes. Ensuite parce que la synchronisation bidirectionnelle est ce qui manquera cruellement le jour où un agent devra être arrêté : la décision se prend souvent dans un outil et s’exécute dans un autre. Enfin parce que ce SOC a démontré qu’on peut préserver le contexte d’investigation d’une plateforme à l’autre sans copier-coller, ce qui compte quand la fenêtre de réaction se mesure en secondes.
L’identité non humaine : ce qu’Astrix ajoute à Duo
Arrêtons-nous sur l’identité, puisque c’est par elle qu’un incident devient une brèche.
Le socle s’appelle Duo Agentic Identity, présenté en mars 2026, et il faut en comprendre les trois capacités parce qu’elles recoupent les phases de ce plan (figure 4).
La découverte étend Cisco Identity Intelligence pour fournir un inventaire dynamique des agents actifs, mis à jour dès qu’un agent commence à opérer plutôt que par scans périodiques. L’argument est architectural : parce que la plateforme couvre à la fois l’identité et le réseau, elle fait apparaître des agents qui ne se sont jamais enregistrés auprès de votre fournisseur d’identité. Comme le formule Duo, les outils d’identité traditionnels voient ce qui s’authentifie auprès d’eux, là où Cisco voit ce qui communique sur l’infrastructure. C’est ce qui rend possible la détection d’agents fantômes, soit la cécité décrite en ouverture.
Le cycle de vie s’appuie sur Duo Directory pour enregistrer les agents comme des objets d’identité à part entière, et non comme des comptes de service ou des procurations de leurs opérateurs humains. Chaque agent est rattaché à un propriétaire humain, affecté à des groupes pour l’application des politiques, authentifié et journalisé dès son intégration. C’est le mécanisme qui rend exigible la date d’expiration sur laquelle j’insiste en phase 1 (figure 4).
Le moindre privilège à chaque appel d’outil passe par une passerelle MCP placée entre les agents et les systèmes qu’ils sollicitent. Plutôt que de compter sur chaque serveur d’outils pour appliquer correctement ses contrôles, la passerelle intercepte chaque requête, l’évalue contre le moteur d’autorisation fine de Duo, et autorise ou bloque l’action avant qu’elle n’atteigne sa cible. À noter sur la maturité : les déclinaisons de cette passerelle, notamment pour agentgateway et Amazon Bedrock AgentCore Gateway, sont en bêta à l’automne 2026.
Où se situe alors Astrix Security, dont Cisco a annoncé l’acquisition le 4 mai 2026 et l’a finalisée le 29 juin ? Il faut se garder d’un contresens tentant : Astrix n’a pas apporté l’identité agentique à Duo, puisque Duo Agentic Identity la précède de deux mois. Astrix apporte autre chose, sur un périmètre plus large que les agents : la profondeur sur les identités non humaines au sens classique, clés d’API, comptes de service, jetons OAuth, avec découverte et gouvernance, gestion du cycle de vie, détection des identifiants compromis et des actions hors périmètre, et gestion centralisée des secrets à travers coffres et cloud. Ce dernier point adresse frontalement le risque ASI03, et aucune passerelle d’autorisation ne le couvre.
La nuance est d’autant plus utile que Duo pose lui-même la limite des outils de gouvernance d’identités non humaines, conçus pour des comptes de service et des clés d’API statiques et prévisibles, et non pour l’application par action et par session qu’exige l’agentique. Les deux approches sont donc complémentaires par construction : Astrix couvre le patrimoine de credentials, Duo couvre la décision à l’instant de l’appel d’outil.
Reste le calendrier. Cisco annonce son intention d’intégrer les capacités d’Astrix dans Cisco Identity Intelligence, puis de les étendre à Cisco Secure Access et à Duo IAM. C’est une trajectoire déclarée, assortie des réserves d’usage sur les déclarations prospectives, et non une fonctionnalité disponible aujourd’hui.
Cette visibilité et cette intelligence alimentent Splunk, pour donner aux équipes une vue unifiée de l’activité des agents avec le contexte nécessaire à l’investigation. C’est le chaînage que décrit la section suivante.
Galileo, désormais au cœur de Splunk Observability
Il reste une dimension que ni le SIEM ni les garde-fous ne couvrent, et c’est celle qui distingue la sécurité des agents de toute la sécurité qui l’a précédée : la qualité du raisonnement.
Les capacités issues de Galileo, intégrées à l’observabilité Splunk, comblent ce manque. Là où un SIEM voit des événements et un garde-fou voit des requêtes, l’évaluation d’agent voit la dérive : une baisse progressive de la qualité des réponses, une augmentation du taux d’hallucination, un agent qui commence à répondre à côté. Corrélée aux tokens consommés, à la latence et au coût par tâche, cette télémétrie devient un capteur de sécurité à part entière.
Prenons le cas de l’empoisonnement de mémoire décrit plus haut, celui dont l’effet est différé de plusieurs semaines. Aucun garde-fou en ligne ne le verra, puisque au moment de l’injection rien d’anormal ne se produit, et au moment de l’exploitation l’agent consulte simplement sa propre mémoire. Aucune signature ne le détectera. Mais une dérive de qualité conjuguée à une modification du profil de dépense, sur un agent dont le périmètre d’outils s’élargit doucement, dessine un signal composite qu’une plateforme d’observabilité et un SIEM peuvent voir ensemble, et qu’aucun des deux ne verrait seul.
C’est la raison pour laquelle je considère l’arrivée de Galileo dans le portefeuille Splunk comme structurante pour la sécurité agentique, et pas seulement pour l’exploitation. La qualité devient un indicateur de compromission.
La chaîne complète
Résumons l’assemblage, de l’amont vers l’aval (figure 3). En amont, trois briques Cisco contrôlent en ligne, chacune sur son plan : AI Defense pour les modèles, les agents et la chaîne d’approvisionnement, le SASE pour le réseau, Duo Agentic Identity pour l’identité, qu’Astrix doit compléter sur les credentials non humains. Leurs signaux convergent vers Splunk, mappés au CIM, où ils rejoignent la télémétrie d’exécution et de coût de Splunk Agent Observability. Enterprise Security établit la normalité, corrèle et agrège le risque par agent. Cisco XDR et ES se partagent l’investigation en tiers, de façon bidirectionnelle. Et Splunk SOAR exécute la réponse, en actionnant en retour les leviers Cisco que sont l’identité, le réseau et les garde-fous.
Aucune de ces briques ne suffit seule. C’est leur chaînage qui produit la capacité, et c’est ce chaînage que le plan qui suit met en ordre.
La fondation de données : Cisco Data Fabric
Il reste une objection que personne ne formule en réunion de lancement, mais que tout le monde finit par rencontrer. Tout ce que je viens de décrire suppose d’ingérer, de normaliser et de conserver beaucoup plus de données qu’aujourd’hui : traces d’exécution d’agents, appels d’outils, délégations, écritures mémoire, journaux MCP du réseau, alertes AI Defense, télémétrie de coût. Le plan est juste, et il se heurte à un mur de volume, de normalisation et de facture.
C’est le problème que traite Cisco Data Fabric, dont la vision avait été présentée à .conf25 et dont les capacités sont passées en disponibilité générale le 4 août 2026. C’est une architecture essentiellement construite sur la plateforme de données de Splunk.
Mon collègue José N’Goran en a publié une lecture pédagogique remarquable, que je recommande à quiconque veut comprendre l’architecture avant d’en lire les implications sécurité. Je m’appuie ici sur sa grille, parce qu’elle éclaire ce qui nous intéresse.
La distinction qui change tout : ingérer n’est pas indexer
José insiste sur un point que la plupart des discussions confondent, et qui est pourtant la clé de tout le reste. Ingérer revient à absorber la donnée après son traitement. Indexer consiste à la stocker en l’enrichissant de métadonnées, dans des buckets qui serviront à la recherche en temps réel, en construisant au passage le lexique qui accélère cette recherche. Ce sont deux opérations distinctes, et c’est leur couplage historique qui coûte cher.
De là découlent les deux problèmes qu’il formule, et qui frappent la sécurité agentique de plein fouet.
Le premier : faut-il vraiment tout indexer ? Les volumes de données machine croissent, l’indexation exige du stockage, et les organisations se retrouvent à arbitrer très en amont sur ce qu’elles collectent. José pointe la conséquence, et elle devrait faire sursauter tout responsable d’investigation : la donnée que l’on choisit de ne pas conserver aujourd’hui pourrait être celle dont on aura besoin demain. En sécurité, cette phrase n’est pas théorique. Quand vous découvrez qu’un agent a été compromis, la question posée est toujours la même : qu’a-t-il fait les semaines précédentes ? Si la télémétrie de ces semaines a été écartée au moment de la collecte pour des raisons de coût, l’investigation s’arrête là.
Le second : la donnée est déjà partout. Azure Blob Storage, Amazon S3, Databricks, Snowflake. Demander de tout rapatrier vers une plateforme unique n’est pas réaliste, ni économiquement ni opérationnellement.
Trois briques répondent à cela, et chacune change la faisabilité de ce plan.
La normalisation cesse d’être le travail le plus ingrat
J’ai écrit plus haut que l’attribution et le mappage CIM constituaient l’étape la plus fastidieuse et la plus déterminante. Les nouvelles capacités de gestion de données s’y attaquent directement. Auto Schematization recommande les mappings CIM et génère les artefacts de configuration nécessaires pour corréler plus tôt. Guided Onboarding joue le rôle d’expert intégré au produit pour guider la mise en place. Et Self-Healing Pipelines détecte les dérives de conformité CIM au fil de l’évolution des sources, en proposant des remédiations générées par IA que l’administrateur valide.
Ce dernier point répond à un risque réel de la phase 2 (figure 4). Les formats de télémétrie des frameworks d’agents bougent vite, bien plus vite que ceux d’un pare-feu. Une chaîne de normalisation figée se dégrade silencieusement, et vos détections avec elle. Détecter la dérive de schéma, c’est empêcher votre dispositif de sécurité de pourrir sans prévenir.
La baseline devient économiquement soutenable
Une baseline comportementale a besoin d’histoire. C’est sa nature même : plusieurs semaines d’observation pour caractériser une normalité, sur des données qu’on interrogera rarement à chaud mais qu’on ne peut pas se permettre de perdre. C’est le profil de coût le plus défavorable dans un modèle où ingestion et indexation sont couplées.
Le Splunk Machine Data Lake répond à ce besoin, et José en résume la promesse d’une formule que je reprends volontiers : ingérer maintenant, décider plus tard. On absorbe de grands volumes de données machine à moindre coût, sans trancher immédiatement sur ce qui mérite d’être indexé, puis on promeut vers l’indexation les blocs dont on a réellement besoin pour la recherche et la corrélation.
Pour la sécurité des agents, cela résout une contradiction que je n’aurais pas su lever autrement. La baseline exige de conserver beaucoup d’historique d’agents sans savoir à l’avance lequel servira. L’investigation post-incident exige la même chose. Dans un modèle couplé, il fallait choisir entre payer pour tout indexer et accepter des angles morts. Le découplage transforme cet arbitrage en décision différée.
Catalog, la troisième brique, répond à la question que pose inévitablement une donnée répartie : savoir ce que l’on a et où cela se trouve. Évident en apparence, essentiel dès lors que la donnée ne réside plus en un lieu unique, et directement utile à l’inventaire de la phase 1 (figure 4). Enfin, l’Extended Federated Search inverse la logique habituelle : plutôt que de déplacer systématiquement la donnée vers la plateforme qui l’interroge, on donne à la plateforme la capacité d’aller vers la donnée, dans S3, Snowflake, Databricks ou ailleurs, puis de la corréler.
Comme José le résume, la donnée n’a plus nécessairement besoin d’être déplacée et indexée immédiatement pour avoir de la valeur. Pour un SOC qui doit surveiller une flotte d’agents, c’est la différence entre une surveillance soutenable et un programme qui cale au premier arbitrage budgétaire.
La gouvernance appliquée à ses propres agents
Le dernier point est celui que je trouve le plus élégant, parce qu’il relève de la cohérence plutôt que de la fonctionnalité. Agent Launchpad permet de construire un agent, de choisir son modèle, de le connecter à des outils et de lui attribuer des compétences, sans développement ni expertise en science des données. Mais surtout, les administrateurs gardent la main par un contrôle d’accès basé sur les rôles, qui gouverne qui peut accéder à quels agents, à quelles données et à quels outils approuvés. Et chaque exécution d’agent reste traçable : on peut revoir les preuves, inspecter l’usage des outils, poser des questions de suivi avant de répondre.
C’est la discipline même que cet article réclame pour vos agents, appliquée par Splunk à ses propres agents. Un éditeur qui exige de ses clients une gouvernance qu’il ne s’applique pas à lui-même serait peu crédible. Ici, le modèle est le même : identité, périmètre d’outils, traçabilité de chaque exécution. À noter également, les Splunk agent skills sont publiées en open source, ce qui permet d’auditer les instructions données aux agents plutôt que de les subir.
Ce que Data Fabric n’est pas
Cisco Data Fabric n’est pas un contrôle de sécurité. Il ne détecte rien par lui-même, ne bloque rien, et ne remplace ni la baseline de la phase 3 (figure 4) ni les détections de la phase 4. Le présenter comme une réponse à la sécurité des agents serait un contresens.
Ce qu’il apporte est différent, et sans doute plus fondamental : il rend les phases 1 à 3 du plan (figure 4) réalisables à l’échelle et à un coût défendable. Beaucoup de programmes de sécurité échouent non pas parce que les détections étaient mauvaises, mais parce que la fondation de données n’a jamais tenu. Sur une population d’agents qui produit un volume de télémétrie sans commune mesure avec celui des utilisateurs humains, cette fondation devient la condition de possibilité du reste.
Le plan opérationnel Splunk : cinq phases
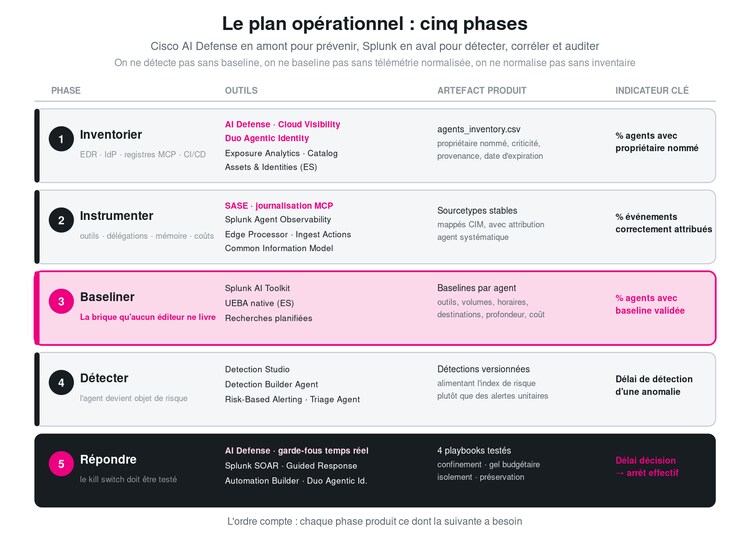
Figure 4. Le plan opérationnel en cinq phases
Ce plan suppose une plateforme Splunk déjà en place. Il ne demande pas de remplacer quoi que ce soit. Chaque phase produit un artefact concret et se mesure par un indicateur. L’ordre compte : on ne peut pas détecter sans baseline, ni baseliner sans télémétrie normalisée, ni normaliser sans inventaire.
Phase 1 - Inventorier
Objectif. Savoir quels agents existent, qui les possède, et ce qu’ils sont censés faire. On ne définit pas de politique pour des agents dont on ignore l’existence.
Sources à mobiliser. Les journaux EDR pour les processus et binaires d’agents sur les postes ; le fournisseur d’identité et Duo pour les identités non humaines ; les registres de serveurs MCP ; l’annuaire d’agents si vous avez commencé à déployer AGNTCY ; les journaux CI/CD pour les agents intégrés aux pipelines ; la facturation des fournisseurs de modèles, qui révèle souvent des agents que personne n’avait déclarés.
Outils. Chaque brique couvre un angle distinct. AI Cloud Visibility, dans AI Defense, détecte les serveurs MCP, les processus d’agents et leurs intégrations d’outils dans les environnements cloud. Duo Agentic Identity recense les agents sous l’angle identité, y compris les agents fantômes, et rattache chacun à un propriétaire humain nommé, ce qui rend la date d’expiration exigible plutôt que déclarative. Exposure Analytics rapproche ensuite ces agents des entités que le SOC connaît déjà, pour les rendre interrogeables au même titre que vos serveurs et vos utilisateurs. Enfin, Catalog répertorie les jeux de données où réside leur télémétrie.
Artefact produit. Un référentiel agents_inventory.csv intégré au framework Assets and Identities, avec pour chaque agent : identifiant, propriétaire humain nommé, finalité métier, criticité, environnement, date d’expiration. Ce dernier champ n’est pas décoratif : tout agent doit avoir une date de péremption, faute de quoi votre flotte ne fera que croître.
Indicateurs. Nombre d’agents découverts par rapport aux agents déclarés, part des agents dotés d’un propriétaire nommé, part des agents dotés d’une date d’expiration.
Phase 2 - Instrumenter et normaliser
Objectif. Faire entrer dans Splunk une télémétrie qui distingue explicitement l’agent de l’humain, et qui capture les quatre familles de signaux qui comptent.
Les quatre flux à instrumenter. Les appels d’outils : quel agent, quel outil, quels paramètres, quel résultat. Les messages inter-agents : qui délègue à qui, avec quelle profondeur de chaîne. Les écritures mémoire : ce que l’agent inscrit dans son contexte persistant. Les transactions : tokens consommés, coûts, et le cas échéant règlements on-chain.
Outils. Splunk Agent Observability pour les traces d’exécution et la télémétrie de coût, le collecteur OpenTelemetry de Splunk Observability Cloud pour le reste de la chaîne. Edge Processor ou Ingest Actions pour normaliser et enrichir avant indexation. Le Common Information Model pour rattacher ces données aux modèles Authentication, Change et Network Traffic déjà exploités par vos détections existantes.
Ne négligez pas le réseau. La journalisation MCP du SASE de Cisco, avec son inspection tenant compte de l’intention, capture le trafic entre agents et outils au niveau réseau, indépendamment de la bonne volonté d’instrumentation des équipes applicatives. C’est une source précieuse pour deux raisons : elle couvre les agents que vous n’avez pas pu instrumenter, et elle est difficile à contourner pour un agent compromis, là où une télémétrie applicative peut être désactivée par celui-là même qu’elle surveille.
Le point non négociable. Chaque événement produit par un agent doit porter un champ d’attribution qui l’identifie comme tel, avec l’identifiant de l’agent, celui de son propriétaire humain et l’identifiant de trace de la tâche en cours. Sans ce marquage, vous retomberez dans la cécité décrite plus haut. C’est le travail le plus ingrat de tout le plan, et le plus déterminant.
Ce que Data Fabric change ici. C’est la phase qui tire le plus parti des capacités de gestion de données décrites plus haut : Auto Schematization pour le mapping CIM, Guided Onboarding pour la mise en place, Self-Healing Pipelines pour en surveiller la dérive dans la durée.
Artefact produit. Un jeu de sourcetypes stables et documentés, mappés au CIM, avec attribution agent systématique.
Indicateurs. Part des agents inventoriés qui émettent effectivement de la télémétrie, part des événements agents correctement attribués, latence d’ingestion.
Phase 3 - Baseliner
Objectif. Construire la brique qu’aucun éditeur ne livre : la définition de la normalité, agent par agent.
La méthode. Pour chaque agent, sur une fenêtre d’observation de trois à quatre semaines, on modélise plusieurs dimensions : le périmètre d’outils réellement invoqués, le volume horaire d’appels, les plages horaires d’activité, les destinations et systèmes contactés, la profondeur habituelle des chaînes de délégation, la consommation de tokens et le coût par tâche.
Outils Splunk. Le Splunk AI Toolkit, ex-Machine Learning Toolkit, pour l’ajustement de distributions par agent, avec l’algorithme DensityFunction, conçu pour modéliser une distribution et en détecter les écarts. L’UEBA native d’Enterprise Security pour la détection d’anomalies sur les entités, désormais intégrée à la plateforme plutôt que déportée. Les recherches planifiées pour rafraîchir les référentiels de baseline.
Un exemple de construction de baseline.
index=agent_telemetry sourcetype="agent:toolcall" earliest=-28d@d latest=@d
| stats dc(tool_name) AS tool_variety,
count AS calls_total,
values(tool_name) AS approved_tools
BY agent_id
| eval calls_per_day = round(calls_total/28, 1)
| outputlookup agent_tool_baseline.csv
La question du coût, qu’il faut anticiper. Une baseline exige de l’historique, et c’est souvent là qu’un programme de ce type cale. Le Machine Data Lake, présenté plus haut, est la réponse à prévoir avant d’engager cette phase, pas pendant.
Le piège à éviter. Une baseline construite sur une période où un agent était déjà compromis fige l’anomalie en normalité. Il faut donc valider les baselines avec les propriétaires métier identifiés en phase 1, et non les accepter aveuglément. C’est le moment où l’inventaire nominatif de la phase 1 prouve son utilité.
Artefact produit. Des référentiels de baseline par agent, rafraîchis automatiquement, et validés par les propriétaires.
Indicateurs. Part des agents dotés d’une baseline validée, stabilité des baselines dans le temps, taux de faux positifs au démarrage de la détection.
Phase 4 - Détecter
Objectif. Traduire les écarts à la baseline en risque exploitable, en traitant l’agent comme un objet de risque de premier rang.
Le principe directeur. Plutôt que d’empiler des alertes unitaires, on agrège le risque par agent avec le Risk-Based Alerting d’Enterprise Security. Un agent qui sort légèrement de son périmètre d’outils, puis dépense un peu plus que d’habitude, puis contacte une destination inhabituelle, ne déclenche aucune alerte prise isolément. La somme de ces signaux doit en revanche le faire remonter. C’est le problème que le RBA résout depuis des années pour les utilisateurs, appliqué à une nouvelle population.
Outils Splunk. Detection Studio pour le cycle de vie des détections. Le Detection Builder agent pour accélérer la création, le test et le réglage. Le framework RBA d’ES, avec les agents comme objets de risque. Le Triage agent pour l’évaluation et l’explication des signalements.
Voici quatre détections qui couvrent les quatre familles de menaces (figure 1). Elles sont écrites de façon générique et devront être adaptées à vos sourcetypes.
1. Sortie du périmètre d’outils habituel (famille chaîne et décision)
index=agent_telemetry sourcetype="agent:toolcall" earliest=-1h
| lookup agent_tool_baseline.csv agent_id OUTPUT approved_tools, calls_per_day
| eval is_new_tool = if(isnull(mvfind(approved_tools, tool_name)), 1, 0)
| where is_new_tool = 1
| stats count AS invocations,
values(tool_name) AS unexpected_tools
BY agent_id, agent_owner
| eval risk_score = invocations * 20, risk_object_type = "agent"
| rename agent_id AS risk_object
2. Anomalie de dépense par agent (famille argent)
index=agent_telemetry sourcetype="agent:transaction" earliest=-7d
| bin _time span=1h
| stats sum(amount_usd) AS spend_hourly BY agent_id, _time
| eventstats avg(spend_hourly) AS baseline_avg,
stdev(spend_hourly) AS baseline_stdev
BY agent_id
| eval deviation = round((spend_hourly - baseline_avg) / baseline_stdev, 2)
| where deviation > 3 AND spend_hourly > 10
| table _time, agent_id, spend_hourly, baseline_avg, deviation
3. Chaîne de délégation anormale (famille chaîne)
index=agent_telemetry sourcetype="agent:delegation" earliest=-1h
| stats dc(callee_agent) AS fanout,
max(delegation_depth) AS max_depth,
values(callee_agent) AS delegated_to
BY trace_id, caller_agent
| where max_depth > 4 OR fanout > 10
| eval detection = "Chaine de delegation hors norme"
Cette détection vise directement le phénomène de cascade décrit plus haut (figure 2). Une profondeur de délégation qui s’emballe est souvent le premier signe visible d’une propagation.
4. Identité d’agent accédant à une destination privilégiée inédite (famille identité)
| tstats summariesonly=t count
FROM datamodel=Authentication
WHERE Authentication.user_category="agent" earliest=-24h
BY Authentication.user, Authentication.dest
| rename Authentication.* AS *
| lookup agent_dest_baseline.csv user OUTPUT known_destinations
| eval is_new_dest = if(isnull(mvfind(known_destinations, dest)), 1, 0)
| where is_new_dest = 1
| lookup agents_inventory.csv agent_id AS user OUTPUT agent_owner, criticality
| where criticality IN ("high", "critical")
L’agrégation par le risque. Ces détections alimentent l’index de risque plutôt que de générer des alertes directes. La remontée se fait ensuite sur le cumul :
| from datamodel:"Risk"."All_Risk"
| search risk_object_type="agent" earliest=-24h
| stats sum(risk_score) AS total_risk,
dc(source) AS distinct_detections,
values(source) AS triggered_rules
BY risk_object
| where total_risk > 100 AND distinct_detections >= 3
| lookup agents_inventory.csv agent_id AS risk_object OUTPUT agent_owner, criticality
| sort - total_risk
Artefact produit. Un jeu de détections versionnées dans Detection Studio, qui alimentent l’index de risque.
Indicateurs. Délai moyen de détection d’une anomalie d’agent, taux de faux positifs, part des agents critiques couverts par au moins trois détections.
Phase 5 - Répondre et gouverner
Objectif. Disposer d’un bouton d’arrêt qui fonctionne réellement quand on l’actionne, et d’une gouvernance qui tient devant un auditeur.
Les playbooks à construire dans Splunk SOAR. Un playbook de confinement qui révoque les identifiants de l’agent via Duo IAM ou le fournisseur d’identité, suspend ses jetons et coupe ses accès aux outils. Un playbook de gel budgétaire qui plafonne ou bloque la capacité de dépense de l’agent, en tokens comme en règlements. Un playbook d’isolement qui retire l’agent des annuaires de découverte pour l’empêcher d’être sollicité par ses pairs, et coupe les chaînes de délégation qui pointent vers lui. Un playbook de préservation qui fige la mémoire et le contexte de l’agent pour l’investigation, avant toute remise à zéro.
Les points d’application. Un playbook ne vaut que par les leviers qu’il actionne, et ils sont ici de trois ordres, ceux de la boucle de réponse (figure 3). L’identité, via Duo Agentic Identity, pour retirer un agent de l’annuaire, révoquer ses accès et bloquer ses appels d’outils à la passerelle MCP plutôt que d’espérer sa coopération. Le réseau, via les contrôles de politique MCP du SASE, pour couper la connectivité agent vers outil sans dépendre de la coopération de l’agent. Et les garde-fous temps réel d’AI Defense, pour durcir la politique d’un agent suspect sans l’arrêter complètement, ce qui offre un cran intermédiaire utile entre la surveillance passive et le confinement total.
Le kill switch doit être testé. Un bouton d’arrêt jamais éprouvé n’est pas un contrôle, c’est une intention. Je recommande un exercice trimestriel sur un agent non critique, chronométré, avec mesure du délai entre décision et arrêt effectif. Rapporté à un temps de propagation de 27 secondes, ce chiffre est parlant.
Le Guided Response agent et l’Automation Builder agent industrialisent ces playbooks, sans réécrire l’automatisation à chaque nouvel agent.
La gouvernance. Un tableau de bord unique doit répondre en permanence à quatre questions : quels agents tournent et qui en répond ; lesquels s’écartent de leur baseline ; combien chacun dépense et pour quelle valeur produite ; lesquels approchent de leur date d’expiration. Les revues de permissions d’agents doivent suivre le même rythme que les revues d’accès humains, ce qui suppose de les inscrire dans le même calendrier de conformité.
Artefact produit. Quatre playbooks SOAR testés, un tableau de bord de gouvernance de flotte, un calendrier de revue intégré aux processus existants.
Indicateurs. Délai entre décision et arrêt effectif d’un agent, part des playbooks testés au cours du trimestre, part des agents dont les permissions ont été revues, ratio coût sur valeur par agent.
En pratique : par où commencer
Si ce plan vous semble ambitieux, voici la version réduite qui produit néanmoins un résultat défendable devant un comité.
Commencez par l’inventaire, seul. Interrogez vos données EDR et vos journaux d’identité pour recenser ce qui tourne réellement. Nommez un propriétaire pour chaque agent trouvé. Attribuez une date d’expiration. Cet exercice, à lui seul, révèle presque toujours des agents que personne ne savait actifs, et il constitue le socle sans lequel aucune autre phase n’a de sens.
Ajoutez ensuite une seule détection, la plus rentable : celle qui repère un agent invoquant un outil qu’il n’a jamais invoqué. Elle est simple, elle produit peu de bruit une fois la baseline établie, et elle capture aussi bien un détournement d’objectif qu’un abus de privilège ou une compromission de la chaîne.
Le reste peut suivre au rythme de votre flotte.
Conclusion
Le SOC a été bâti pour protéger des humains utilisant des machines. Il protège désormais des machines utilisant des machines. Et la fenêtre de réaction s’est réduite de 48 minutes à 27 secondes.
Mes quatre articles convergent maintenant vers une leçon unique, dont chaque étape a ajouté un étage. La tokénomics nous a appris que la capacité à consommer précède la capacité à en maîtriser le coût. L’économie des agents, que la capacité à payer précède la capacité à en gouverner les décisions. L’Internet des agents, que la capacité à interopérer précède la capacité à superviser. La sécurité ajoute la marche la plus haute : la capacité à agir précède toujours la capacité à détecter les actions illégitimes.
La bonne nouvelle est que cette dernière marche ne demande pas d’attendre une technologie qui n’existe pas. Elle demande d’appliquer à une population nouvelle une discipline ancienne : inventorier, instrumenter, établir la normalité, détecter l’écart, répondre vite. C’est exactement ce que les équipes sécurité font depuis vingt ans pour les utilisateurs et les serveurs. Les agents ne changent pas la méthode, ils changent l’échelle et la vitesse.
Une dernière chose. Tout agent qui génère une alerte est désormais un suspect, pas seulement un capteur. Les organisations qui traverseront cette période ne seront pas celles qui auront déployé le plus d’agents, ni même les plus sécurisés sur le papier, mais celles qui sauront répondre sans hésiter à une question simple posée un mardi matin par un auditeur : montrez-moi ce que cet agent a fait la semaine dernière, et pourquoi c’était légitime.
Pour aller plus loin :
- L’OWASP Top 10 for Agentic Applications 2026 et l’Agentic Security Initiative
- L’annonce Splunk sur le SOC agentique et Enterprise Security 8.6, Exposure Analytics, Splunk Agent Observability
- L’annonce Cisco sur la sécurité de l’ère agentique la page Cisco AI Defense et surtout sa fiche produit détaillée mise à jour en mai 2026
- Le cadre intégré de sécurité et de sûreté de l’IA de Cisco
- Le retour d’expérience du SOC de Cisco Live EMEA 2026 sur le pont entre Cisco XDR et Splunk ES, la Cisco Security Cloud App sur Splunkbase
- La session Cisco Live BRKSEC-2801 de Rene Aguero qui détaille l’intégration entre AI Defense et Splunk
- L’annonce de disponibilité générale de Cisco Data Fabric
- L’excellent article de vulgarisation de José N’Goran, « C’est quoi Cisco Data Fabric : les fondamentaux »
- Les Splunk agent skills en open source
- L’annonce de l’acquisition d’Astrix Security par Cisco
- La présentation de Duo Agentic Identity par Matt Caulfield
- L’AI Readiness Index
- L’analyse de VentureBeat sur l’écart de baseline comportementale.
- À lire aussi, mes trois articles précédents sur la tokenomics, l’économie des agents et AGNTCY.
Articles similaires

Splunk lance des modèles d’IA générative hébergés : des informations IA natives, rien à configurer et une sécurité maximale

La résilience du futur : un enjeu humain et collectif (LinkedIn Live)