KI-Tokenomics: Von Kostentransparenz zur Kostendisziplin
Leadership SplunkDas Wichtigste im Überblick
- Dashboards für Tokenverbrauch und -kosten sind unverzichtbar, aber Kostentransparenz allein schafft noch keine Kostendisziplin.
- Der größte Kostenhebel ist oft vorgelagert: Am Anfang steht die Entscheidung, ob KI – oder Tokens – für eine bestimmte Aufgabe überhaupt erforderlich sind.
- Die Prinzipien des Daten-Tierings lassen sich direkt auf KI-Workloads übertragen. Nicht alle Kontextdaten gehören in ein LLM-Fenster, genauso wenig wie jedes Log in einen Hot Index gehört.
- Die Verantwortung für KI-Kosten ist nicht mehr nur auf Finanz-, Produkt- und Machine-Learning-Teams beschränkt. Alle, die KI-Workflows entwerfen oder nutzen – etwa durch Effizienzoptimierung mittels Context Harnessing oder Skill-Entwicklung – treffen auch Kostenentscheidungen.
Die ersten Anzeichen für Kostenkorrekturen bei Unternehmens-KI sind bereits erkennbar.
Unternehmen, die ihre KI-Nutzung rasant ausgeweitet haben, gehen mittlerweile dazu über, Abonnements zu kündigen, Nutzungsgrenzen einzuführen und zu überdenken, welche Workloads die Kosten überhaupt rechtfertigen. Microsoft soll Berichten zufolge einen Großteil seiner internen Claude Code-Lizenzen gekündigt haben, auch aus Kostengründen. Uber hat Ausgaben gekappt, nachdem das jährliche KI-Budget bereits nach vier Monaten aufgebraucht war. Hier zeigt sich, dass die KI-Nutzung schneller gewachsen ist als die nötige finanzielle Disziplin. Unternehmen, die den KI-Einsatz ausweiten, streben nun nach effektiver Kostenkontrolle. [1] [2]
KI-Anbieter reagieren darauf, indem sie den Verbrauch transparenter machen. OpenAI bietet Dashboards und API-Antwortdaten zum Tokenverbrauch. Anthropic stellt über seine Konsole und Unternehmens-APIs detaillierte Kosten- und Nutzungsberichte bereit. Ähnliche Angebote entstehen gerade überall in der Branche. [3] [4] [5]
Daher reichen Dashboards allein für KI-Tokenomics nicht aus.
Bei KI-Tokenomics geht es darum, Tokens als „Währung“ des KI-Software-Stacks zu betrachten und vor, während und nach ihrer Ausgabe wohlüberlegte Entscheidungen zu treffen. Das Fundament dafür ist Observability. Echte Kontrolle gewinnen Unternehmen durch Entscheidungen beim Routing und in der Designphase.
Dashboards zeigen, was passiert ist – mehr nicht
Anders als bei herkömmlicher Software sind die Kosten pro Nutzer bei agentenbasierter KI nicht vorhersehbar.
Ein autonomer Agent kann Schlussfolgerungen ziehen, Tools aufrufen, Daten abrufen, Aufgaben delegieren, seinen Output überprüfen und bei Fehlern einen neuen Anlauf nehmen. Bei jedem dieser Schritte werden zusätzliche Tokens verbraucht. Wenn ein Agent in einer Schleife hängen bleibt, den falschen Weg einschlägt oder wiederholt unnötigen Kontext lädt, können sich die Kosten summieren, bevor ein Mensch überhaupt bemerkt, was los ist.
Splunk AI Agent Monitoring liefert – wie viele andere Anbieter von KI-Observability – die Einblicke, die Unternehmen brauchen, um dieses Verhalten zu steuern. Es überwacht Performance, Qualität, Tokenverbrauch, geschätzte Kosten und Risiken und hilft Teams dabei, die größten Tokenfresser ausfindig zu machen. [7]
- Welche Agenten und Modelle verbrauchen die meisten Tokens?
- Wo treten Schleifen, Wiederholungsversuche und ineffiziente Tool-Aufrufe auf?
- Führt ein höherer Tokenverbrauch zu besseren Ergebnissen?
- Wann sollte ein automatischer Schutzmechanismus greifen und die Ausführung stoppen?
All dies sind wichtige Fragen, aber schon vorher solltet ihr euch fragen:
- War für diese Aufgabe überhaupt ein Agent nötig?
- Hätte diese Aufgabe eine deterministische Regel erledigen können?
- Hätte ein kleineres Modell dasselbe Ergebnis erzielt?
- Brauchte das Modell wirklich all den bereitgestellten Kontext?
- Rechtfertigt der geschäftliche Nutzen die Gesamtkosten?
Eine ausgereifte Tokenomics-Praxis muss beide Fragenkomplexe beantworten.
Bereits gelernte Datenlektionen
Wer Splunk schon lange nutzt, kennt diese Disziplin aus dem Datenmanagement.
Effektives Daten-Tiering setzte schon immer eine Entscheidung voraus: Müssen diese Daten in einem Hot Index bleiben oder können wir sie in eine kostengünstigere Speicherklasse verschieben? Nicht jedes Ereignis stellt dieselben Anforderungen an Aufbewahrungsfrist, Performance und Speicherkosten. Sämtliche Daten in der teuersten Speicherklasse abzulegen, ist zwar eine bequeme architektonische Entscheidung, aber ein teurer operativer Fehler.
Ähnliches gilt auch für KI: Nicht für jede Aufgabe braucht es einen Agenten, nicht jeder Agent braucht ein Frontier-Modell, nicht jedes Dokument gehört ins Kontextfenster und nicht jede Interaktion muss mit einem Modellaufruf beginnen.
Das Dashboard zeigt, wohin die Tokens geflossen sind. Tiering-Disziplin entscheidet darüber, ob sie überhaupt dorthin fließen müssen.
Ein höherer Tokenverbrauch führt nicht automatisch zu einer höheren Genauigkeit
Hinweis zur Aussagekraft: Die Befunde dieser Studie stammen aus Experimenten mit agentenbasiertem Coding. Sie verdeutlichen das Ausmaß und die Schwankungsbreite des Tokenverbrauchs von Agenten, lassen sich aber nicht für alle Workloads verallgemeinern.
Stufenleiter für Token-Entscheidungen
Vor dem Einsatz eines KI-Agenten sollten Teams folgende Fragen der Reihe nach durchgehen:
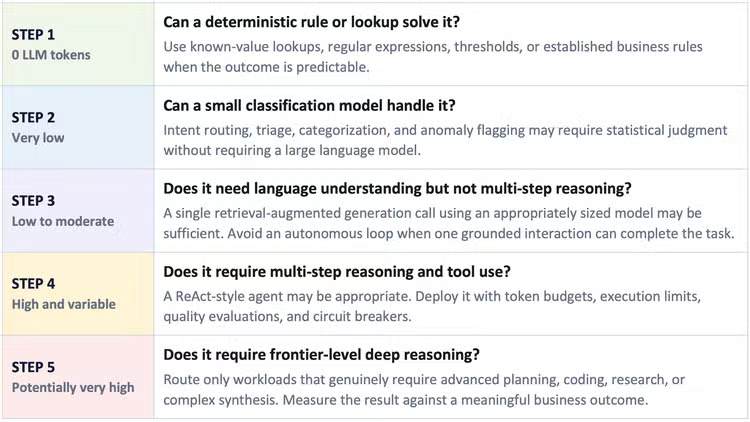
Kostenprofile sind als relativer Vergleichsmaßstab für den Entwurf zu verstehen, nicht als feste Token-Benchmarks. Wissenschaftlicher Hintergrund: Quelle [6].
Diese Stufenleiter hilft Unternehmen dabei, KI bewusst einzusetzen, und fördert damit die KI-Akzeptanz. Ziel ist es, Tokens dort einzusetzen, wo sie bei optimierter Nutzung messbaren Mehrwert schaffen.
Solide Produktentscheidungen als Grundlage für Token-Entscheidungen
Machine-Learning-Teams handeln seit Jahren nach einem bewährten Produktdesign-Prinzip: Wenn sich ein Problem mit regelbasierten Tools lösen lässt, sollte man diese Tools nutzen. Wenn klassisches Machine Learning das Problem lösen kann, ist Deep Learning nicht automatisch die richtige Wahl. Und wenn ein kleineres Modell ausreicht, braucht es nicht gleich ein Frontier-Modell.
Dieses Prinzip gilt nach wie vor – heute sogar mehr denn je, weil Agenten eine verführerisch einfache Lösung für jedes Problem versprechen.
Verändert hat sich allerdings, wer dieses Prinzip anwenden muss. Früher wurden solche Entscheidungen von einer relativ kleinen Gruppe aus Produktmanagern, Architekten und Machine-Learning-Engineers getroffen. Heute trifft jede Entwicklerin, die einen agentenbasierten Workflow konfiguriert, jedes Operations-Team, das Problembehebungen automatisiert, und jeder Analyst, der die KI „einfach machen lässt“, eine architektonische und finanzielle Entscheidung.
Damit die KI-Kosten unter Kontrolle bleiben, muss Token-Disziplin künftig in jedes Design einfließen.
Die drei Reifegrade der KI-Tokenomics
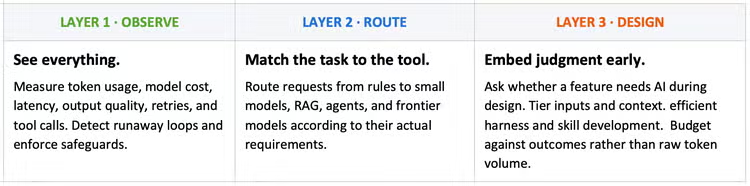
Tokenomics beginnt nicht erst mit Kosten-Dashboards
Monitoring und Observability für KI-Agenten sind eine maßgebliche Voraussetzung für KI-Tokenomics. Ein Unternehmen kann nur kontrollieren, was es sieht – ein effektives Monitoring liefert die Token-, Kosten-, Qualitäts- und Risikosignale, die für ein Eingreifen nötig sind. [7]
Doch Transparenz ist erst der Anfang der Kostenkontrolle, nicht ihr Endpunkt.
Der nächste Reifegrad setzt schon früher an: Routing-Logik, Workload-Tiering, Kontextdisziplin und Entscheidungen werden bereits in der Designphase berücksichtigt, also lange bevor ein Agent das erste Token verbraucht.
Erst Observability, dann Routing, dann Design.
Unternehmen, die diese Faustregel beherzigen, sparen bei KI nicht nur Geld. Sie schaffen auch schnellere, zuverlässigere und leichter nachvollziehbare Systeme, die besser auf den geschäftlichen Nutzen ausgerichtet sind.
Das ist das große Versprechen von KI-Tokenomics – und der Grund, warum sie weit über Dashboards hinausgeht.
Quellen und Datenhinweise
- [1] Axios: „AI sticker shock hits corporate America,“ 28. Mai 2026. Lizenzkündigung bei Microsoft und Kostenkorrektur in Unternehmen. Quelle ansehen
- [2] TechCrunch: „Uber caps employee AI spending after blowing through budget in 4 months“, 2. Juni 2026. Uber-Budgetüberschreitung und Nutzungslimits. Quelle ansehen
- [3] OpenAI-Hilfe: „API-Nutzung und Kosten prüfen“. Dashboard zur API-Nutzung und Tokendaten auf Antwortebene. Quelle ansehen
- [4] Anthropic-Hilfe: „Kosten- und Nutzungsberichte in der Claude Console“, 16. März 2026. Console-Berichte und CSV-Export. Quelle ansehen
- [5] Dokumentation der Anthropic-Plattform: „Usage and Cost API“. Nutzungs- und Kostenberichte (in USD) auf Unternehmensebene. Quelle ansehen
- [6] Longju Bai et al.: „How Do AI Agents Spend Your Money?“ arXiv:2604.22750, 2026. Der 1.000-fache Verbrauch, die bis zu 30-fache Schwankungsbreite und die Befunde zur Genauigkeit gelten für die im Rahmen der Studie durchgeführten Experimente mit agentenbasiertem Coding. Quelle ansehen
- [7] Splunk-Dokumentation: „Introduction to Splunk AI Agent Monitoring“. Performance, Qualität, Tokenverbrauch, geschätzte Kosten und Risikoüberwachung. Quelle ansehen
Redaktioneller Hinweis: Anbieterfunktionen, Preise und Unternehmensrichtlinien zur Nutzung können sich ändern. Zeitkritische Aussagen sollten unmittelbar vor der Veröffentlichung erneut geprüft werden.
Ähnliche Artikel
Online-Lernen: ein neuer Machine-Learning-Ansatz in Splunk
Token Meter: Ein Live-Kostenzähler für eure Coding-Agenten