Phenisys améliore la visibilité et le troubleshooting Microsoft Teams avec l’app MS Teams Observability
Observability Audrey WilliartSpécialiste indépendant de l’observabilité depuis 15 ans, Phenisys a développé MS Teams Observability, un agent dédié qui transforme la télémétrie Microsoft Teams en diagnostics exploitables au sein de Splunk Enterprise ou Splunk Observability — disponible sur Splunkbase. J’ai souhaité rencontrer Christophe Nétillard, Senior Consultant & Dirigeant chez Phenisys, pour parler de la genèse du projet, ses cas d’usage et ses prochaines évolutions.
Pouvez-vous présenter Phenisys (et votre expertise autour de Microsoft Teams et de l’observabilité) ?
Phenisys est une société de conseil et d’expertise indépendante, basée à Lyon, spécialisée depuis 15 ans dans la mesure de la performance applicative et réseau pour l’utilisateur final — ce que l’on appelle aujourd’hui l’observabilité. Nous accompagnons nos clients sur les fondamentaux de l’observabilité, du conseil et de l’audit jusqu’à l’ingénierie et à l’adoption au long cours dans les process IT ou métiers.
Nous sommes un partenaire Splunk spécialisé et reconnu jusqu’au statut Premier, avec une équipe fortement certifiée.
Notre expertise nous a naturellement conduits à nous pencher sur la performance Microsoft Teams, devenu en quelques années un service critique pour nos clients, mais qui restait un angle mort pour la plupart des stacks d’observabilité existantes.
Qu’est-ce qui vous a poussé à développer l’application MS Teams Observability ?
Le constat de terrain était commun à de nombreux clients : Microsoft Teams est utilisé par tous les utilisateurs d’une entreprise jusqu’aux VIP, et cette adoption massive s’est accompagnée de tickets liés aux appels et réunions, alors même que les indicateurs restaient au vert côté administration. Les outils natifs Microsoft ont de grosses limites pour les équipes support : les données de qualité d’appel sont difficiles d’accès, elles ne sont pas facilement corrélées à l’infrastructure réseau par site et la root cause est longue et difficile à identifier. Or, une part majoritaire des dégradations Teams a une origine réseau locale. Les équipes helpdesk se retrouvent donc à procéder par élimination, sans données précises, pendant que les équipes réseau peinent à confirmer ou écarter leur responsabilité. C’est ce manque de visibilité actionnable, spécifique aux flux temps réel de Teams, qui nous a poussés à développer un agent dédié.
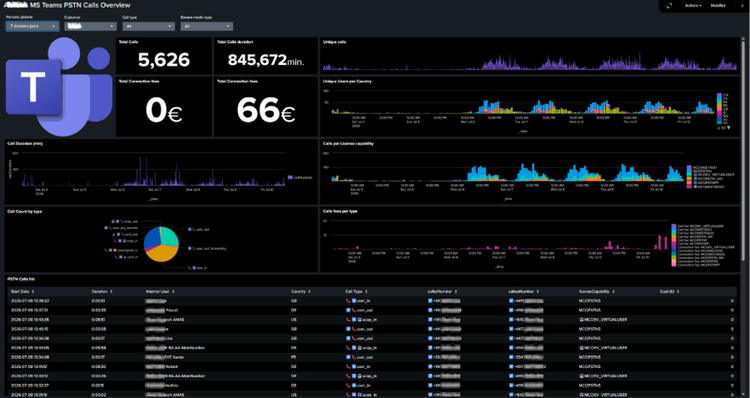
Nous avons aussi eu la demande spécifique de monitoring et métrologie de la Téléphonie Teams (PSTN) et des Centres d’Appel Teams, de l’agent jusqu’à l’appel. Nous avons donc intégré aussi ces cas d’usage.
Cette app est destinée à quelles équipes : support N1/N2, équipes réseau, opérations numériques, responsables collaboration… ?
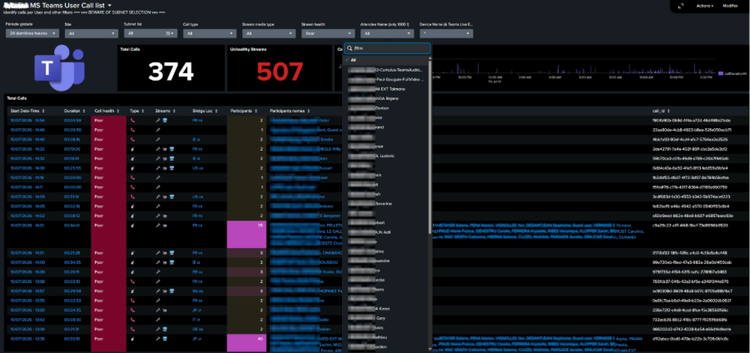
Elle s’adresse à l’ensemble de la chaîne qui gère la qualité de service Teams. Les équipes support N1/N2 y trouvent de quoi diagnostiquer un appel sans avoir à escalader vers un expert (ou avoir un accès Admin Office 365). Les équipes réseau et NOC disposent de KPI et de statuts de conformité par site pour prioriser leurs actions correctives. Les responsables collaboration et les managers IT suivent l’adoption, l’usage et la qualité perçue pour piloter leurs décisions. Et pour les organisations qui exploitent Teams comme centre de contacts, les responsables de plateaux d’appels peuvent également superviser l’activité des agents, les files d’attente et les Auto Attendants.
Pouvez-vous présenter en quelques mots votre application et comment elle simplifie l’accès à la télémétrie Microsoft Teams ?
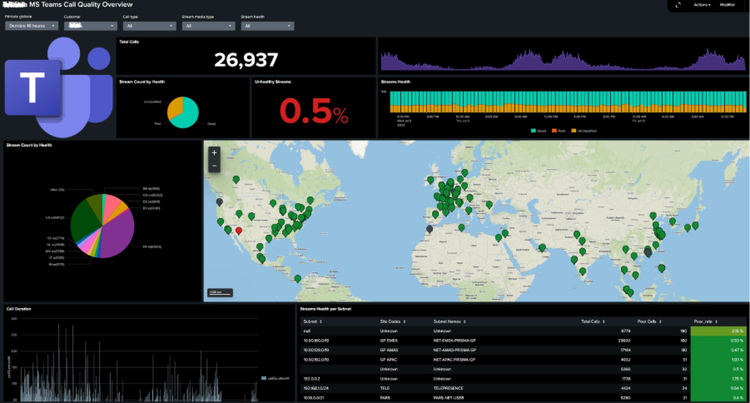
MS Teams Observability, c’est un agent dédié qui va chercher la télémétrie Microsoft Teams via les API officielles et l’injecte, déjà structurée, dans votre plateforme Splunk. Ensuite, l’app proposée dans Splunk décline la donnée en cas d’usage pratiques par des dashboards cliquables. L’idée directrice a été : pas de dashboard à construire, pas de logs à dépouiller, juste de la clarté. Dès l’installation, les équipes accèdent à des vues prêtes à l’emploi sur la qualité des appels, les utilisateurs, les sites et le réseau, sans langage de requête à apprendre et sans agent à déployer sur les postes de travail.
Quels bénéfices les équipes helpdesk et opérations retirent-elles concrètement de cette visibilité centralisée ?
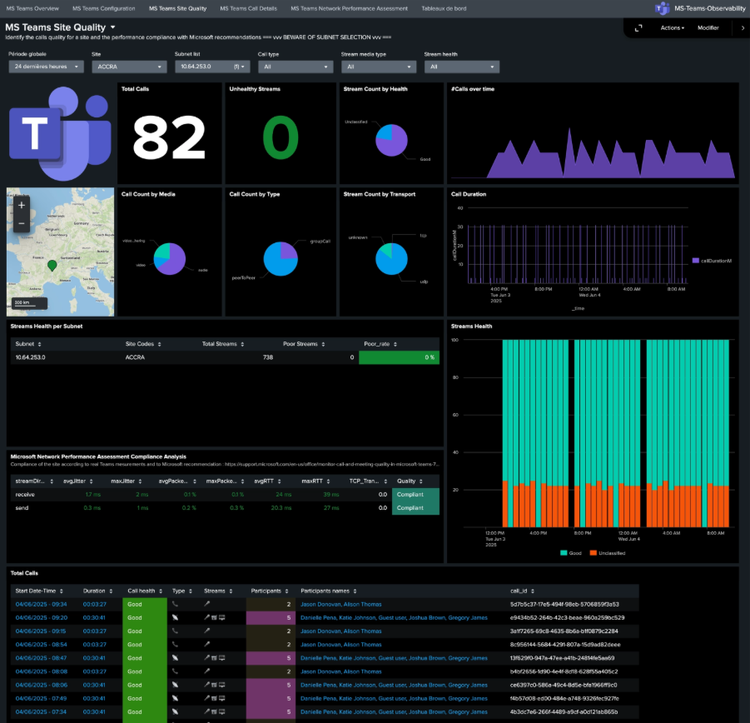
Le premier bénéfice, c’est la réduction des escalades : un technicien N1 peut désormais lire une timeline d’appel et comprendre seul ce qui s’est passé, là où il devait auparavant transmettre le ticket faute de données. Le deuxième, c’est la bascule d’un diagnostic par hypothèses vers un diagnostic factuel, appuyé sur des preuves plutôt que sur des suppositions. Côté réseau, cette visibilité permet de « prouver l’innocence » du réseau ou, au contraire, de démontrer rapidement où se situe le vrai goulet d’étranglement — ce que nous appelons réduire le Mean Time to Innocence. Au global, cela rapproche mécaniquement les équipes support et réseau, qui travaillent enfin sur les mêmes données.
L’objectif final est que la réponse cherchée tienne en 1 vue après 3 clics.
Votre solution met en avant des analytics à forte granularité. Pouvez-vous nous expliquer ce que cela change dans les investigations ?
Les outils traditionnels livrent des statistiques agrégées, utiles pour suivre une tendance mais inexploitables pour un incident précis. Notre approche descend au niveau du site ou du subnet, de l’utilisateur, de l’appel et même d’un flux média. Concrètement, une équipe peut comparer la qualité perçue entre utilisateurs connectés en Wi-Fi, en Ethernet ou en VPN, croiser les incidents par type de terminal ou de version d’OS, et repérer une zone de dégradation à l’échelle d’un sous-réseau plutôt que de constater un problème « Teams » flou et global. C’est cette granularité qui transforme une alerte générique en une cause racine actionnable.
Nous avons aussi des clients qui ciblent particulièrement leur Teams Rooms ou les VIP par exemple.
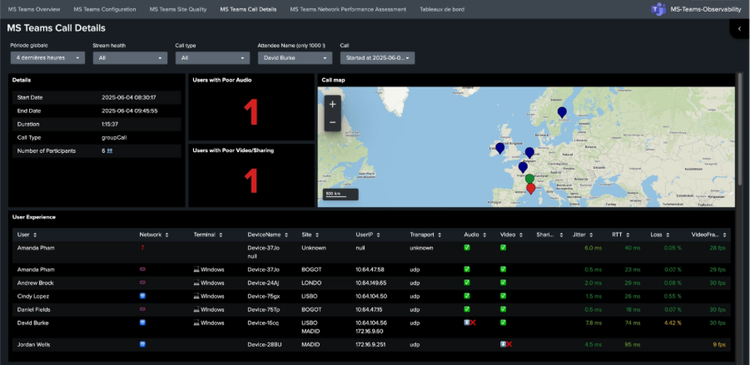
Parmi les fonctionnalités disponibles – GeoMaps, waterfalls, scoring type Apdex, suivi d’incidents – lesquelles sont les plus appréciées par vos clients ?
Les timelines de type waterfall, qui rejouent un appel flux par flux, sont probablement ce qui parle le plus immédiatement aux équipes support : elles transforment un ticket abstrait ("le son coupait") en une lecture visuelle du problème, avec la root cause identifiable en quelques minutes. Les GeoMaps arrivent juste derrière, car elles répondent en un coup d’œil à la question que tout le monde se pose en cas d’incident : « est-ce mon site, ou est-ce Microsoft ? ». Le scoring type Apdex ou la compliance d’un site, eux, sont surtout plébiscités par les managers et les DSI, qui veulent un indicateur de santé synthétique sans avoir à plonger dans le détail technique.
Comment votre application aide-t-elle les entreprises à identifier les problèmes réseau impactant l’expérience utilisateur Teams ?
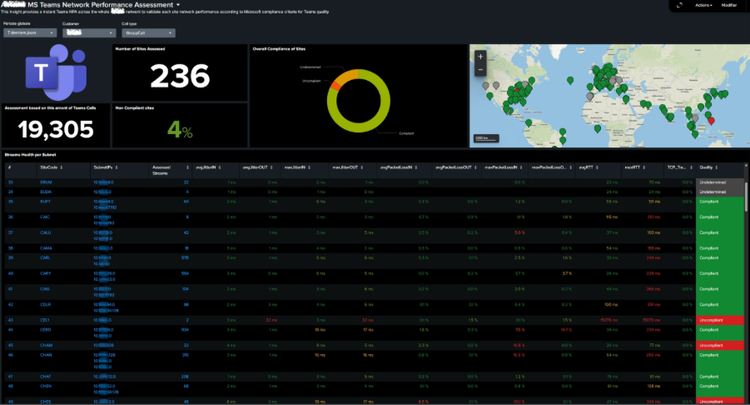
Nous cartographions la qualité réseau site par site, avec des indicateurs comme la latence, la gigue (jitter) et la perte de paquets, croisés avec le statut de conformité de chaque emplacement. Cette cartographie géographique permet de repérer immédiatement un site ou un lien opérateur instable, et de distinguer les connexions Wi-Fi, Ethernet ou VPN pour isoler la véritable origine d’une dégradation. C’est une vision que les outils génériques de Digital Employee Experience peuvent difficilement offrir, car ils ne descendent pas au niveau des codecs audio/vidéo ni des métriques réseaux propres à la voix sur IP.
Autre cas, on peut auditer l’ensemble de la compliance réseau Teams des sites (au sens documenté par Microsoft) en une seule vue. Un plan d’action peut ainsi être ciblé factuellement.
Pouvez-vous partager un exemple concret où l’application a permis de réduire significativement le temps de résolution d’un incident ?
Un cas typique que nous rencontrons souvent : un collaborateur en déplacement signale des appels inaudibles lors d’une présentation client. Dans un processus de résolution classique, l’équipe support vérifie d’abord les indicateurs Microsoft globaux (rien d’anormal), teste la connexion et le matériel de l’utilisateur (tout fonctionne), puis finit par escalader vers le niveau 2 pour une investigation réseau plus poussée. Résultat : plus de deux heures pour découvrir, en bout de course, qu’un routeur Wi-Fi défaillant sur le site concerné était en cause. Avec la cartographie réseau par site et la timeline waterfall de l’appel, ce même diagnostic devient possible en quelques minutes : le site en anomalie et le flux dégradé apparaissent immédiatement, sans étape d’élimination.
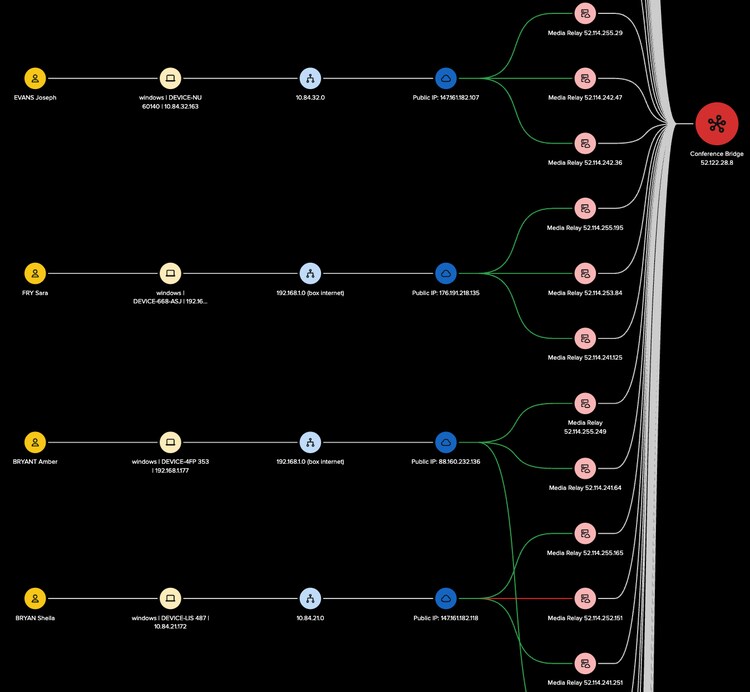
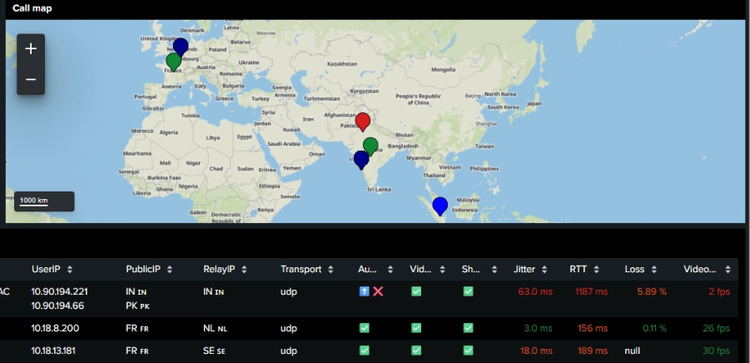
Autre cas typique : le premier appelant d’une conférence détermine la localisation du pont chez Microsoft. Si ce participant est sur une autre plaque géographique que les autres, c’est le pire cas et il y a de fortes chances pour que l’Internet global impacte tous les autres. Le geomapping des utilisateurs et des relais Microsoft donnent cet éclairage en une seule vue !
Quelles sont les prochaines évolutions prévues pour MS Teams Observability ?
Nous continuons d’étendre la couverture téléphonie de l’application — Direct Routing, PSTN, files d’attente et Auto Attendant pour les centres de contacts — avec une corrélation de bout en bout entre toutes ces sources via un identifiant de corrélation unique. Le diagnostic assisté par IA va également plus loin, avec l’objectif d’arriver à une analyse de root cause en un clic. Nous travaillons aussi sur la géolocalisation plus fine des composants d’infrastructure, et sur l’élargissement de l’application à davantage de plateformes d’observabilité, pour que chaque équipe retrouve MS Teams Observability dans l’écosystème qu’elle utilise déjà au quotidien.
Pourquoi était-il important pour Phenisys de proposer cette solution sur Splunkbase / l’écosystème observabilité ?
Notre conviction, c’est qu’une solution d’observabilité Teams doit venir se brancher là où les équipes IT travaillent déjà, plutôt que d’imposer un outil supplémentaire. La communauté Splunk compte énormément d’organisations pour qui Teams représente aujourd’hui un vrai point aveugle. En publiant MS Teams Observability sur Splunkbase, nous donnons aux Splunkers un accès natif à cette télémétrie enrichie, avec la possibilité de construire leurs propres recherches, alertes et tableaux de bord au-dessus des données collectées, en plus des vues que nous fournissons. C’est aussi, plus largement, une manière de contribuer à la richesse des cas d’usage possibles dans Splunk déjà apportés par la communauté.
Le mot de la fin : une autre application fétiche sur la Splunkbase ?
Notre application préférée sur Splunkbase est probablement un choix très « pratico-pratique », plus orienté efficacité opérationnelle que démonstration de cas d’usage spectaculaire : Splunk App for Lookup File Editing. C’est typiquement le genre d’outil que les équipes utilisent au quotidien et pour lequel tout le monde finit par se dire : « mais pourquoi ce n’est pas intégré par défaut dans Splunk ? » 😉
Pour aller plus loin :
- Téléchargez l’application MS Teams Observability
- Découvrez le Top 5 des applications incontournables de la Splunkbase
Articles similaires

Repenser l’observabilité : de l’atténuation des risques à la transformation métier

Observabilité : les grandes tendances de 2025